7
6 月
智谱一口气开源 6 款模型:200 tokens/s + z.ai 域名,国产开源模型的「降维打击」又升级了
6 月 4 日,智谱做了一件极其「大方」的事:一次性开源三大类 6 款 GLM 模型,覆盖沉思、推理、基座。推理速度 200 tokens/s 刷新国内商用纪录,价格仅为 DeepSeek-R 1 的 1/30。同时拿下顶级域名 z.ai。
6 款模型分别是什么?
- 沉思模型 GLM-Z 1-Rumination-32 B:深度思考多步推理
- 推理模型 GLM-Z 1-32 B:性能媲美 DeepSeek-R 1,200 tokens/s(比常规快 8 倍)
- 基座模型 GLM-4-Air + GLM-4-Flash:完全免费
- 同步上线极速版(200 tokens/s)、高性价比版(价格仅 R 1 1/30)、免费版三档

200 tokens/s + 1/30 价格 + z.ai 域名——国产模型竞争在发生什么变化?
1. 速度成为新战场。200 tokens/s 不是实验室数据,是商用推理速度。对实时 Agent 场景——代码补全、对话交互、工具调用——首 token 响应时间比 Benchmark 分数更直接影响用户体验。
2. 价格战从「便宜」变成了「接近免费」。DeepSeek-R 1 已经是价格标杆。智谱把价格打到它的 1/30——两个模型直接免费。
3. z.ai 是一个品牌信号。单字母 .ai 域名全球仅 26 个。智谱在告诉国际开发者社区「我们不是一家只做中国市场的公司」。
国产开源模型正在形成怎样的「四强」格局?
DeepSeek(技术标杆)、Qwen(国际声望)、MiniMax(开源全能)、智谱(品类覆盖)——每家都找到了自己的定位。从「一家独大」到「充分竞争」,最终受益的是开发者和用户。
智盒判断
短期:6 款一起开源 + 免费模型会产生开发者尝鲜潮。但品牌知名度在海外不如 MiniMax 和 Qwen,z.ai 需要时间和营销。
中期:200 tokens/s 极速版的实际生产稳定性和准确性是关键验证。如果在速度-质量均衡点上站稳,会在 Agent 实时推理场景中获得差异化优势。
FAQ
智谱的模型和 DeepSeek 比谁更强?
GLM-Z 1-32 B 性能媲美 DeepSeek-R 1。但 200 tokens/s 的速度和 1/30 价格是明确的竞争优势。
相关阅读
RELATED
Posts
15 10 月
Llama Windows 上手:Windows 11 托盘一键跑本地大模型,不用命令行
一句话结论:Llama Windows 是 Hugging Face 2026 年 10 月 13 日发布的免费开源 Windows 11 托盘应用(MIT 许可),把 llama.cpp 包装成「点图标、选模型、下载、开聊」四步,不需要终端、不需要编译、不需要管理员权限。它同时在本机提供 OpenAI 兼容接口,适合第一次在自己电脑上跑开源模型的人,也适合想给脚本接一个本地模型的开发者。 AI 摘要 资源类型:免费开源软件(Windows 11 桌面应用)来源:Hugging Face 官方博客发布,代码在 GitHub ggml-org/Llama-Windows适合人群:想在 Windows 电脑上离线跑开源模型的普通用户、需要本地 OpenAI 兼容接口的开发者使用价值:自动安装和管理 llama.cpp,一键下载推荐模型,模型缓存与其他 Hugging Face 工具共享风险边界:项目很新(GitHub 87 星,2026-10-14 核查);官方博客和 README 给出的本地端口不一致,需以本机实际为准 资源信息 资源名:Llama Windows(代码仓库内名称...
15 10 月
阿里 QwenGyre 论文解读:训练长程 Agent 快 1.78 倍,代码还没公开
一句话结论:阿里通义团队 9 月 27 日在 arXiv 发布 QwenGyre 论文,这是一套专门训练「一次要跑几个小时」的 AI Agent 的在线强化学习框架。用在 2.4 万亿参数的 Qwen 3.8 上,48 步训练让 NL2RepoBench 得分从 52.5% 升到 58.5%,耗时 75.42 小时,比 Async 方案的 134.55 小时快 1.78 倍。不过截至 2026-10-14,我们没有找到公开的代码仓库,部分报道说的「开源」目前只指论文公开。 AI 摘要 发生了什么:阿里 Token Hub 联合中国科大、清华发布 QwenGyre 论文(arXiv 2609.33848,2026-09-27),10 月...
12 10 月
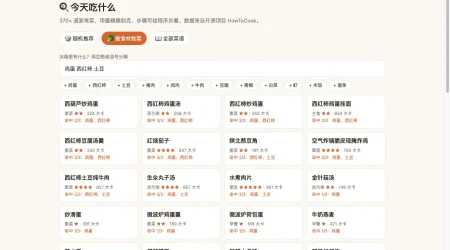
HowToCook 程序员做饭指南:10 万星开源菜谱怎么用、怎么部署、怎么接 AI
HowToCook 程序员做饭指南是 GitHub 10.2 万星的开源菜谱库,372 道家常菜用量精确到克。本文讲清在线使用、Docker 本地部署、按食材找菜工具和 MCP 接入 AI 助手的方法与风险。
9 10 月
给 AI 读图前怎么压缩?用 Squoosh 保住小字、图表和透明边缘
Squoosh 图片压缩不应只比较文件大小,AI 读图还需要保留小字、小数点和表格细线。本文提供原图与两份候选的三路对照方法,说明怎样记录像素尺寸、编码参数、十个关键字段和识别退化,并连接 aiKit 在线工具。文章不承诺压缩率或模型费用下降,也不把肉眼清晰当作 OCR 正确率证明,适合建立图片输入验收流程。
9 10 月
Sharp 图片预处理:给 AI 截图输入建立尺寸上限和独立输出
Sharp 图片预处理适合将人工选定的图片规则写进 Node.js 流程。本文包含官方安装渠道、平台要求、完整单图脚本和独立输出目录设计,说明尺寸上限、不放大小图、无损编码与缩放损失的区别。示例以静态 PNG 为起点,要求比较小字和识别退化,不覆盖原件,不保证压缩率,也不把像素限制当作完整上传安全方案。
9 10 月
Python jsonschema:给模型输出加一道可执行的数据合同
Python jsonschema 可以把模型输出的数据合同变成可执行检查。本文包含虚拟环境安装、官方包下载、完整校验脚本和四个正反样本,解释 required、额外字段、格式检查与语义真实性的区别,并说明跨平台运行和失败处理方法。适合信息提取与工具参数入口,不调用收费模型,也不把结构通过误写成业务正确或权限批准。
9 10 月
Promptfoo 上手:先用本地输出检查评测规则,再连接模型
Promptfoo 可用 Echo provider 检查变量、模板和断言,不必调用模型。本文给出独立目录安装方法、Node 版本要求、两条合成样本配置及预期通过和失败路径,说明本地报告、锁文件、外部评分和隐私风险。适合已有固定任务的开发者建立回归入口,不提供未执行的准确率成绩,也不把本地工具与免费模型额度混为一谈。
9 10 月
提示词改短以后真的更好吗?用保留集做一次回归检查
提示词回归检查要看新版修好了什么,也要看原本正确的任务有没有退步。本文以三类客服工单为例,说明调试集与保留集如何拆分、怎样冻结标签规则、记录逐条差异并处理空输出和超时。附模板、CSV 示例及人工复核门槛,帮助团队建立可追溯的上线依据与版本回退记录;样本数量是教学建议,不是实测成绩,也不承诺准确率提升。
9 10 月
Mermaid CLI:把 Agent 流程图源文件放进可重复的构建流程
Mermaid CLI 能把流程图源文本转为可构建的文档资产,适合经常随 Agent 代码变化的审批与异常流程。本文提供官方源码、项目内安装、引擎检查、完整示例和 SVG 导出命令,说明浏览器依赖、中文字体、版本锁定及 CI 隔离边界。它不是在线编辑器的重复介绍,也不把图像导出成功当成业务流程已经正确实现。
8 10 月
用 Mermaid 审查 AI Agent:把审批、失败和停止条件画清楚
用 Mermaid 审查 AI Agent,重点不是把正常流程画得漂亮,而是确认审批、超时、拒绝和停止条件。本文提供可粘贴的流程图代码及四类路径检查方法,说明幂等键、人工批准、状态查询和版本管理的边界,并连接 aiKit 在线编辑器。模板未经运行验证,不把渲染成功当作权限安全证明,也不要求上传真实客户数据。


评论 (3)
[…] 智谱开源 6 款模型:国产开源模型的「降维打击」 […]
[…] […]
[…] 智谱此前就有过「马甲」前科——今年 2 月,代号 Pony Alpha 的匿名模型上线,5 天后公布身份,确认是智谱 GLM-5。智谱也是国产大模型里开源动作最激进的一家,此前曾一口气开源 6 款模型。上次的马甲是「马」,这次是「牛」,网友调侃:「无论从分类学还是从『牛马』的隐喻来看,都很合理。」 […]
评论被关闭。