一句话结论:Fortune 报道 OpenAI 在 GPT-6 Astra 发布后多次改动评测数据——幻觉率、ARC-AGI-3、竞争对手 Claude 的成绩都被动过,这暴露了「厂商自报跑分」在缺乏第三方验证时的信任危机。
据 Fortune 报道,OpenAI 自 9 月 3 日发布 GPT-6 Astra 公告以来,多次修改其中的评测基准数据。事件的时间线本身就反常:OpenAI 原定美东时间下午 2 点发博客,结果文章被撤下又重发,近两个小时后大多数用户才能正常访问。
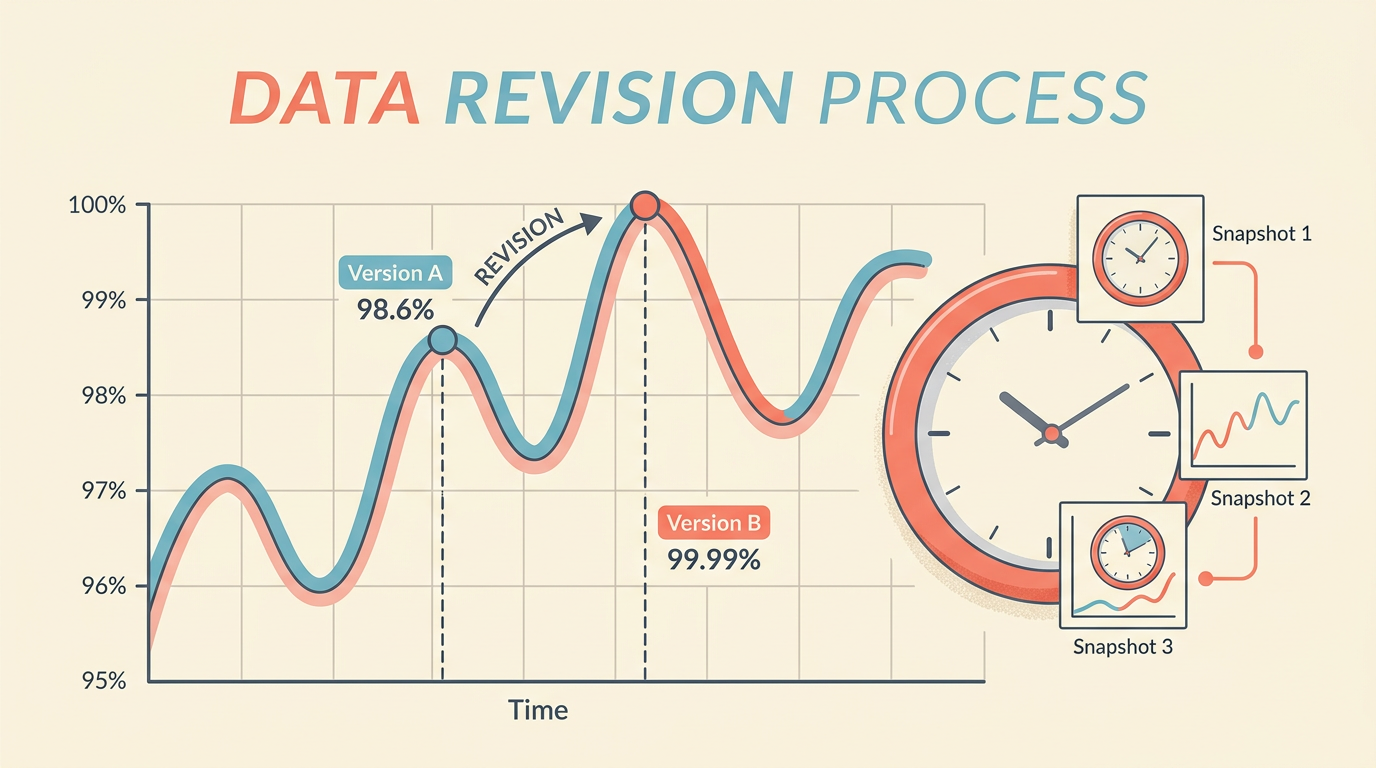
更关键的是,网页快照显示数据在反复变动。以幻觉率为例:Astra 的幻觉率在首版里是 4.2%,下午 5 点 20 分的快照里降到了 2%(几乎减半),前代 GPT-5.6 Sol 也从 12.2% 降到 9.4%;但截至 Fortune 发稿,两个数字又回到了最初的 4.2% 和 12.2%。
OpenAI 发言人的解释是:不同模型检查点、测试框架和评测运行方式会导致几个百分点的波动,修改是为了「让数字代表模型可用性能的最佳估计」。但数据变动的方向,恰好多次让 Astra 显得更突出,这就很难用「误差」一笔带过了。
最受关注的是 ARC-AGI-3 抽象推理基准。OpenAI 向媒体提供的预发布草稿里,Astra 的成绩是 98.6%;等正式博客上线,这个数字变成了 99.99%。而基准测试的创建方 Arc Prize Foundation 指出,OpenAI 为 Astra 配备了一套「特别强大的测试工具框架」才拿到接近满分的成绩;用该基准的标准工具框架时,Astra 的成绩是 63%。
这个区分很重要:99.99% 是「加装了额外工具」的上限成绩,63% 才是标准条件下的基线。两者都对,但指向的结论完全不同。
另一个引发争议的操作是:Anthropic 最新模型 Fable 5.1 在 FrontierMath Tier 4 数学基准上的成绩,一度从首版快照的 87.8% 被调低近 10 个百分点到 78%,后来又回升到 83%。GPT-5.6 Sol 的成绩也经历了 83%→80.5%→83% 的反复。这些「先降后升」的调整,恰好让 Astra 的领先优势在某个时间点上被放大。
对开发者:厂商自报跑分从来都是「营销的一部分」,但这次事件把「跑分可以被精细操控」这件事摆到了台面上。选型时只看厂商数据,等于把判断权交给了最想让你买账的那一方。这与我们之前梳理的 GPT-6 Astra 发布 里「99.9% 需要打折看」的判断形成了呼应——当时就有第三方数据(Artificial Analysis、Vellum)指出标准测试成绩远低于官宣。
对行业:基准测试的「刷分」问题不是新话题,Meta 前首席 AI 科学家 Yann LeCun 也承认过公司曾美化基准结果。但 Astra 这次的特殊之处在于,它发生在「AGI 时代」这个宏大声量之下——当一个模型被包装成划时代的节点,跑分的小数点后两位就不再是技术细节,而是舆论武器。
对读者:这件事提供了一个判断标准:一个模型的真实能力,应该看「第三方独立复现」而不是「厂商自报」。正如我们之前分析 Astra 触及 Critical 红线 时反复强调的,OpenAI 的很多数据缺乏可复现的验证路径。
短期:这次事件不会改变 Astra 本身的技术实力——它在计算机操作、网络安全上的提升是实打实的。但它会削弱 OpenAI 在「跑分公信力」上的信用,至少在下一轮发布前,媒体和第三方会用更挑剔的眼光审视它的每一个数字。
中期:这件事可能倒逼行业建立更严格的基准披露规范——比如要求厂商同时公布「标准测试框架成绩」和「加装工具的成绩」,以及测试使用的模型检查点版本。Arc Prize Foundation 已经公开了 63% 这个「标准版」数字,这是一个好的开始。
长期:当「AGI」这种宏大叙事和「跑分操控」这种细节问题同时出现时,真正成熟的判断是回到第一性原理:不看它宣称自己是什么,看它在你的真实任务上表现如何。数字会撒谎,任务不会。
目前没有证据证明是「故意作弊」。Fortune 报道的是「数据被多次修改」这个事实,OpenAI 的解释是「误差波动」。但数据变动的方向多次让 Astra 显得更强,这是不争的事实。更准确的表述是:这件事暴露了厂商自报跑分缺乏第三方验证时的信任风险,而非坐实了「作弊」。
要区分看。99.99% 是「为 Astra 配备特别强大测试工具框架」后的成绩;用标准工具框架时是 63%。两个数字都真实,但引用时必须说明条件。这也是为什么看跑分一定要看测试条件。
优先信第三方独立评测(Artificial Analysis、Arc Prize Foundation、LMArena 等),其次看厂商数据时带上「测试条件」的限定。最靠谱的永远是拿自己的真实任务去测,而不是看任何一方的跑分。