

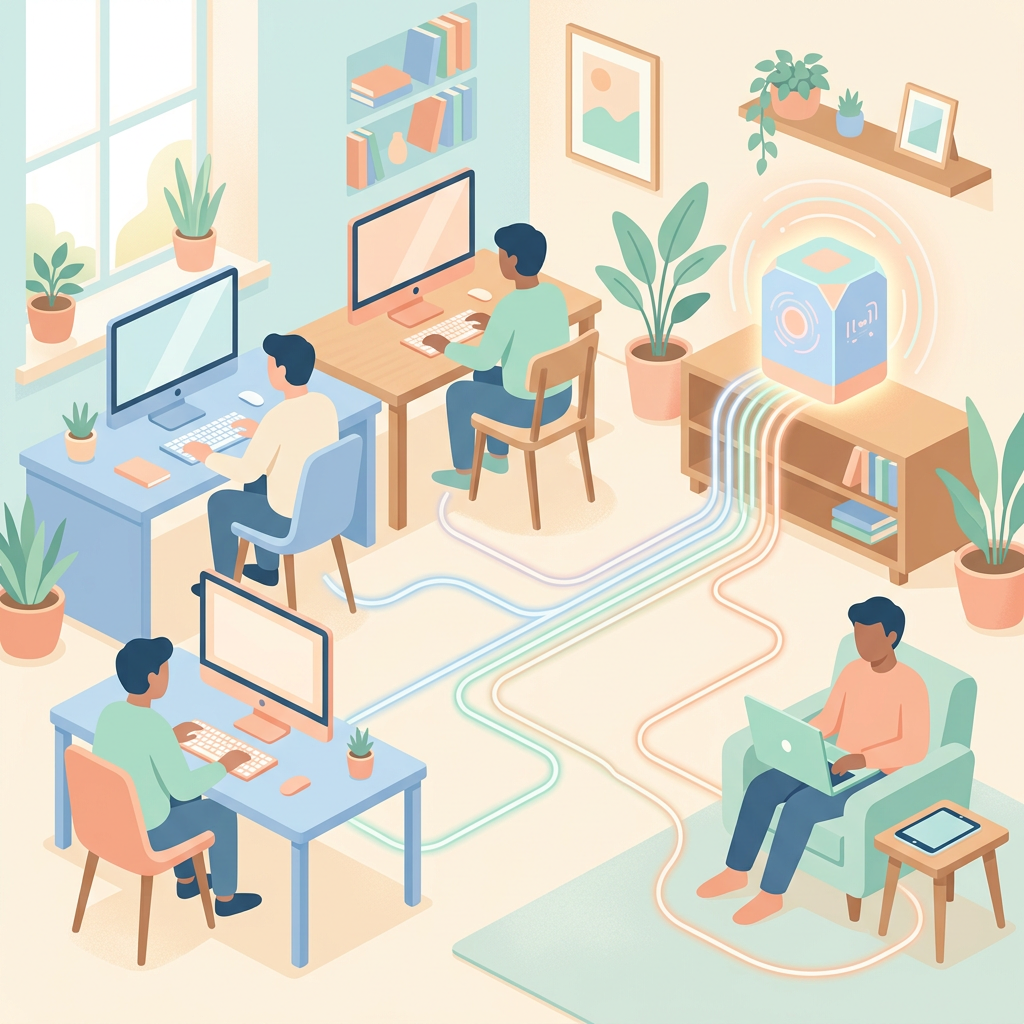
一句话结论:NVIDIA 免费开源了 PAIR(Personal AI Router),能自动把局域网里多台电脑的空闲算力拼成一个「本地推理池」,官方实测把五智能体任务从 18 分钟压缩到 8 分 48 秒,对想在家跑本地大模型、又嫌单卡太慢的人是个实打实的利好。
PAIR 全称 Personal AI Router,是一个免费开源的本地调度软件。它做的事很具体:自动发现同一局域网里装了 AI 推理服务(Ollama、LM Studio)的电脑,然后把每个独立的推理请求,路由到当前最有空闲算力的那台机器上。它不像分布式训练那样把多块 GPU「焊」成一块大加速器,而是更像一个轻量级的任务调度器——每台设备还是各跑各的,只是谁的显卡闲着,谁就接活。官方仓库 NVIDIA/Personal-AI-Router 上线几天已经拿到 900 多 star。
本地跑大模型有个尴尬:Agent 工作流喜欢把复杂任务拆成若干并行子任务,但家用电脑往往只有一张显卡,所有子请求抢同一块卡,性能反而掉下来。这正是 PAIR 瞄准的问题。你在单台 RTX Spark 笔记本上跑 Qwen 3.6-35 B 模拟收件箱分类,平均要 18 分钟;同样的任务摊到三台设备上(笔记本 + DGX Spark + RTX 5090 台式),8 分 48 秒就完事。对隐私敏感、不想把数据送上云的场景,这种「多台家用机凑出接近小服务器」的思路,恰好卡在本地与云端之间的空白。
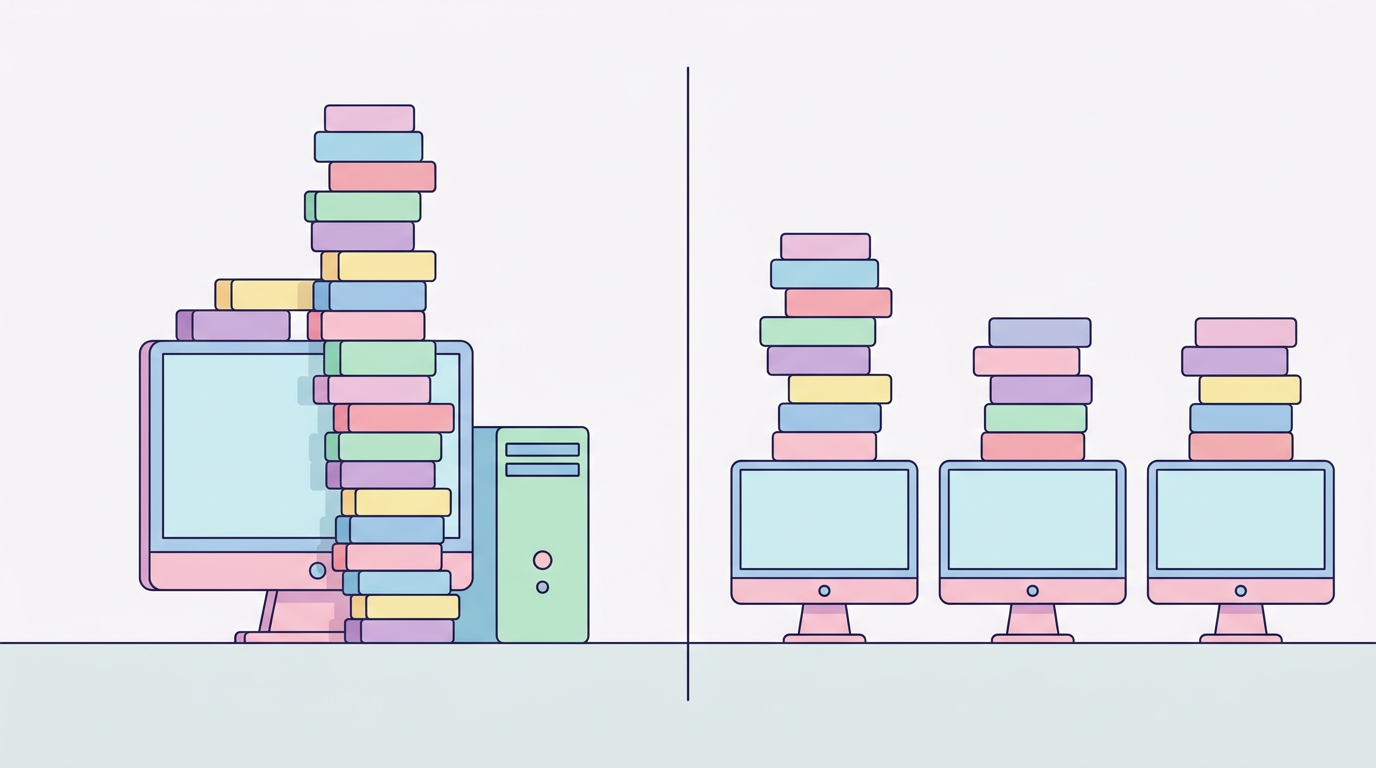
这组数字来自 NVIDIA 自己的 benchmark,属于厂商自测,需要打个折扣看。但方向是明确的:并行子任务越多、设备越多,收益越明显。软件层面的配套也在跟上——llama.cpp 后端在 RTX 5090 上做到最高 1.9 倍吞吐(靠 kernel 优化、投机解码和更快的 prefill),vLLM 在 RTX PRO 6000 Blackwell 上 1.2 倍,双 DGX Spark 集群最高 1.4 倍。PAIR 的价值不只在「组网」,还叠加了推理引擎层面的提速。对想在家跑本地大模型的玩家,可以参考我们之前拆解的 slotstream 如何在 48 GB Mac 上跑 105 GB 的 Qwen,本地推理的瓶颈和解法其实是一体的。
门槛比想象低。PAIR beta 支持 Windows、macOS、Linux 三平台,GPU 兼容 GeForce RTX 20 系列及以上、RTX PRO 工作站卡、DGX Spark,还支持 Apple M 4 芯片。想搞懂这些本地 Agent 底层的 harness 机制,可参考 learn-claude-code 17 章课程解读。哪怕你手头是几台不同年代、不同系统的旧机器,只要装了 Ollama 或 LM Studio,就能被 PAIR 拉进同一个推理池。NVIDIA 还宣布 Hermes Agent、OpenClaw、Perplexity Portable Computer 将内置简化版 PAIR 支持,等于把「多设备组网」下沉成这些本地 Agent 的默认能力。
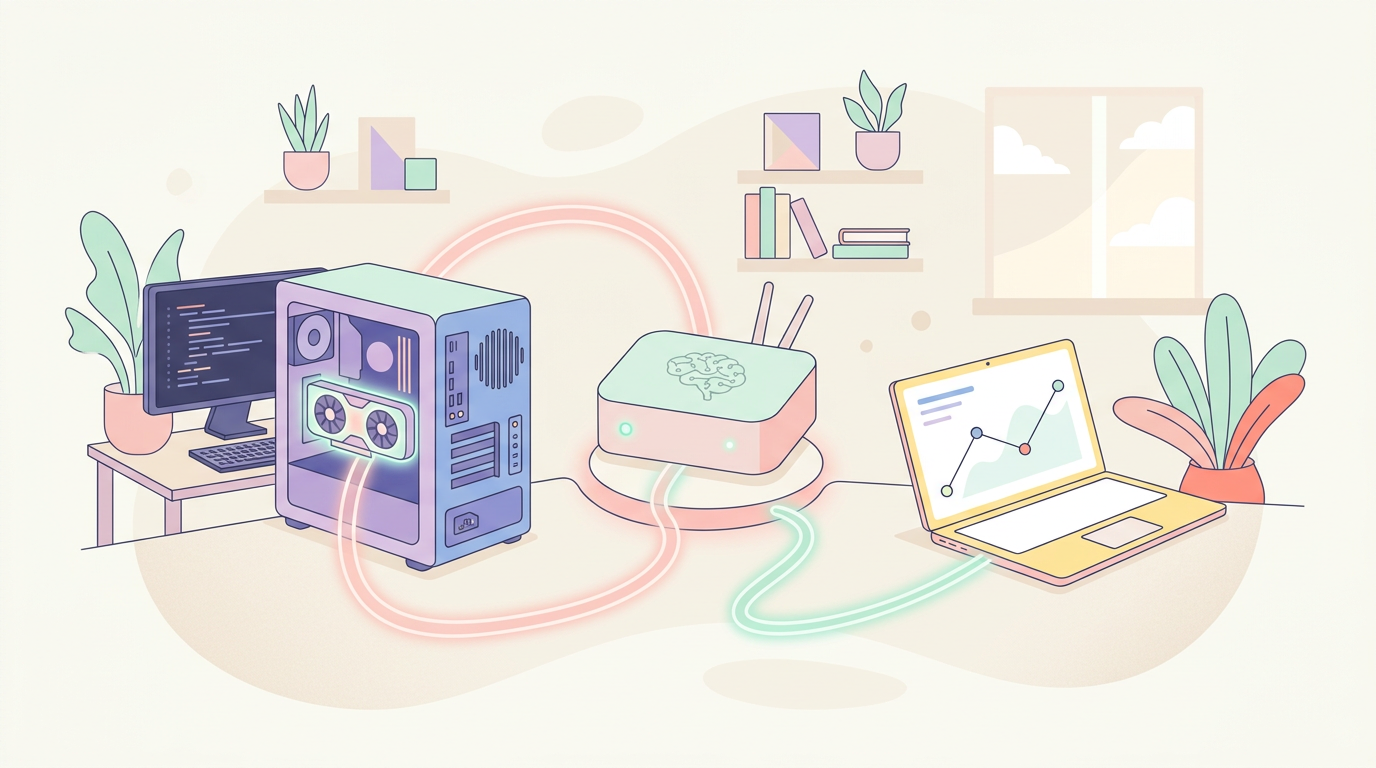
理解 PAIR 的定位,能帮你判断它到底适不适合自己。分布式训练/推理(tensor parallelism)是把一个超大模型切块,分到多块 GPU 上协同算,对带宽和硬件一致性要求极高,家庭网络根本吃不消。PAIR 走的是相反的路:它不切模型,只切「请求」——每台设备完整跑自己的推理,调度器负责把独立请求分给空闲设备。优点是家庭千兆网也能用、设备可随时加入退出;缺点是对「单个超大模型」帮不上忙,你必须能在一台设备上装得下这个模型。这个区别,也是它和云上「多卡集群」不一样的地方。
短期看,PAIR 让「家里多台电脑」第一次有了被 AI 复用的理由——尤其适合有两三台设备、又想跑中等规模开源模型的人。中期变量是 RTX Spark 整机:IFA 2026 上 NVIDIA 确认,搭载 20 核 Grace CPU + RTX Blackwell GPU、最高 128 GB 统一内存的 RTX Spark Windows PC 几周内上市,ASUS、Dell、HP、Lenovo 等厂商都会出。如果这类「AI 整机」普及,PAIR 的组网价值会被进一步放大。而本地 AI 这条线,与云端大模型(比如刚全量上线的 GPT-6 Astra 所代表的「云端超大算力」路线)并非对立,而是互补——一个赢在隐私和长期成本,一个赢在峰值能力。
PAIR 是本地 AI 基础设施里一块小而实的好补丁。它没有吹「重新定义」,就是老老实实解决「单卡并行子任务抢资源」的工程问题,开源、免费、跨平台、门槛低。对开发者,如果你的工作流已经绕不开本地模型,PAIR 值得花一个下午试一下;但对只用云端 API 的人,它暂时没什么吸引力。
是。NVIDIA/Personal-AI-Router 已开源,beta 阶段免费,支持 Windows、macOS、Linux 三平台。
最少一台也能跑(可先体验调度逻辑),但要看到明显提速,需要 2 台及以上都装了 Ollama 或 LM Studio 的设备。
PAIR 本身不切模型,模型必须能装进单台设备的显存。它的价值是把「多个独立推理请求」分摊到多台设备,而不是让单台设备跑更大的模型。
数据不离开家,隐私更好,长期成本可能更低;缺点是峰值算力远不如云端集群,也跑不动真正的大模型。

评论 (1)
[…] Windows 11),以及需要多卡、多机部署的团队。后者可以看看 NVIDIA 开源的 PAIR,它能把多台电脑拼成一台本地 AI […]
评论被关闭。