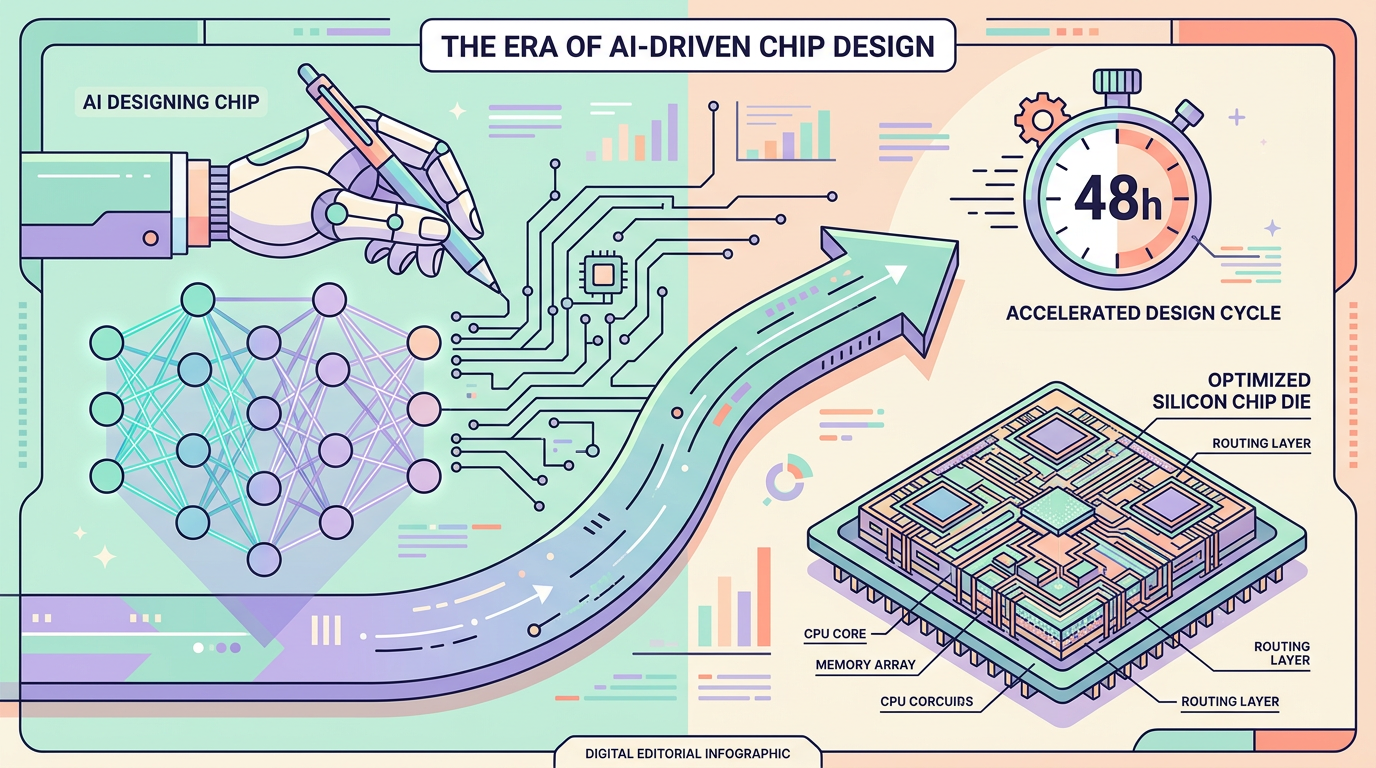
一句话结论:Moonshot AI 开源了 nano-kpu——一颗完全由 Kimi K 3 设计、用开源 EDA 工具跑通全流程的推理芯片 RTL,48 小时完成设计,4 平方毫米、100 MHz、模拟 8700 tokens/s。但它明确声明是「能力演示」,不是产品。
严格说,nano-kpu 不解决任何生产问题。它回答的是一个更根本的问题:一个 AI 模型,能不能在没有人干预的情况下,独立完成一颗芯片的设计全流程。
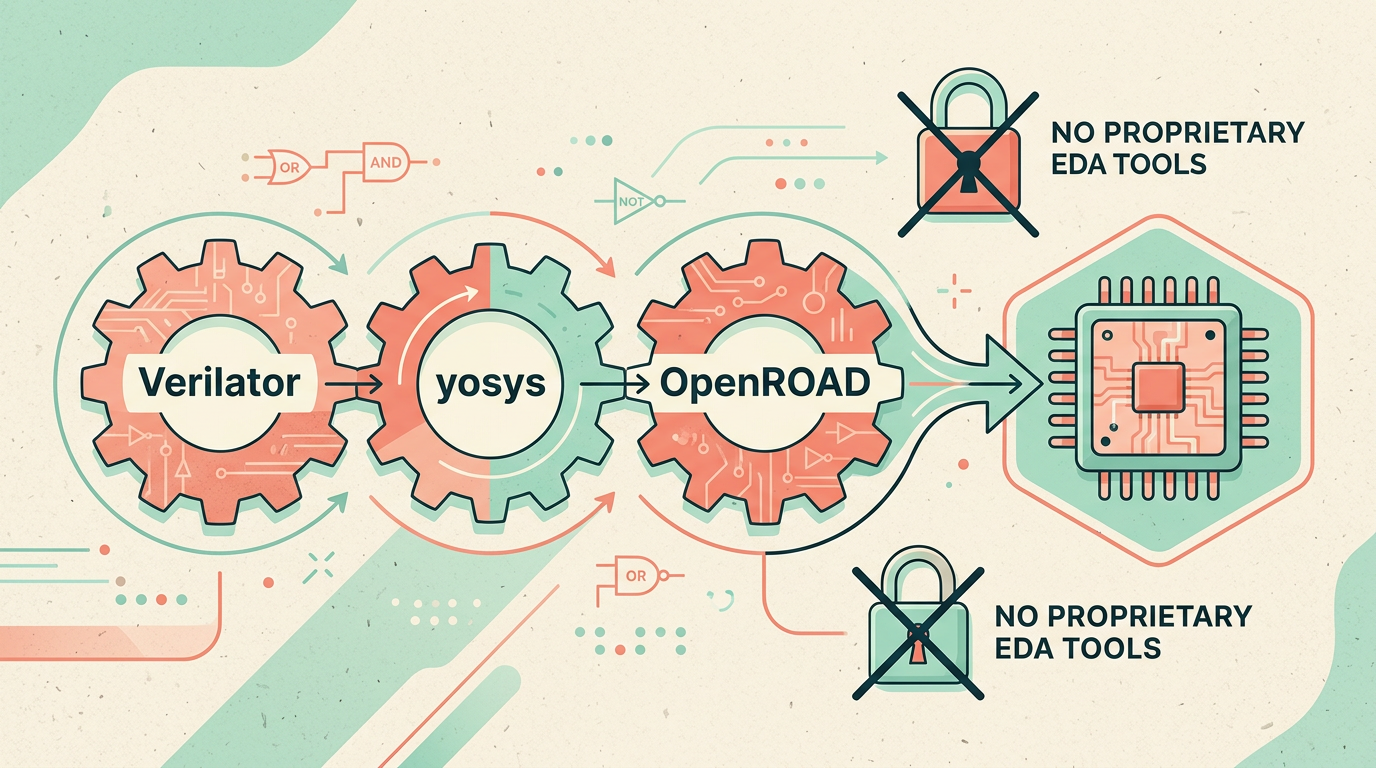
答案在 Moonshot AI 的开源仓库里。nano-kpu 是一颗 nano 级混合架构推理芯片的 RTL 设计,从架构、RTL 编码、优化、验证到时序收敛、仿真,全部由 Kimi K 3 完成。使用的工具链是纯开源的:Verilator 5 做仿真、yosys 做综合、Nangate 45 单元库(从 OpenROAD 拉取,SHA-256 锁定)。
关键数字来自第三方报告的分析:这颗芯片在 48 小时的单次自主运行里完成设计,4 平方毫米、13 个模块、146 万标准单元、0.277 MB SRAM,时序在 100 MHz 收敛,模拟解码吞吐 8721 tokens/s。
nano-kpu 的架构不是随便堆的,它复刻了 Kimi K 3 自己的技术栈。
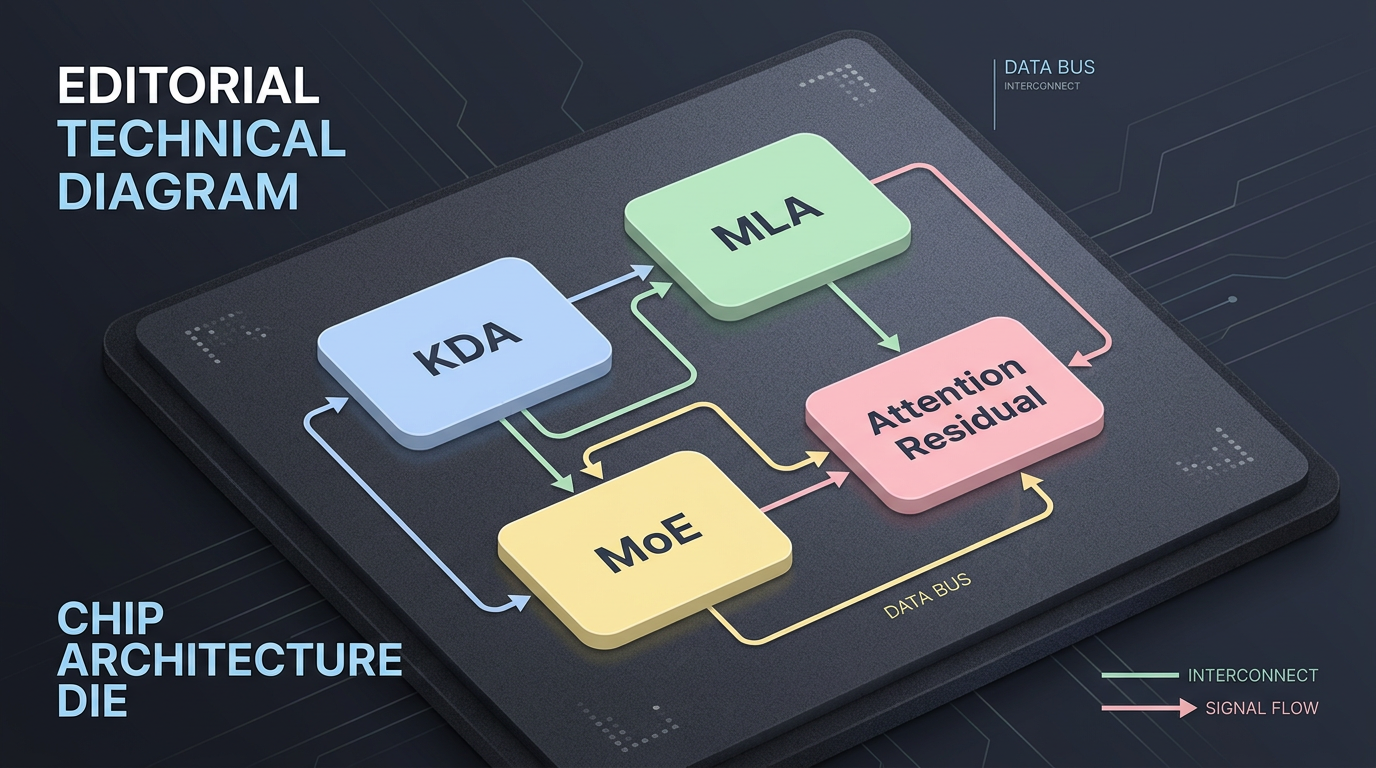
核心是混合注意力 MoE Transformer:KDA(Kimi Delta Attention)线性注意力、NoPE 多头潜在注意力(MLA,全程无位置编码)、sigmoid 路由的 MoE(top-2 路由专家加一个共享专家),以及注意力残差混合。权重用 int 4 group-128 量化,约 23.8 万参数、135.5 KB。
这个组合的妙处在于,它把 K 3 论文里验证过的架构,压缩到了一颗「教学级别」的芯片里。KDA 负责低成本的线性注意力,MLA 负责压缩 KV,sigmoid MoE 负责稀疏激活——三者合起来,就是一颗针对「自己这套架构」定制的推理加速器。
这个边界必须划清楚,Moonshot 自己也在仓库里写了免责声明。
首先,芯片没有真正流片。时序收敛和模拟吞吐都是设计阶段的产物,不是物理芯片。其次,100 MHz 的 45 nm 教学单元库,距离前沿 AI 加速器所在的 3 nm、2 nm 工艺隔了好几代。用报告里的话说,这个规模大概相当于一个研究生项目的野心。
更重要的是,这背后有一个「自报家门」的问题。芯片的数字是 Moonshot 自己报的,权重还没公开,独立复现有限。之前也出现过 K 3 在事实性问题上幻觉率偏高的情况,所以对这些数字应该保持审慎。
这和我们之前写 OpenAI 辣椒芯片时的口径一致:流片前的设计阶段成果,价值在信号,不在硅片。
nano-kpu 的价值,不在芯片本身,而在它证明了什么。
它证明了 AI 自主工程能走多远。从架构设计到 RTL 编码到验证到时序收敛,全流程无人工干预,这在两年前是不可想象的。它也证明了一件事:开源 EDA 工具链(OpenROAD、yosys、Verilator)已经成熟到能支撑一个完整的芯片设计 demo,而这些工具的诞生本身就有美国政府资金的支持,目的是降低成熟节点小设计的门槛。
放到国产大模型的语境里,这个意义更具体。DeepSeek V 4.1-Flash 前天刚展示了架构创新的效率,nano-kpu 则展示了另一条路——AI 不只是在写代码、刷基准,它开始介入芯片这个更底层的环节了。关于国产模型在开源上的整体动作,我们在 8 月 GitHub 开源盘点里也梳理过,nano-kpu 只是这条线最新的一个信号。
不能。它没有流片,只有 RTL 源码和仿真流程。你可以用它跑功能仿真、时序综合来学习芯片设计,但拿不到物理芯片。
部分意义上。它证明了 AI 能在开源工具链上完成一颗教学级芯片的设计全流程。但这是「能跑通 demo」和「能设计 3 nm 量产芯片」之间的巨大鸿沟,后者的工艺、IP、流片成本都是另一回事。
两者都是「流片前」的成果,但方向相反。OpenAI 辣椒芯片是自研芯片要真正量产商用,nano-kpu 是 Moonshot 用 K 3 的能力做个演示。一个追求落地,一个追求证明能力,别混为一谈。