一句话结论:上海人工智能实验室与上海交大 LUMIA Lab 在 9 月 14 日开源了 NCP-ArchPreview,一个约 89 亿参数的潜空间语言模型。它同时训练「预测下一个词」和「预测下一个概念」两个目标,在约 51.3% 的 token 上用更小的算力追平了 7 B 基线的效果,是目前公开的最大规模潜空间模型实验。
先讲一个很容易被忽略的差异:主流大模型(GPT、Claude、Gemini)都是「词元预测」模型,也就是每次预测下一个 token(词元)。token 是文字的最小切割单元,可能是半个词、一个词、一个标点。
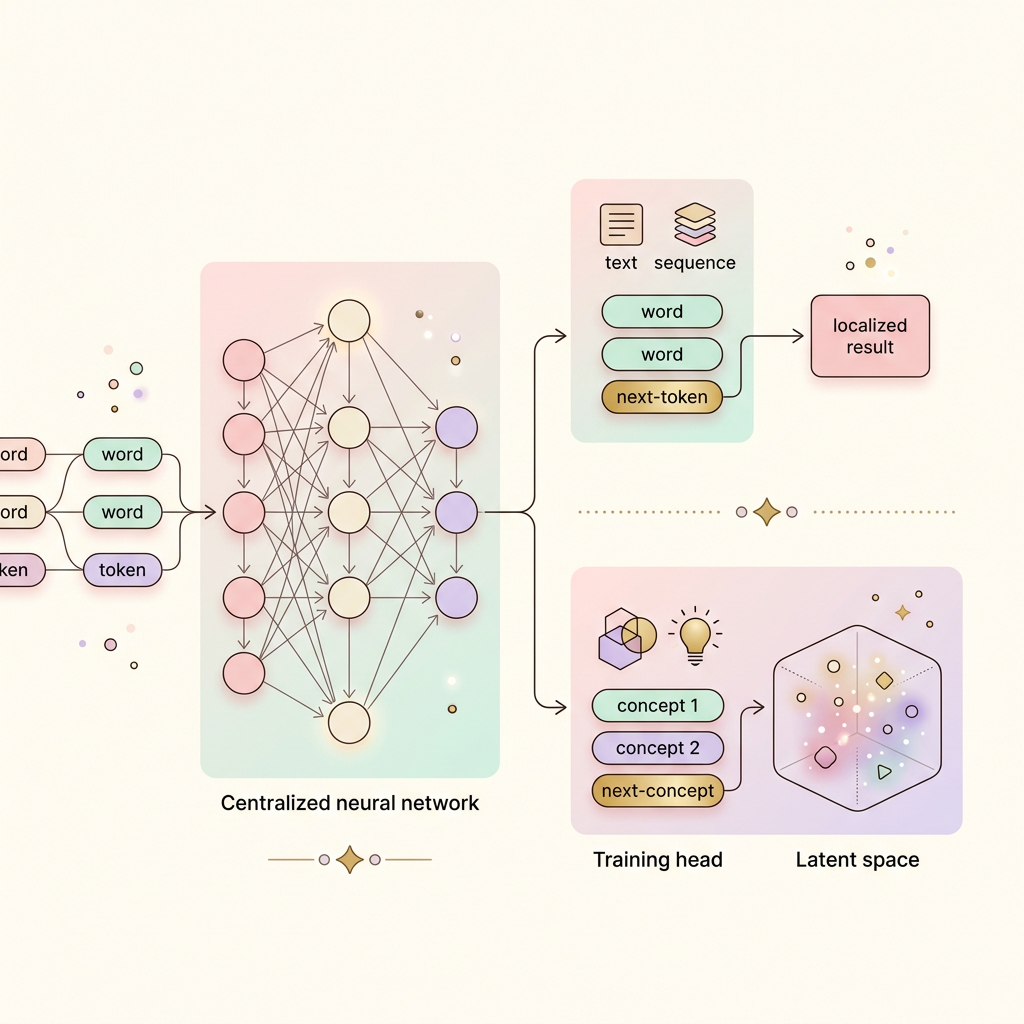
潜空间模型换了一个层次。它不直接预测下一个 token,而是先在潜空间(latent space)里预测「下一个概念」,再把概念解码成文字。概念比词更抽象、更少冗余——比如「猫」和「一只正在睡觉的猫」在概念层可能只对应一个节点,但在 token 层要拆成好几个词。
这个方向不是新想法,Meta 之前提过 Large Concept Model(LCM),但一直没在足够大的规模上跑通。NCP-ArchPreview 的意义就在于,它是目前公开的、规模最大的潜空间模型实验——在 multi-trillion-token 量级上训练。
NCP 这个缩写就是 Next Concept Prediction(下一个概念预测)的缩写。NCP-ArchPreview 的做法是联合训练两个目标:标准的 next-token prediction,加上 next-concept prediction。
报告的结论很具体:这个 8.9 B 的模型,在约 51.3% 的 token 上匹配了 7 B baseline 的 loss。换句话说,它没有在所有位置都赢,但在超过一半的位置上,用比 7 B 大一点的参数量,达到了相当的效果。潜空间模型的理论优势——减少 token 层的冗余——在这里第一次得到了大规模实验的初步验证。
对开发者来说,这个方向的价值在于效率。如果模型能在「概念」层而非「词」层思考,同样的算力可以处理更长的上下文、更少的 token 开销。这跟 context-mode 把上下文膨胀砍掉 98% 想解决的问题是同一类:token 本身是有成本的,少用 token 就是省钱。
这个项目有两个署名方:上海人工智能实验室的 NCP 团队,以及上海交大的 LUMIA Lab。上海 AI Lab 在开源模型上一直是国产阵营的主力之一,InternLM(书生)系列就出自这个体系。
开源程度方面,这次放出的是比较完整的包:技术报告在 arXiv(编号 2609.10715),权重挂在 Hugging Face 的 ArchSpace-Collection 下,评估和推理代码也一并公开,推理走 InternLM 工具链,评估走 LUMIA 的评估仓库。
不过要划清边界。名字里的「ArchPreview」已经说明了它的定位——这是架构预览版,不是稳定版本。它展示的是「潜空间模型能在多万亿 token 规模训练」这件事成立,而不是「现在就能拿来替换生产模型」。这也是国产开源近期的常见节奏,先放预览版验证技术路线,再迭代成熟版本。可以对照 智谱开源 GLM-5.3-Flash 那次的做法,同样是先把路线图走实。
如果你是做模型训练或架构研究的,NCP-ArchPreview 值得跟进,因为它是目前潜空间模型方向最完整的公开参照物——权重、数据、代码都有,可以复现也可以基于它继续做。
如果你只是找能用的模型,那先别急着上。ArchPreview 阶段没有对齐、没有产品化,跑起来需要自己搭 InternLM 推理环境,门槛不低。真想跑本地模型,slotstream 那套在 Mac 上跑 Qwen 的思路 可能更实际。
一句话:这是一个「研究型资源」,不是「上手型工具」。看的是方向,不是今天能干啥。
短期看,NCP-ArchPreview 最重要的信号是「潜空间路线还没死」。过去两年 token 模型一家独大,LCM 这类概念模型的声音很弱,这次上海 AI Lab 用 8.9 B 的规模把它拉回了牌桌。哪怕只有一半 token 追平 baseline,也说明这条路值得继续走。
中期看,如果潜空间模型能在更大的规模上复现这个效率优势,它最可能先落地的场景是长上下文和低延迟推理——因为概念层的 token 开销天然更低。这跟当下 Agent 对长上下文、低成本的刚需正好对得上。
长期看,这背后是国产开源正在从「追参数」转向「追架构创新」。过去大家盯着谁的参数量大,现在开始有人去碰 token 模型之外的第二条技术路线。这个转向本身,比单篇论文的分数更有看头。
不能。NCP-ArchPreview 是研究预览版,没有对齐和产品化,需要自己搭 InternLM 推理环境才能跑。它适合做架构研究,不适合直接当生产模型用。
谈不上。它在约 51.3% 的 token 上匹配了 7 B baseline 的 loss,是一个架构验证,不是跟 GPT-6、Claude 这类闭源前沿模型的正面比较。把它理解成「潜空间路线的大规模可行性验证」更准确。
NCP-ArchPreview 出自上海 AI Lab 和交大,是国产开源阵营在「非 token 模型」方向的一次尝试。它延续了国产模型近期「先放预览版验证路线」的节奏,技术栈也接入了 InternLM 生态。