一句话结论:9 月 15 日,Salesforce 在 Dreamforce 大会上发布 Koa,这是它第一款推理大模型——基于英伟达开源权重的 Nemotron 模型,用合成数据做后训练,专门优化销售、营销、客服这三类 CRM 任务。Salesforce 声称 Koa 在 CRM 基准上的错误率比领先模型降低了三倍,目标是让企业 Agent 不用再被转发给 Claude 或 ChatGPT 处理。
先讲清楚 Koa 的定位。它不是 Salesforce 从零训的一个通用大模型,而是一次「拿来主义 + 深度定制」的工程实践。
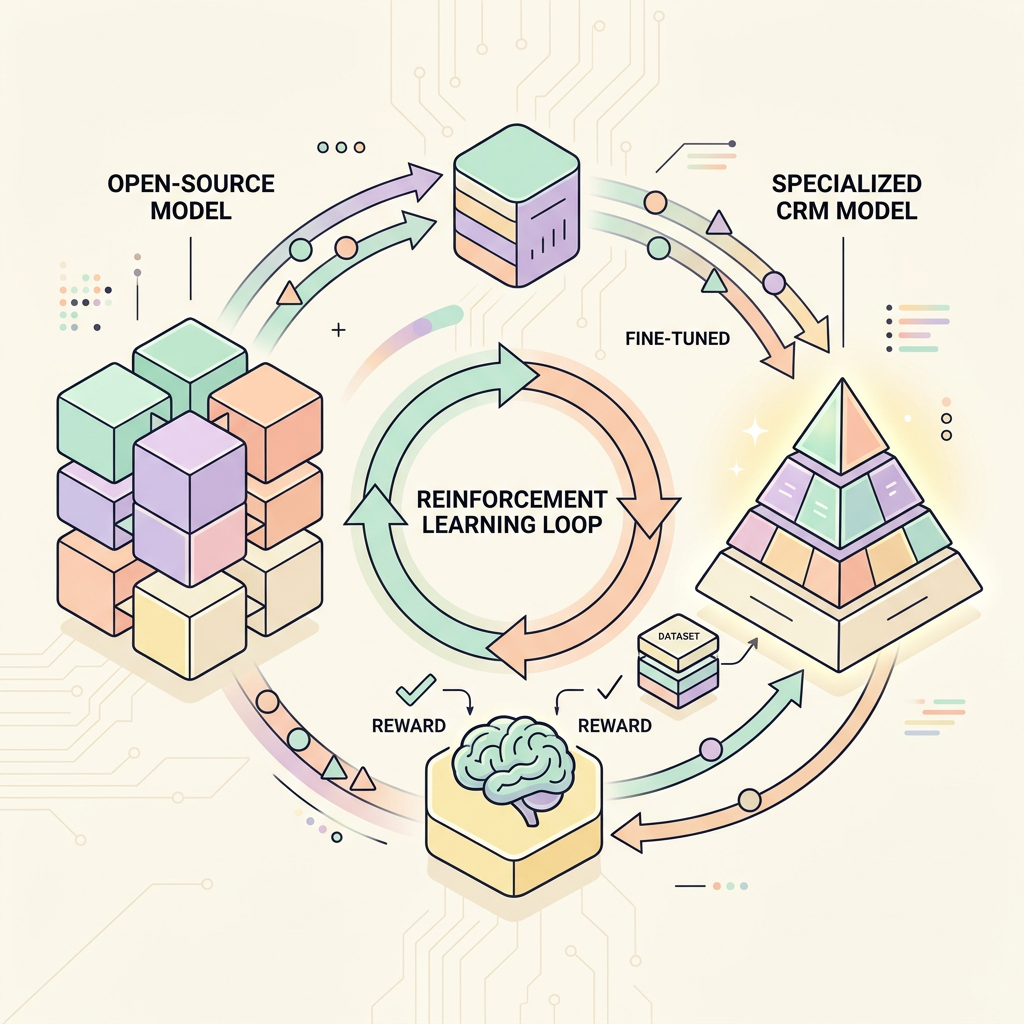
基座是英伟达开源权重的 Nemotron 模型。Salesforce 和英伟达联合做了后续微调,用监督微调加上基于 GRPO 的强化学习,让它专攻销售、营销、客服这三类 CRM 任务。论文里写得很清楚,训练数据是「公开数据 + 合成数据」,没有用任何客户数据。
为什么做这件事,Salesforce CEO Marc Benioff 的一句话点破了动机:「Salesforce 构建的最有价值的东西不是平台,而是企业业务实际运作方式的累计知识。通过 Koa,这些知识被嵌进了模型本身。」翻译过来就是,通用大模型不懂你的销售流程,但一个用 CRM 知识喂出来的模型可以懂。
Koa 问世之前,Salesforce 的 Agentforce 平台有一个很尴尬的环节:当 AI 智能体需要做长流程、多步骤的推理任务时,对应的请求会被 AI 网关转发给 Claude 或 ChatGPT 这类第三方前沿大模型。
这意味着两件事。一是成本,通用大模型的 token 消耗不便宜;二是控制权,企业的业务数据要经过第三方模型。
Koa 想把这部分任务收回自己手里。Salesforce 的说法是,Koa 更擅长 Salesforce 客户的业务工作,而且在 token 消耗上更省钱。它面向的是「复杂的多步骤工作流」——不是简单问答,而是让 Agent 知道下一步该调用哪个工具、按什么顺序完成任务。
这里有一个和 Nemotron IMO 金牌配方 相通的技术点:都是用英伟达的 NeMo RL、NeMo Gym 这些工具链做强化学习后训练。区别在于,Nemotron IMO 优化的是数学推理,Koa 优化的是 CRM 操作。
Salesforce 给了一个具体的数字:在 CRM 基准测试里,一套包括更新商机、分配案例、安排后续等真实任务的评估显示,Koa 在 CRM 操作上的表现与领先模型持平或超出,并且错误率降低了三倍。
这个数字要划一下边界。第一,「领先模型」是泛指的,Salesforce 没有点名是哪家;第二,论文里的完整结论是「超越强大的专有基线,但仍低于最先进的前沿模型」——也就是说,在多轮工具使用这个细分场景上 Koa 表现突出,但整体能力还追不上最强的那批。
论文有一个独特的设计值得一提:一个「从模拟到奖励」的流水线。它把工作流规范转化成基于角色的多轮任务,奖励和「成功用工具完成数据依赖请求」绑定。这个思路把企业 Agent 的训练从「让它答对」推进到「让它办成事」。
Koa 最值得关注的不是模型本身,而是它代表的一条路线:开源基座 + 企业专有数据 + 强化学习后训练 = 行业专用推理模型。
过去一年,企业做 AI Agent 的主流方式是「接通用大模型的 API」。这有几个老问题——数据要过第三方、成本不可控、通用模型不懂行业黑话。Koa 这条路线给了一个可复制的模板:拿一个开源基座(这里是 Nemotron),用行业数据微调,得到专属于自己的推理模型。
这和 open-connector 把 1000+ SaaS 连进 AI Agent 想解决的是同一个企业 Agent 落地问题,只是角度不同:open-connector 解决「怎么连」,Koa 解决「连上之后谁来推理」。
Salesforce 同时也没放弃和 Anthropic、OpenAI 的合作,刚宣布了 ClaudeForce 项目,让企业用 Claude 做前端、数据留在 Salesforce 系统里。这说明它不是要取代第三方模型,而是要在「通用」和「专用」之间找到分层。
短期看,Koa 的意义是「验证路线」。它证明了一家 SaaS 公司可以用开源基座 + 合成数据,训出一个在自己垂直领域里比通用模型更便宜、更懂行的推理模型。这个验证一旦成立,后面会有更多行业软件公司跟进。
中期看,真正的竞争点是「数据壁垒」。Benioff 反复强调 Salesforce 有近三十年的 CRM 部署知识,这些沉淀是纯技术公司拿不到的。如果行业专用模型成为趋势,谁手里有高质量行业数据,谁就有议价权——这比谁的通用模型强更重要。
长期看,这可能是企业 AI 从「接 API」走向「自建模型」的转折信号之一。不是每家公司都要自己训模型,但头部行业软件公司大概率会走 Koa 这条路。对开发者来说,值得留意的是:开源基座(如 Nemotron)正在成为企业 AI 的「原材料」,这本身就是开源生态价值的兑现。
不完全是。Koa 专攻 CRM 推理任务,Salesforce 同时还在和 Anthropic、OpenAI 合作(ClaudeForce 项目)。它更像是在「通用大模型」和「行业专用模型」之间做分层,而不是要取代谁。
目前只对部分试点客户开放,预计 2026 年冬季在美国地区正式发布。普通用户现在还接触不到。
闭源。基座 Nemotron 是英伟达开源权重的模型,但 Koa 本身是 Salesforce 后训练的专有模型,不开放权重。这跟 Nemotron IMO 不一样,后者是完整开源配方。