一句话结论:9 月 18 日,蚂蚁百灵(inclusionAI)在 Hugging Face 上开源了 Realtime-Venus,一个 Apache-2.0 协议的全双工音视频交互系统。它包含两个 9 B 参数检查点——Omni 版能持续「看」和「听」并主动判断何时回应,Audio 版专注音频对话。核心能力是让 AI 从「你问我答」的回合制,走向「持续感知、可被打断、能主动开口」的实时在场。
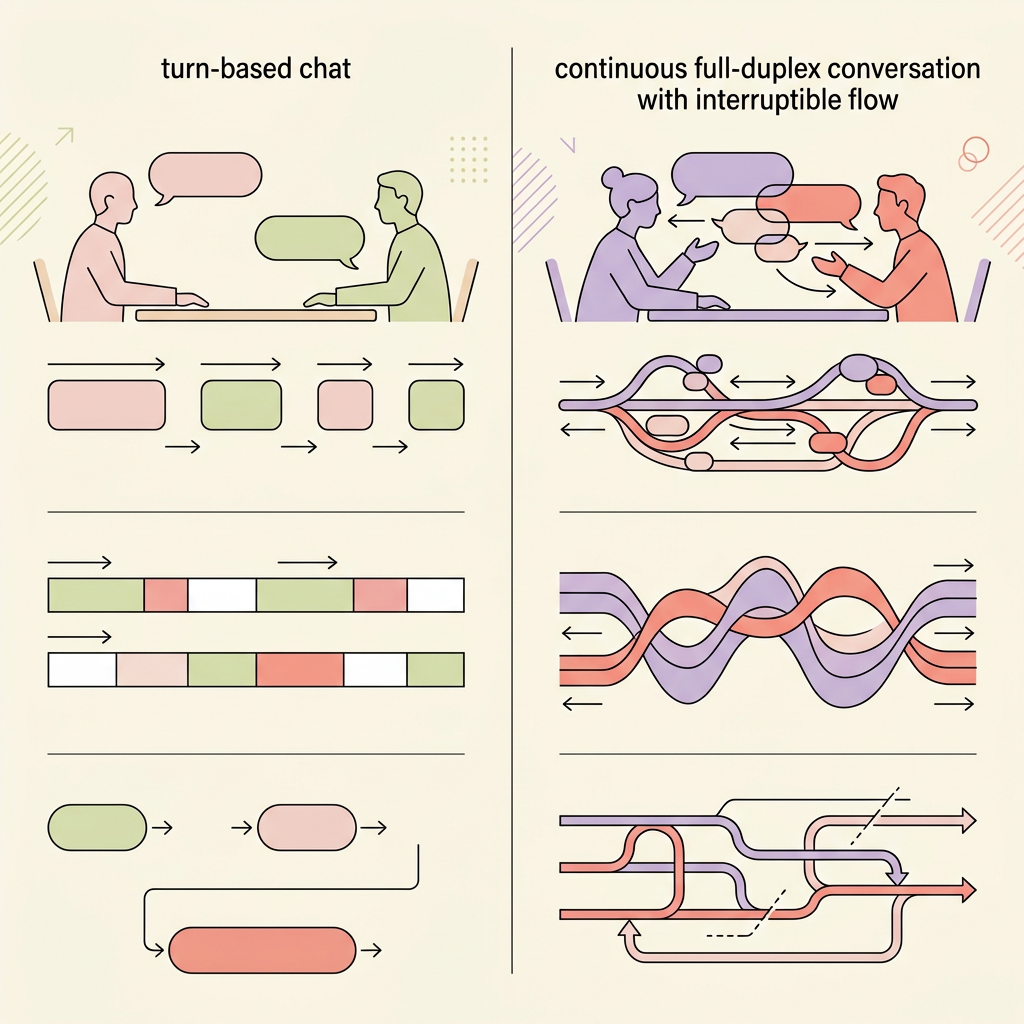
先讲清楚一个关键区别:绝大多数「语音模型」是回合制的。你说一句,它听完了回答一句,中间是断开的状态。
Realtime-Venus 做的是「全双工」。它在说话的同时保持感知,能区分附和、打断、纠正、话题转向这些不同的交互信号。这意味着它不只是「听懂」,而是「在场」——像真人一样,边听边判断什么时候该接话、什么时候该闭嘴。
更进一步的「主动交互」能力是:它持续处理时间对齐的视频和音频,在事件值得回应时主动发起响应,而不用等用户先开口。这对实时翻译、陪伴式助手、会议直播、以及需要「边看边说」的机器人交互,都是直接有价值的能力。
Realtime-Venus 开源了两个 9 B 参数检查点,定位清晰。
Realtime-Venus-Omni 是音视频交互模型。它能持续「看」和「听」,在共享的因果时间线上同时生成文本和语音。这是把视觉、听觉、语音生成打通到一条时间线上的版本。
Realtime-Venus-Audio 聚焦音频理解与音频驱动的对话,可输出文本或语音,在推理时不启用视觉编码器,但和 Omni 版共享同一套流式骨干与语音解码器。
架构上,骨干基于 Qwen 3-8 B,音频编码器用 Whisper-Medium,权重为 BF 16,上下文长度 40960。语音生成采用离散 S 3 语音 token 配合流式流解码器。这个组合和 网易有道开源的同传模型 是同一个国产开源语音 AI 的浪潮,只是方向不同——有道做的是低延迟同传,蚂蚁做的是全双工交互。
全双工交互有一个棘手的问题:如果 AI 在说话的时候需要调用一个外部工具(比如查数据库、调 API),这个调用可能要花几秒钟,会不会打断正在进行的对话?
Realtime-Venus 用「异步委派」来解决。它通过共享的因果时间线发出流内委派请求,以同样方式消费异步后端结果,让外部任务不会阻塞正在进行的对话。也就是说,AI 可以一边跟你聊,一边在后台把活干了,干完了再自然地把结果接回来。
不过这里有一个重要的边界:执行这些委派请求需要配套的 Realtime-Venus-Harness 运行时,这个运行时托管在 GitHub 仓库里。换句话说,模型权重是完整的,但完整的「边聊边干活」体验,需要把模型和 Harness 一起部署。
如果你是做实时多模态应用的开发者,Realtime-Venus 值得关注,因为它是这个方向上一个可复现的开源基线。Apache-2.0 协议意味着可以商用、可以微调、可以自部署,没有繁琐的限制。
它的价值主要体现在两类场景。一类是「实时在场」——陪伴式助手、实时翻译、会议纪要、直播互动,这些需要 AI 持续感知、主动回应的场景。另一类是「边看边说」——机器人交互、辅助驾驶这类需要同时处理视觉和语音的场景。
不过要管理好预期:全双工和主动交互对延迟、算力和工程集成的要求都比较高,实际体验取决于 Harness 运行时的成熟度和你的硬件条件。这是开源基线,不是开箱即用的产品。
一句话:这是一个「方向型」开源项目,看的是「实时在场 AI」这个趋势怎么落地,不是今天就能拿来替换你的客服机器人。
短期看,Realtime-Venus 最大的价值是「把全双工能力开源了」。过去「主动开口、可打断」这类能力几乎只有闭源大厂有,现在有了一个 Apache-2.0 的开源实现,开发者可以基于它做二次开发。
中期看,国产开源在「实时语音/音视频」这个方向上的集体发力值得关注。有道的同传模型、蚂蚁的 Realtime-Venus、阿里的 Qwen 3.8-Omni-Flash,都在各自的角度补「实时交互」这块拼图。这个方向很可能成为继「文字大模型」之后的下一个开源竞争焦点。
长期看,这背后是一个更大的趋势:AI 正在从「工具」变成「在场的存在」。当模型能持续感知、主动回应、边聊边干活,它的角色就从「你问它答的程序」变成了「和你共处一个空间的伙伴」。Realtime-Venus 是这个转变的早期信号之一。
是的。它在说话的同时保持感知,能区分附和、打断、纠正、话题转向等交互信号。这是它区别于回合制语音模型的核心能力。
Omni 版处理音视频交互,能「看」和「听」;Audio 版专注音频理解和音频驱动对话。做纯语音应用选 Audio,做带视觉的实时交互选 Omni。
模型权重是 Apache-2.0 协议,可商用。但完整的「边聊边干活」体验需要配套的 Realtime-Venus-Harness 运行时(托管在 GitHub),需要一定的工程能力来部署。