统计 AI 调用时,最容易漏掉的不是小数点,而是根本没有 usage 的失败记录。jq 可以在本地筛选 JSON、生成审阅表,并明确保留未知值。本文提供三行合成日志与可复制命令,不处理真实账单,也不将缺失 token 当成零。
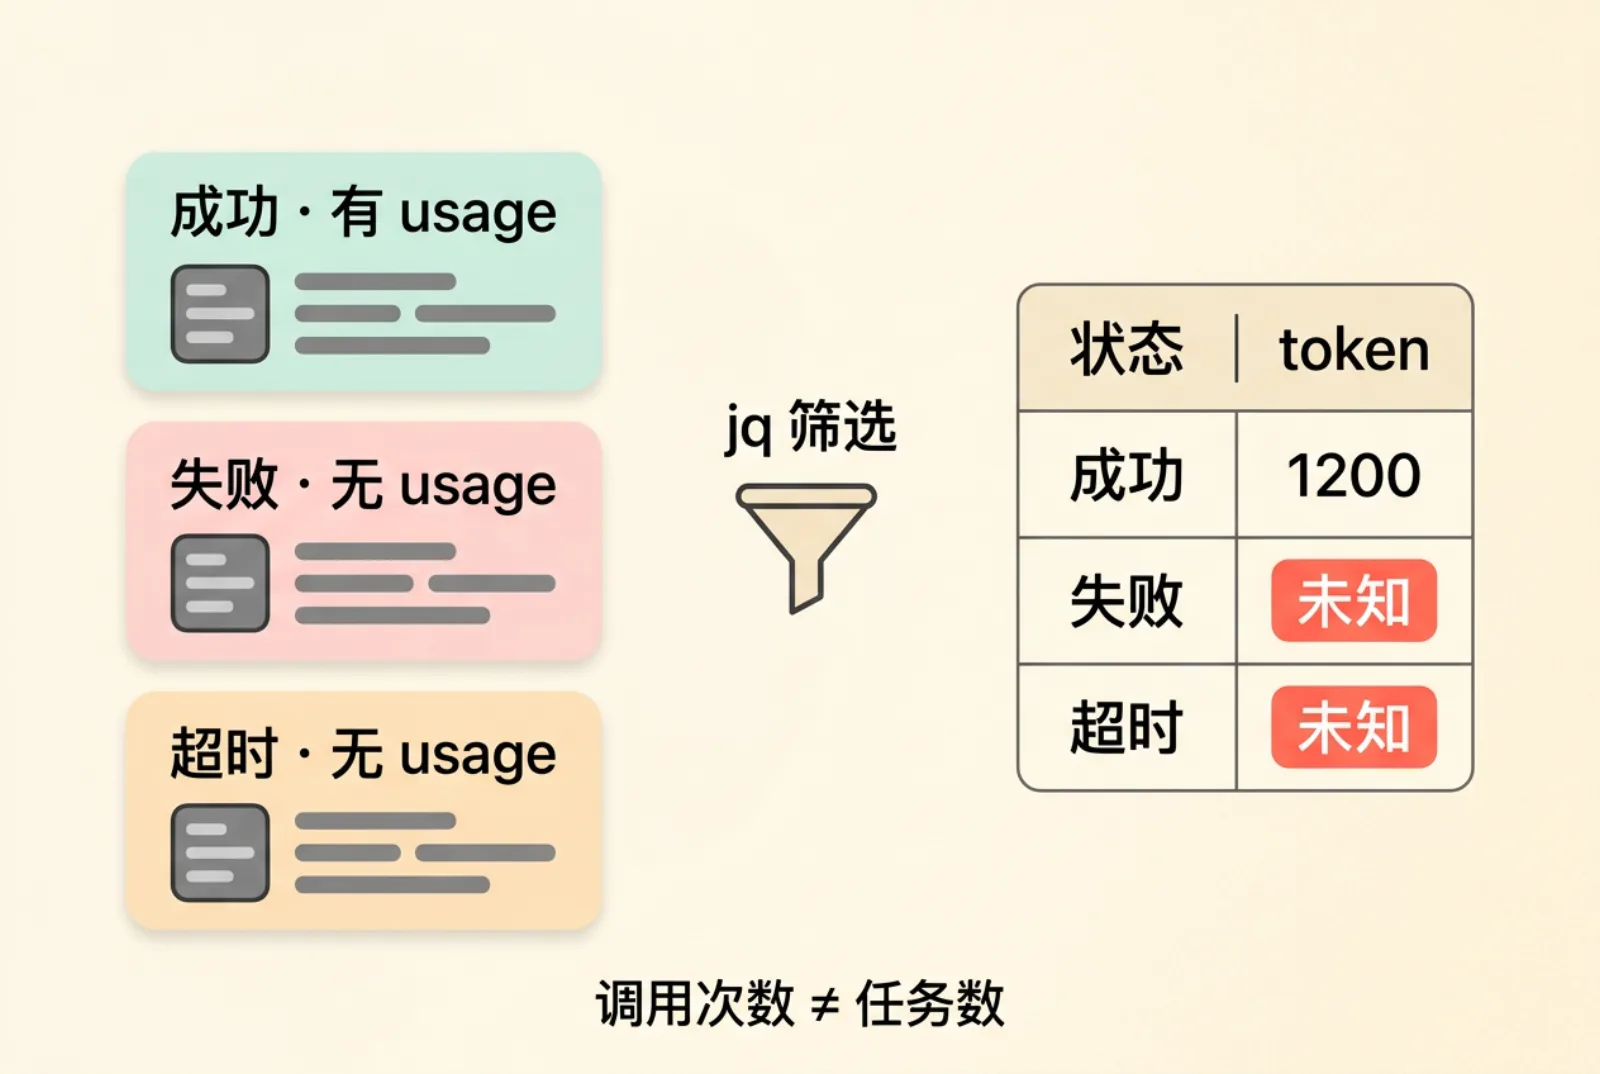
jq是命令行 JSON 处理器,适合把响应日志转换为统一的检查视图。它不调用模型、不自动读取供应商账单,也不理解不同接口的计费规则。你仍要负责把原始字段映射到明确的内部格式。
从AI 成本讨论进入实际核算后,先保证失败和未知值没有消失,再考虑精确费用。这里的任务是整理数据,不是给出模型价格或节省比例;如果日志尚未采集,安装 jq 并不会补回历史用量。
使用 jq 官方下载页提供的包管理器或发行文件。常见平台命令如下,按自己的系统只选一条;包管理器需要预先安装且来自可信渠道。官方仓库包含许可证说明,分发二进制时应保留对应声明并检查依赖许可。
macOS(已有 Homebrew):brew install jq
Debian/Ubuntu:sudo apt-get install jq
Windows(已有 winget):winget install jqlang.jq
安装后在终端执行 jq --version。若包索引陈旧,先按系统维护规范更新索引,不从随机下载站寻找替代文件。需要固定版本时,从官方发行渠道选择对应架构,并核查官方提供的完整性信息。
在练习目录创建 UTF-8 文件 usage.jsonl,每行一个 JSON 对象。下面是自定义的合成格式,不是任何供应商原始响应;第二行故意缺少 usage,用于检查未知值是否被保留。不要把密钥、完整提示词或客户身份混进练习文件。
{"task_id":"t1","attempt":1,"model":"candidate-a","status":"ok","usage":{"input_tokens":100,"output_tokens":20}}
{"task_id":"t2","attempt":1,"model":"candidate-a","status":"error"}
{"task_id":"t2","attempt":2,"model":"candidate-a","status":"ok","usage":{"input_tokens":120,"output_tokens":30}}
同一个 task_id 可以有多次尝试,重试时不要覆盖旧行。团队可参考AI 配置协作工作流统一字段说明,但务必写清 token 是否包含缓存和其他细分项,不能仅统一名字。
为避免 shell 引号差异,在练习目录创建 audit.jq,将筛选表达式放进去,再使用 -f 读取。// 在这里提供缺失值替代,数字 0 会被保留;未知值输出 UNKNOWN,不加入伪造的零用量。
[
  .task_id,
  .attempt,
  .status,
  (.usage.input_tokens // "UNKNOWN"),
  (.usage.output_tokens // "UNKNOWN")
] | @tsv
jq -r -f audit.jq usage.jsonl预期第二条记录仍然出现,并在两个用量列中标为 UNKNOWN。本篇未执行该命令;运行时若 JSON 解析失败,先保留原文件并定位坏行,不用 try ... empty 静默吞掉错误。终端重定向生成文件前,应确认目标文件不会覆盖已有账本。
小文件可用 slurp 把记录读成数组。下面会分别统计尝试数、任务数和缺少 usage 的行数;只有这三行示例时,按定义应得到 3、2、1。这是样例逻辑推导,不是生产数据。usage 对象存在但字段不全还需要进一步校验,不能被这一个指标盖住。
jq -s '{attempts:length,tasks:([.[].task_id]|unique|length),missing_usage:([.[]|select(.usage == null)]|length)}' usage.jsonlWindows 的引号处理因 shell 而异,遇到问题可把整条过滤表达式移到 summary.jq,再运行 jq -s -f summary.jq usage.jsonl。-s 会将整个输入读入内存,大日志应使用适合流式处理的方案或数据库,不把这个入门命令直接用于数十 GB 文件。
如果任务 ID 重复含义不一致、usage 字段口径不明,或者无法区分请求失败与业务失败,先修数据定义。对未知费用保留标记并与控制台核对,不根据平均值补齐。要生成财务账目,还需要精度、币种和价格生效时间,jq 的这个示例不承担结算职责。
少量检查用 jq,复杂关联、权限管理和长期报表更适合受控数据库或已有观测系统。结合生产级 Agent 工程原则保留请求与任务的边界,才不会把重试后的“成功一条”误当成“只调用一次”。先把未知暴露出来,往往比算出漂亮的平均值更有用。
问:缺失 usage 可以记为零吗? 答:不可以,应保留未知并向供应商账单核对。
问:三行日志就代表三个任务吗? 答:不一定,同一任务可以产生多次调用尝试。
问:jq -s 适合任意大日志吗? 答:不适合,它会把全部输入读入内存。
核查日期:2026-10-06。安装及过滤语义依据官方资料,合成日志不代表真实计费记录。
{"@context": "https://schema.org", "@type": "FAQPage", "mainEntity": [{"@type": "Question", "name": "缺失 usage 可以记为零吗?", "acceptedAnswer": {"@type": "Answer", "text": "不可以,应保留未知并向供应商账单核对。"}}, {"@type": "Question", "name": "三行日志就代表三个任务吗?", "acceptedAnswer": {"@type": "Answer", "text": "不一定,同一任务可以产生多次调用尝试。"}}, {"@type": "Question", "name": "jq -s 适合任意大日志吗?", "acceptedAnswer": {"@type": "Answer", "text": "不适合,它会把全部输入读入内存。"}}]}