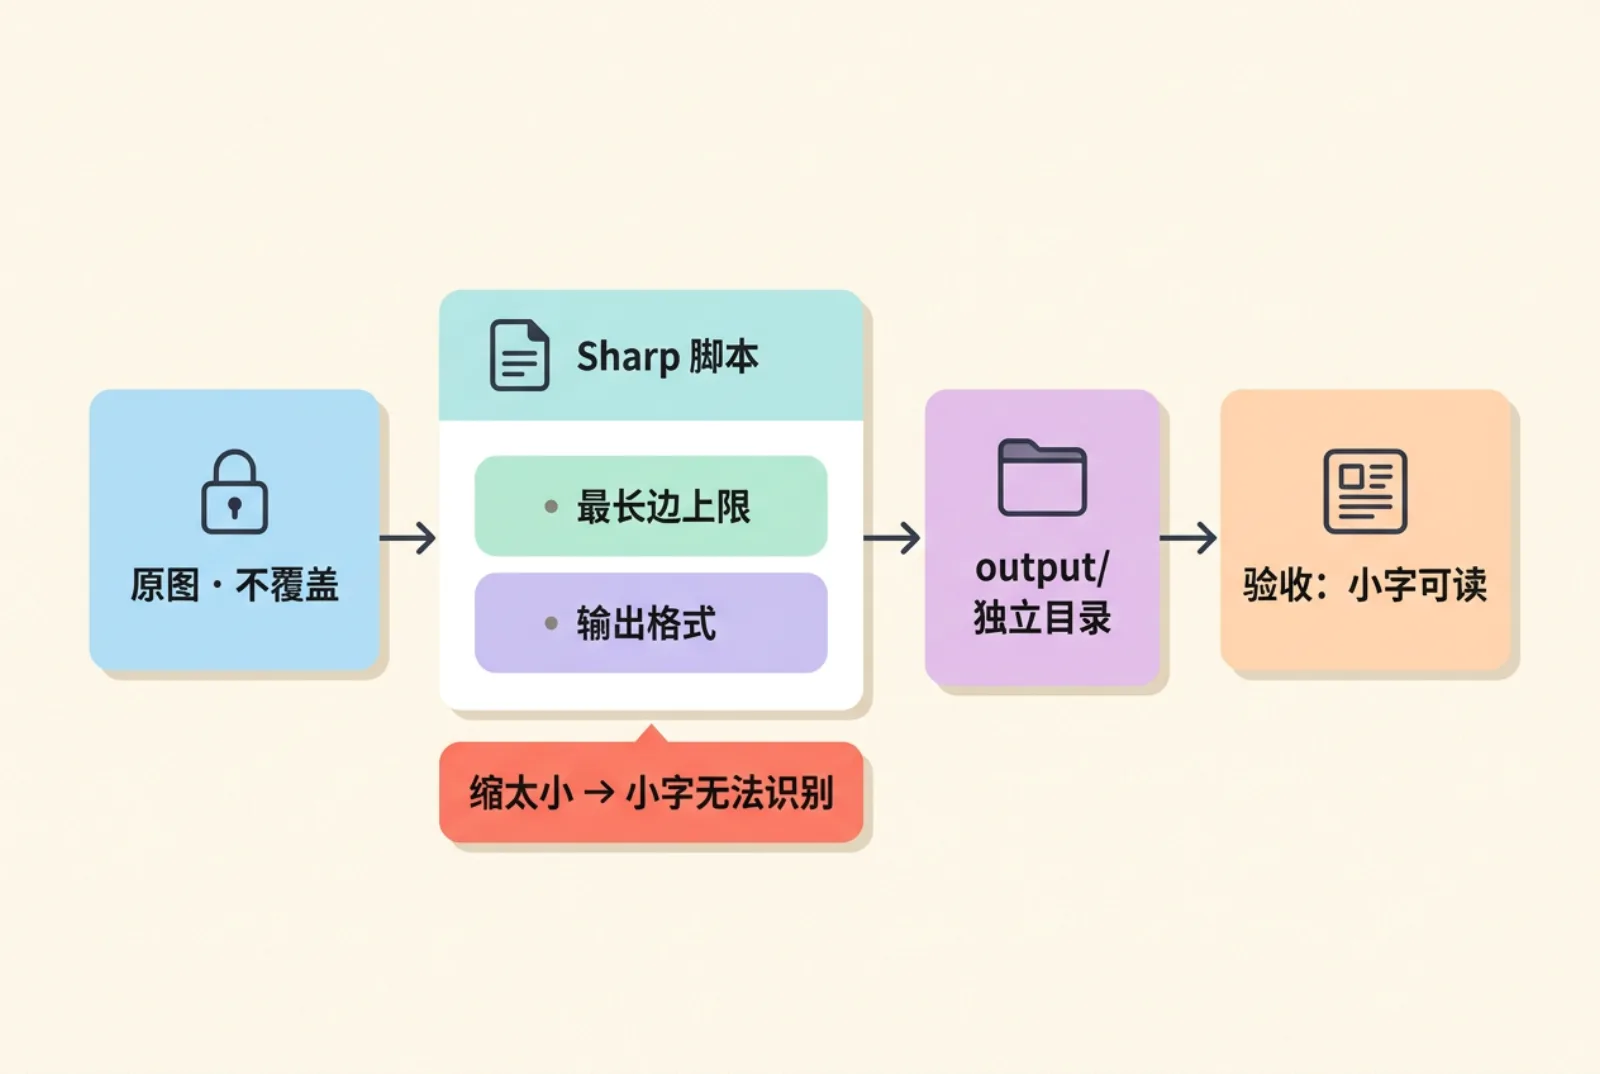
人工用 Squoosh 选好方向之后,批量处理最怕两件事:覆盖原件,以及把小字缩到无法识别。Sharp 是 Node.js 图片处理库,可以在脚本里明确尺寸、格式和输出位置。本文给出单张图片的安全起步方案,不生成图片,也没有测量压缩率或 OCR 成绩。
Sharp适合在图片进入 OCR、视觉模型或文档展示之前执行重复处理。它是需要安装的库,不是打开即用的网页,因此归资源栏目。它处理像素和编码,不懂订单金额是否看得清,也不会替你核对模型识别准确性。
可以先用 aiKit 的 Squoosh 图片压缩手工比较候选,再用脚本表达通过验收的尺寸和格式要求。不同编码器的 quality 数值不能直接照搬,手动选择的视觉结果仍需在 Sharp 产物上重新确认。
官方安装说明见 Sharp installation,源码与 Apache-2.0 许可证在官方仓库。库无需模型账号,模型 API、托管计算与存储的成本另计;底层库和编码器也有自己的许可说明,分发产品时应一并审阅。
本次文档列出的运行条件为兼容 Node-API v 9 的运行时,例如 Node.js 至少 20.9.0。本教程建议使用受支持的 Node.js 24 环境。预编译包按系统和 CPU 选择,macOS、Windows 和 Linux 常见平台可用,但 Linux 的 libc、CPU 与容器基础镜像仍要匹配,不能只看 Node 版本。
在单独练习目录执行以下命令,Windows PowerShell 同样可逐行运行。安装后记录实际 Sharp 及 libvips 版本。不要把另一台电脑的 node_modules 整目录复制过来,目标环境应按自己的平台重新安装,并核对锁文件兼容性。
mkdir sharp-lab
cd sharp-lab
node --version
npm init -y
npm install --save-exact sharp
node -e "console.log(require('sharp').versions)"失败时先查平台、架构、可选依赖和官方安装文档,不立刻转源码编译或关闭安全设置。团队共享脚本时,像统一 AI 配置那样明确运行环境,同时保留输入和输出边界。
将一张不含隐私的 PNG 合成截图命名为 sample.png 放在练习目录,创建 prepare-image.cjs。脚本新建独立输出目录:若目录已存在就报错停止,避免重复运行时悄悄覆盖结果。这里的 1600 像素宽度与 2000 万输入像素上限是教程自拟政策,不是所有视觉模型的通用限制。
const fs = require('node:fs/promises');
const sharp = require('sharp');

async function main() {
  await fs.mkdir('prepared');
  const input = sharp('sample.png', { limitInputPixels: 20000000 });
  const metadata = await input.metadata();
  const info = await input
    .resize({ width: 1600, withoutEnlargement: true })
    .webp({ lossless: true })
    .toFile('prepared/sample.webp');
  console.log({
    original: { width: metadata.width, height: metadata.height },
    output: info
  });
}

main().catch(error => {
  console.error(error.message);
  process.exitCode = 1;
});
执行 node prepare-image.cjs,再打开原件与产物比较。withoutEnlargement 避免放大小图;无损 WebP 指编码阶段无损,若此前进行了缩放,整条处理链仍丢失了原始像素信息。文件也不保证一定更小。
先检查尺寸和格式,再以原始像素比例看小字、透明边缘与细线;使用同一份字段答案,对比原图和产物的识别结果。出现退化就回到原图或提高尺寸上限,不以压缩后的字节数更小作为唯一通过标准。Sharp resize 文档与输出文档解释了参数能力,不提供你这张图片的质量保证。
针对扫描 PDF,可先评估文档解析资源中的文本提取路径。本文只处理静态 PNG;照片方向、动画、色彩管理、EXIF 和多页文档不在这个最小示例覆盖范围,不能直接扩展到全量媒体库。
单次人工处理用 Squoosh 更直接,连续处理大量图片才值得维护脚本。来源不可信的图片还应有文件大小、类型、并发、内存和超时限制;像素上限不是完整安全沙箱。服务端执行时使用低权限进程,不能把用户提供的任意路径直接传给脚本。
失败后保留原件和错误,确认输出目录状态再决定重跑,不在脚本里自动删除原始数据。本文没有安装 Sharp、执行处理或验证所有平台;发布成“实测教程”前,需要补上目标环境的版本与正反例证据。
问:使用无损 WebP 就完全不会丢信息吗? 答:若此前缩放过,已经丢失原始像素,不能称整链路无损。
问:产物一定比原图小吗? 答:不一定,要比较实际字节数和质量。
问:脚本能直接处理不可信用户上传吗? 答:不能直接照搬,还需权限、大小、并发和超时隔离。
核查日期:2026-10-06。示例未执行,未创建图像或测试压缩性能。
{"@context": "https://schema.org", "@type": "FAQPage", "mainEntity": [{"@type": "Question", "name": "使用无损 WebP 就完全不会丢信息吗?", "acceptedAnswer": {"@type": "Answer", "text": "若此前缩放过,已经丢失原始像素,不能称整链路无损。"}}, {"@type": "Question", "name": "产物一定比原图小吗?", "acceptedAnswer": {"@type": "Answer", "text": "不一定,要比较实际字节数和质量。"}}, {"@type": "Question", "name": "脚本能直接处理不可信用户上传吗?", "acceptedAnswer": {"@type": "Answer", "text": "不能直接照搬,还需权限、大小、并发和超时隔离。"}}]}