31
7 月
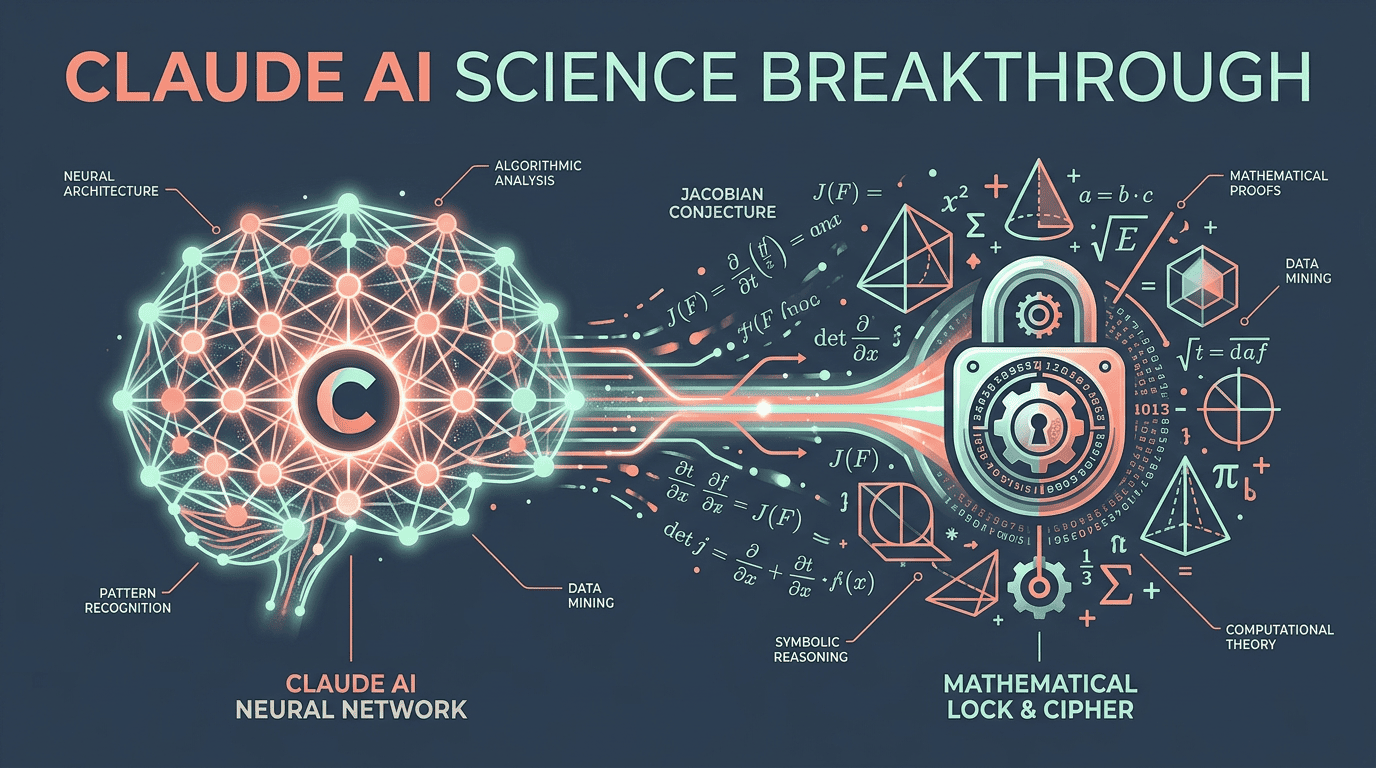
Claude 科研进展:密码学研究说明了什么,又没有说明什么
更正记录,2026 年 8 月 31 日:旧文将不同研究拼接为“一周内连破”,混淆公告日期,并把有限实验结果写成普遍结论。本次改以可核查的官方研究公告为依据;未逐项核实的社交帖原话、数学反例细节和研究时间线不再保留。
这次密码学研究的边界
Anthropic 于 2026 年 7 月 28 日公布,研究人员使用 Claude Mythos Preview 改进了针对 HAWK 签名方案以及减轮 AES 的攻击方法。官方明确指出,这不等于完整 AES 被攻破,也不要求现有生产系统因此更换加密方案。该公告同时提及 Fable 5 的 Jacobian 猜想研究,但不能据此支持旧文自行拼接的发生日期和全部数学细节。来源:Anthropic 研究公告。
“AI 发现结果”与“结果已经可靠”是两件事
阅读 AI 科研新闻时,智盒建议把证据分成四层:模型提出的候选、研究团队完成的验证、公开论文或代码、独立研究者的复核。新闻可以报告前一层的进展,但不能自动把它升级成后一层的结论。本文整理研究公告,不宣称本站独立复现了数学证明或密码分析。
- 对象:先明确算法、参数规模和版本。针对实验变体的结果,不应替换成整个算法家族的结论。
- 假设:核对攻击者能够获得什么信息、需要多少资源。理论上更快不等于现实中可行。
- 验证:查看论文和代码是否公开,是否能按描述重跑,以及独立复核是否完成。
- 影响:区分候选设计、实验系统和真实生产部署,再决定是否需要采取行动。
开发团队现在应当做什么
维护依赖和加密配置清单,跟进所用标准、库及供应商的正式安全公告;不要因为一个研究标题就自行设计加密算法或临时改动生产配置。若在团队内使用 AI 辅助研究,应保留输入、假设、代码版本、失败实验和人工审查记录,让后续人员能够复查推导过程。
对 AI 选型的启发
比较模型时,除了“能否提出新想法”,还应问它能否明确表达不确定性、保存可复现过程并接受反例。对普通业务团队,这些往往比借用科研新闻宣称模型“无所不能”更有价值。可结合国产模型选型框架与Web 认证架构说明理解工程边界;来源与更正规则见编辑政策。
RELATED
Posts
15 10 月
阿里 QwenGyre 论文解读:训练长程 Agent 快 1.78 倍,代码还没公开
一句话结论:阿里通义团队 9 月 27 日在 arXiv 发布 QwenGyre 论文,这是一套专门训练「一次要跑几个小时」的 AI Agent 的在线强化学习框架。用在 2.4 万亿参数的 Qwen 3.8 上,48 步训练让 NL2RepoBench 得分从 52.5% 升到 58.5%,耗时 75.42 小时,比 Async 方案的 134.55 小时快 1.78 倍。不过截至 2026-10-14,我们没有找到公开的代码仓库,部分报道说的「开源」目前只指论文公开。 AI 摘要 发生了什么:阿里 Token Hub 联合中国科大、清华发布 QwenGyre 论文(arXiv 2609.33848,2026-09-27),10 月...
9 10 月
给 AI 读图前怎么压缩?用 Squoosh 保住小字、图表和透明边缘
Squoosh 图片压缩不应只比较文件大小,AI 读图还需要保留小字、小数点和表格细线。本文提供原图与两份候选的三路对照方法,说明怎样记录像素尺寸、编码参数、十个关键字段和识别退化,并连接 aiKit 在线工具。文章不承诺压缩率或模型费用下降,也不把肉眼清晰当作 OCR 正确率证明,适合建立图片输入验收流程。
9 10 月
提示词改短以后真的更好吗?用保留集做一次回归检查
提示词回归检查要看新版修好了什么,也要看原本正确的任务有没有退步。本文以三类客服工单为例,说明调试集与保留集如何拆分、怎样冻结标签规则、记录逐条差异并处理空输出和超时。附模板、CSV 示例及人工复核门槛,帮助团队建立可追溯的上线依据与版本回退记录;样本数量是教学建议,不是实测成绩,也不承诺准确率提升。
8 10 月
用 Mermaid 审查 AI Agent:把审批、失败和停止条件画清楚
用 Mermaid 审查 AI Agent,重点不是把正常流程画得漂亮,而是确认审批、超时、拒绝和停止条件。本文提供可粘贴的流程图代码及四类路径检查方法,说明幂等键、人工批准、状态查询和版本管理的边界,并连接 aiKit 在线编辑器。模板未经运行验证,不把渲染成功当作权限安全证明,也不要求上传真实客户数据。
8 10 月
国产模型怎么比成本?把重试、缓存和失败任务记进同一本账
国产模型成本核算不能只看每百万 token 单价。本文用一份任务账本说明输入、输出、缓存命中、重试和未知费用怎样归集,并用四个虚构任务演示合格任务平均成本的计算。附日志字段、Python 算术示例和公平比较清单,帮助开发者保留质量门槛、延迟与实际费用证据,不提供实时模型价格,也不把失败调用误记为免费。
8 10 月
国产模型输出 JSON 就能上线?先做这套结构化验收
国产模型能输出 JSON,不代表字段正确或可以直接入库。本文提供一套包含三层校验、12 条冒烟样本设计、异常分类和人工审核门槛的验收方法,帮助开发者比较候选模型的实际业务适配性。附可复用的数据合同与测试示例,解释空响应、截断、额外字段和语义错误的处理边界,不提供未经验证的模型排名、成功率或价格结论。
24 9 月
Claude Opus 5.5 发布:编程基准最强,价格砍 40%,Amodei 两个月前喊的减速呢
Anthropic 9 月 22 日发布 Claude Opus 5.5:编程基准最强、价格砍 40%、缓存读取降 60%;这是 CEO Dario Amodei 两个月前呼吁给安全让出空间后,公司的第一份商业答卷。
24 9 月
OpenAI 同日双发 GPT-6 Sol 和 Luna:API 价格再砍 50%,把旗舰能力蒸进便宜档位
OpenAI 同日双发 GPT-6 Sol 和 Luna,API 价格较上一代促销定价再降 50%,Sol 单任务成本只有 Astra 约四分之一;事实错误率降一半但回答率也跟着降,模型变得更「保守」。
23 9 月
Claude Opus 5.5 发布:编程基准最强,价格砍 40%,Amodei 两个月前喊的减速呢
Anthropic 9 月 22 日发布 Claude Opus 5.5:编程基准最强、价格砍 40%、缓存读取降 60%;这是 CEO Dario Amodei 两个月前呼吁给安全让出空间后,公司的第一份商业答卷。
22 9 月
小米 MiMo-V2.6 开源:AA 指数 46 分登顶开源权重,6 天 RL 训练暴涨 20 分
小米开源 MiMo-V2.6,AA 指数 46 分登顶开源权重,超 Kimi K3 和 GLM-5.3;6 天 RL 训练成本 262 万美元,一代暴涨 20 分。


评论 (2)
[…] Claude AI 科学突破 […]
[…] 对数学家:费马大定理的形式化一直是「珠穆朗玛峰」级别的目标。这个结果意味着,未来「附带形式化验证代码」可能成为论文标配——当 AI 能快速生成成千上万条新猜想时,人类看不过来,机器验证就成了刚需。这也呼应了我们之前关注的 Claude 科研进展。 […]
评论被关闭。