

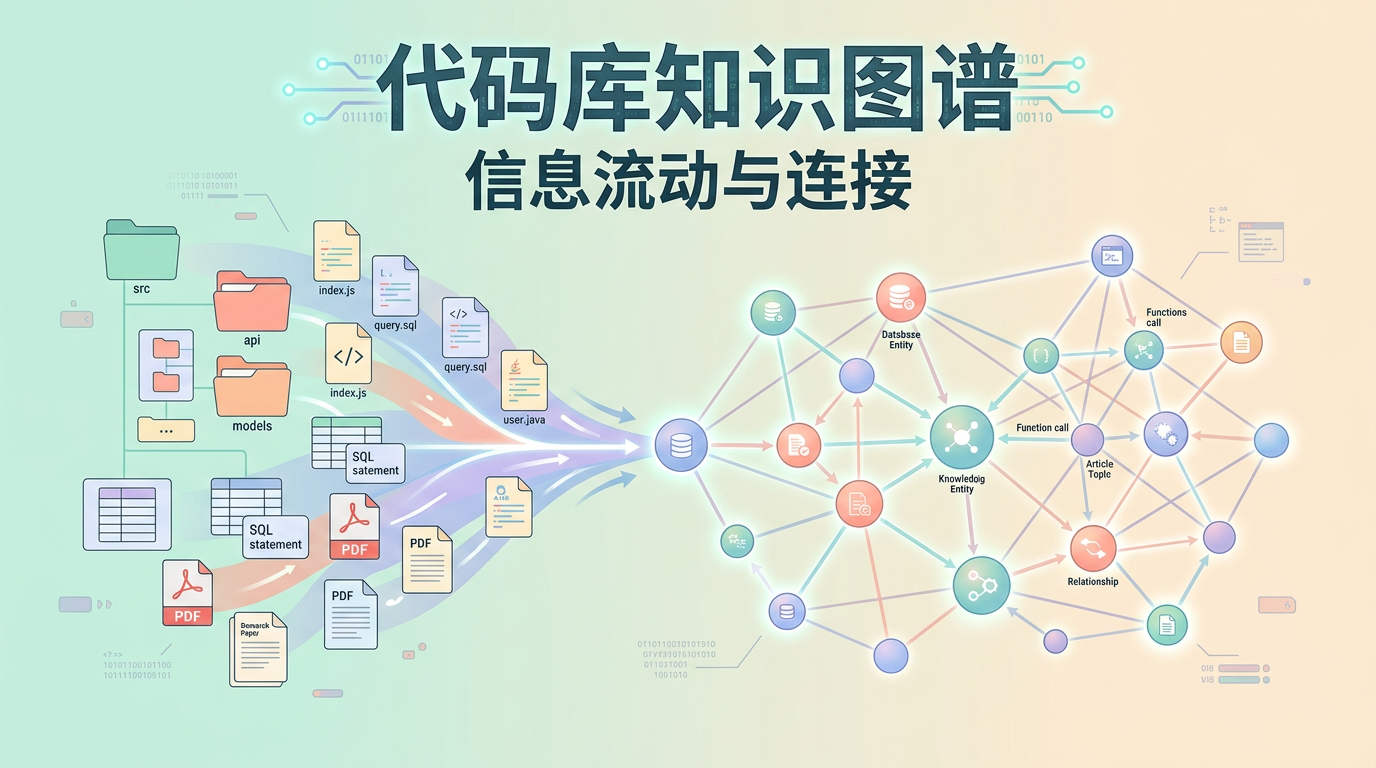
一句话结论:graphify 是一个面向 Claude Code、Codex 等 AI 助手的
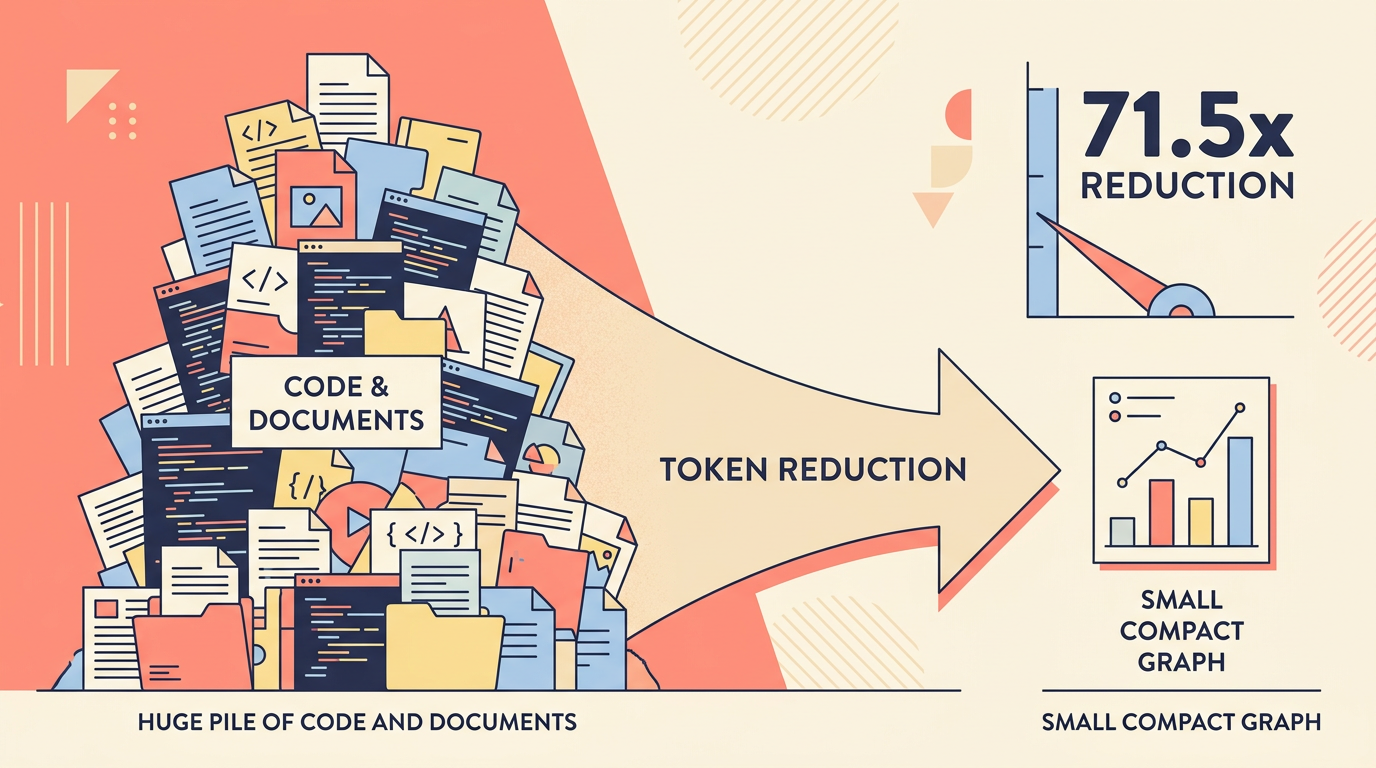
/graphify技能,用确定性 AST 解析把代码、文档、论文、图片解析成一张可持久化的知识图谱,宣称在 52 个文件的语料上实现 71.5 倍 token 削减。
graphify install 一条命令装到 Claude Code/Codex/OpenCode 等平台。AI 编码助手有个绕不开的痛点:上下文窗口再大,也装不下一个真实的项目——代码、文档、SQL、配置、PDF 全塞进去,token 成本爆炸,而且模型容易被无关信息带偏。传统方案是向量检索,但向量检索的问题是「找到相似片段」不等于「理解结构关系」,而且检索结果往往没法解释。
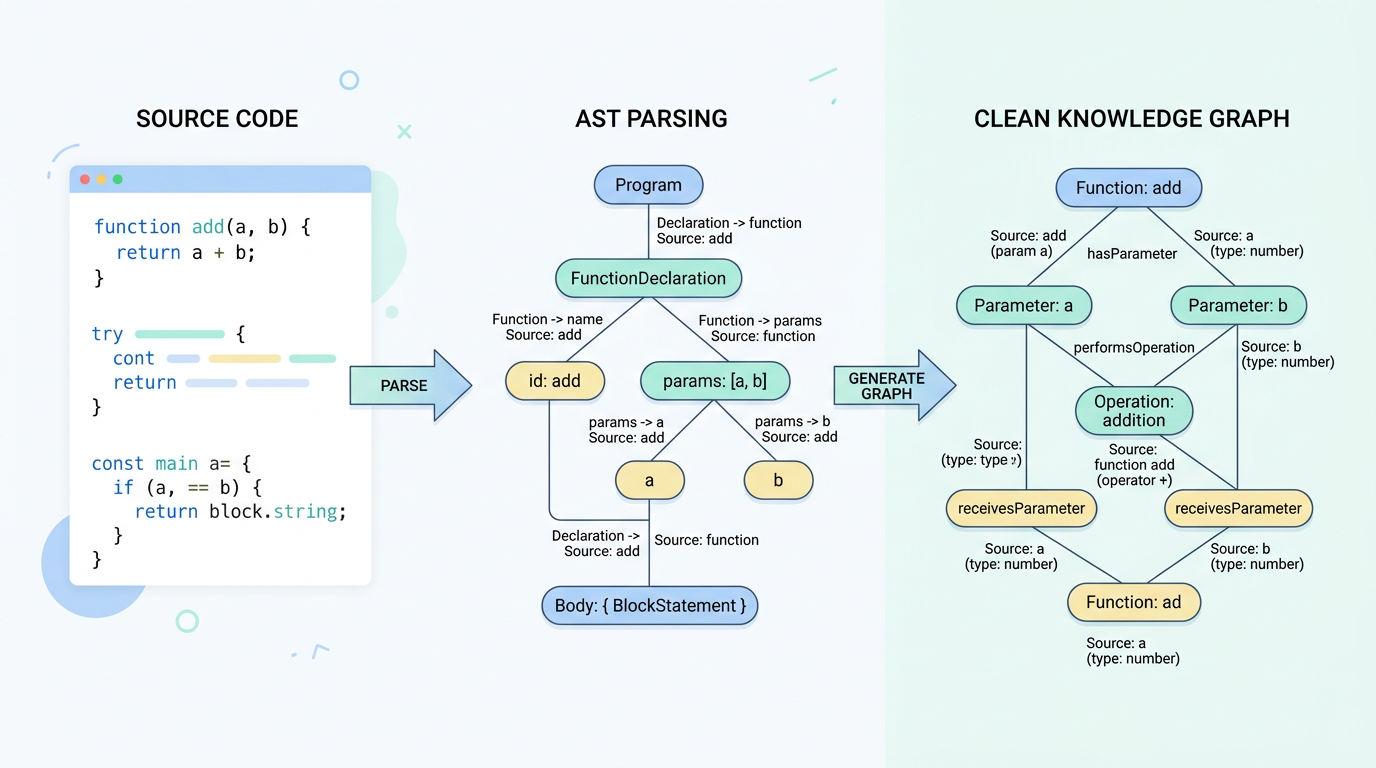
graphify 走的是另一条路:用确定性的 tree-sitter AST 解析,把代码里的函数、类、依赖关系、文档、论文、截图,解析成一张知识图谱。这张图谱是结构化的、可持久化的、可查询的,而且「每条边都能解释来源」——你知道图上为什么有这条连接,因为它对应着源码里的某个 import 或调用关系。
| 功能 | 说明 | 使用价值 |
|---|---|---|
/graphify <目录> | 把文件夹解析成知识图谱 | 一次建图,多次查询 |
--watch | 监听文件变更自动更新图谱 | 图谱随代码演进 |
--svg / --graphml / --neo4j | 导出不同格式 | 可接 Gephi、yEd、Neo 4 j |
--wiki | 解析 Wiki(index.md + 社区文章) | 把文档也纳入图谱 |
| always-on 模式 | 让 AI 助手始终使用图谱 | 免手动触发 |
graphify 官方给了一个具体的数字:在 Karpathy 仓库 + 5 篇论文 + 4 张图的 52 个文件语料上,token 削减率达到 71.5 倍。这个数字不是拍脑袋——仓库的 worked/ 目录里有三个公开实例,每个都带原始输入文件和实际输出(GRAPH_REPORT.md、graph.json),你可以自己复跑验证。
它背后的逻辑也很实在:第一次运行做抽取和建图(花 token),之后的每次查询只读紧凑的图谱,节省从这里开始复利积累。而且 token 削减随语料规模放大——6 个文件的语料本来就能装进上下文,图谱的价值是结构清晰度而非压缩;到 52 个文件时,节省才达到 71 倍以上。
graphify install 装到 Claude Code,graphify install --platform codex 装到 Codex,OpenCode/OpenClaw 也有对应命令。如果你还不熟悉 Claude Code 这类 Agent 外壳是怎么运转的,可以先看我们整理的 learn-claude-code 17 章课程解读,它正好拆解了 Agent 的底层机制,和 graphify 这类「给 Agent 喂结构」的工具形成互补。/graphify ./raw,它会解析代码、文档、论文,生成图谱。| 名称 | 差异 | 适合场景 |
|---|---|---|
| Understand-Anything | 交互式可视化仪表盘,多智能体 | 想要可视化探索的团队 |
| 向量检索(RAG) | 相似片段检索,不可解释 | 快速检索、无需结构关系 |
| Neo 4 j 直接建模 | 更底层、灵活但手工作业多 | 有专门图谱团队的场景 |
可以,Apache-2.0 协议,商用、修改、分发均无特殊限制。
能,graphify install 一条命令装到 Claude Code 或 Codex,然后在项目目录跑 /graphify 即可。但需要 Python 3.10+ 和已配置的 AI 助手环境。
向量检索是「找相似的片段」,快但不可解释;graphify 是「建结构化图谱」,慢一点但每条边都能追溯来源。它强调用确定性 AST 解析保证「每条边都能解释」,这是它区别于纯向量方案的核心卖点。

评论 (2)
[…] Agent 喂结构」的工具,比如 graphify 用确定性 AST 建代码知识图谱(它的 token 削减实测恰好用的就是 Karpathy 的仓库),nanochat […]
[…] graphify 用确定性 AST 建代码知识图谱,会发现 context-mode 和它是同一个问题的两面:graphify […]
评论被关闭。