

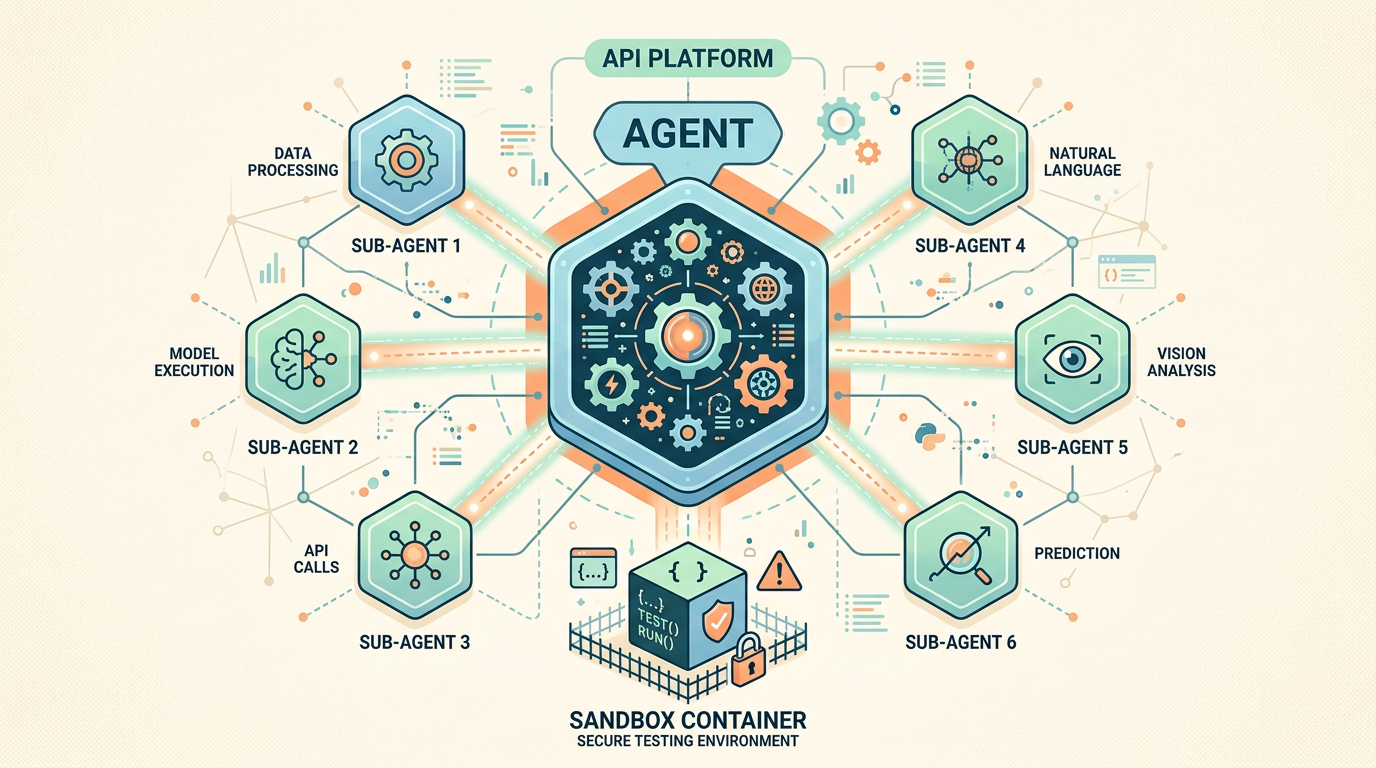
一句话结论:OpenAI 把支撑 Codex 和 ChatGPT for Work 的 harness 打包成 Agents API 开放公测,开发者不用自己搭多智能体编排、上下文压缩、沙箱环境这套脏活,一个 API 调用就能起一个能跑几天的 Agent。
OpenAI 在 9 月 10 日宣布 Agents API 进入 public beta。这件事的背景是:Codex 和 ChatGPT for Work 已经跑了几百万用户,OpenAI 从中积累了一套让 Agent 长时间稳定工作的经验——管上下文、高效用工具、协调子智能体、跑几天的可靠性,还有能在里面读写文件、跑代码、存中间结果的环境。
现在这套东西被打包成一个 API 放了出来。开发者要做的,是指定任务、模型、工具和环境,剩下的 harness 维护由 OpenAI 托管。官方的说法很直接:你不需要为每个新模型重新写 harness,OpenAI 会在每次模型发布时同步更新。
定价上有个值得注意的点:Agents API 本身不额外收费,你只需要为 Agent 实际消耗的 token 和工具付费。
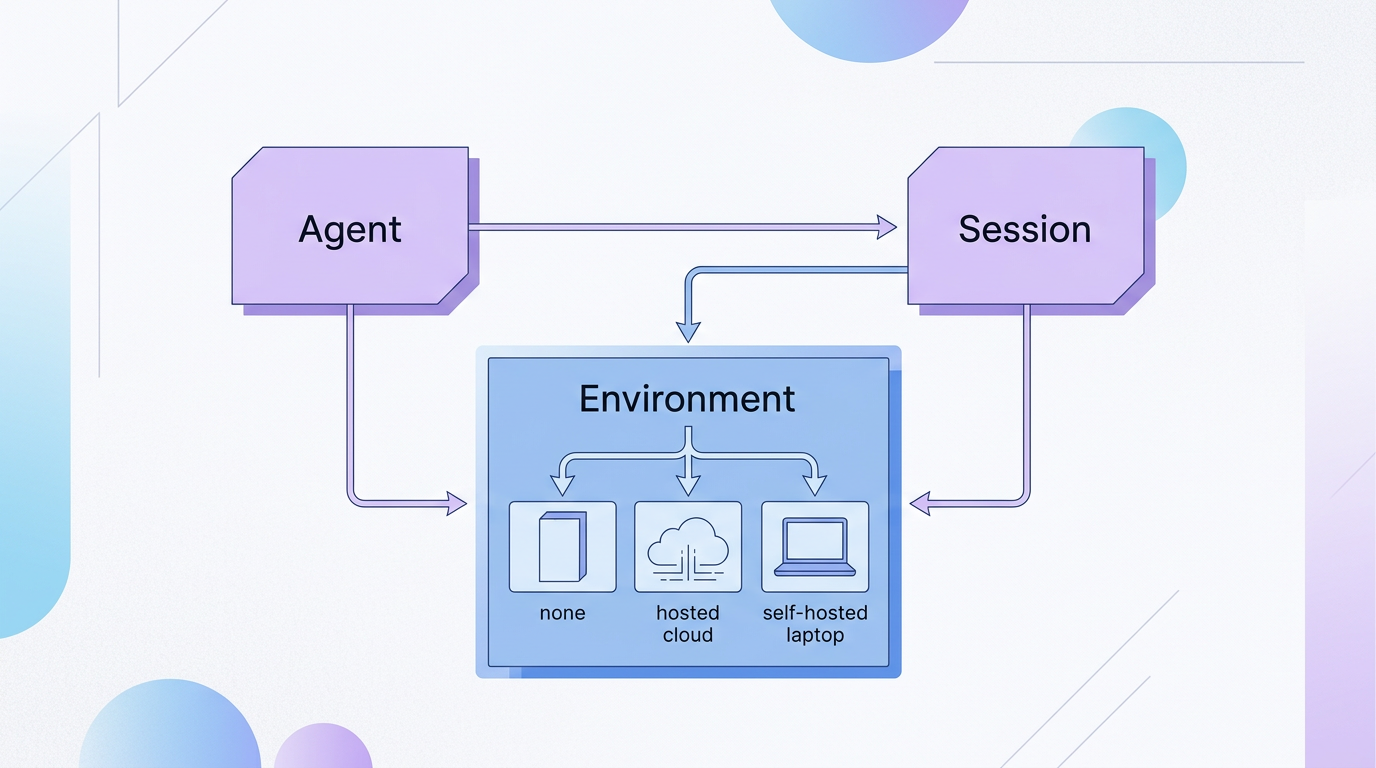
Agents API 的核心是四个概念:Agent、Environment、Session,以及底层的事件和 items。
Agent 是模型、指令、工具和 MCP server 的集合。Environment 是可选的沙箱,Agent 在里面跑命令、写文件、加载 skill。Session 是一个持久的 Agent 实例,它能记住之前的工作、在上下文快到上限时自动压缩、把任务拆给子智能体、还能在断开后接着跑。
Environment 有三种选择,这是这套 API 最灵活的关节。none 表示 Agent 不需要自己的计算环境,纯靠工具调外部服务。openai_hosted 是 OpenAI 托管的沙箱,和 Codex、ChatGPT 用的是同一套隔离基础设施。self_hosted 则让你用自己的笔记本、容器或远程沙箱,Agent 通过 WebSocket 连接回 API。
对于国内开发者,self_hosted 这条路尤其值得看,因为它决定了代码和数据是不是留在你自己的机器上。
如果只是把模型包一层 API,那没什么新鲜的。Agents API 真正有价值的是两个已经验证过的能力。
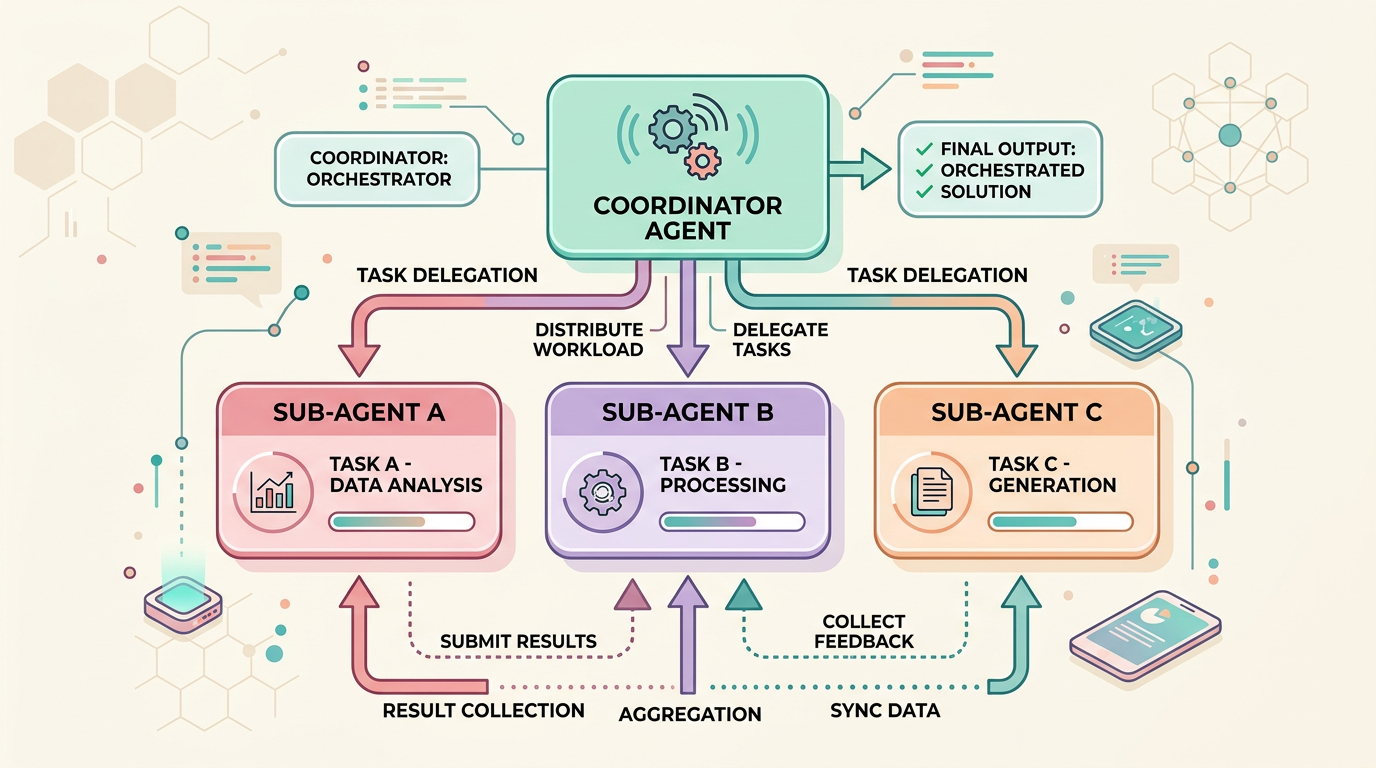
第一个是多智能体。开启 multi_agent 之后,主 Agent 可以把复杂任务拆成独立子任务,派给并行工作的 subagent。每个 subagent 有自己的上下文,主 Agent 负责协调和汇总。默认最多 6 个并发子智能体,可以在创建 session 时调整。这对研究、分析、编码这类能并行的任务,省掉了你自己写编排逻辑。
第二个是上下文自动压缩。Agent 跑长任务时,上下文会越来越满。Agents API 会在 session 接近上下文上限时自动压缩早期内容,保留继续工作所需的信息。开发者不用自己实现 compaction 逻辑,就能让工作流跨多个上下文窗口。这是做长任务的开发者最头疼的问题之一,现在被托管了。
工具这块有两处升级。tool search 按需加载相关工具定义,减少 token 消耗同时保住模型缓存。programmatic tool calling 让 Agent 在代码里并行调用、串联操作、过滤合并结果,只把相关结果带回上下文。
支持的工具体系包括 MCP、自定义 function,以及内置的 web search。也就是说,你之前写的 MCP server 可以直接挂进来,不用推倒重来。这也延续了 Pizza Bot 那篇里观察到的趋势——MCP 和 Agent Skill 正在成为 Agent 工具层的通用语言。而在减少上下文膨胀这件事上,context-mode 之前展示过另一条路,Agents API 则把压缩做进了托管层,两者方向一致、层次不同。
最直接的影响是:自己从零搭 Agent harness 的性价比,进一步下降了。
以前你要做长任务 Agent,得自己处理编排、沙箱、状态持久化、上下文管理、断线恢复。现在这些由 OpenAI 托管,你只需要写工具和知识。对资源有限的小团队,这省下的不只是代码量,还有长期维护的心智负担。
但代价也明确。Agents API 目前只支持美国数据驻留,不支持 Zero Data Retention。选择 self_hosted 沙箱,也不会让你的 session 变成 ZDR 合格。如果你的场景对数据主权有硬性要求,这一点要先看清楚。这和 Cloudflare OS 想解决的平台治理是两条不同的路线——一个是托管便利,一个是自主可控。
短期看,这是 OpenAI 把 Codex 的先发优势产品化的关键一步。把 harness 变成 API,等于把「我们调 Agent 调得最好」这件事,变成了开发者可以直接购买的基础能力。
中期看,真正的变量是生态合作伙伴。OpenAI 已经拉了 Blaxel、Cloudflare、Daytona、DigitalOcean、E 2 B、Modal、Oracle、Runloop、Vercel 一批沙箱提供商。谁能把 self_hosted 和托管沙箱的体验做到无缝,谁就决定了这套 API 在企业场景的渗透速度。
长期看,Agent harness 正在从「每个团队各写一份」走向「托管服务 + 开放标准」的分层。OpenAI 的 Agents API 和开源的 Codex harness 并存,意味着你随时可以看清托管层背后在跑什么。这种「托管但可审视」的姿态,会是接下来 Agent 平台的竞争重点。
区别在 harness。直接调模型 API,你要自己写循环、管上下文、处理工具调用。Agents API 把这层托管了,还附带了多智能体、上下文压缩、沙箱环境。你付的仍是 token 和工具费用,不额外为 harness 付费。
分情况。none 和 openai_hosted 环境里,数据在 OpenAI 侧处理。self_hosted 环境里,命令和工具在你的机器上跑,但 session 本身仍由 OpenAI 托管,且不支持 ZDR。对数据主权敏感的团队,这一点是决定性的。
先别急。现在是 public beta,API 和生态还在迭代。建议先用自托管沙箱做小规模验证,跑几个真实任务看稳定性和成本,再决定要不要把生产流量切过去。

评论 (1)
[…] OpenAI 把 Codex 拆成基础设施 的趋势——AI […]
评论被关闭。