28
5 月
中国 AI 的一攻一守:Qwen 3.5 跑出 580 tps,Cognition 估值 260 亿美元

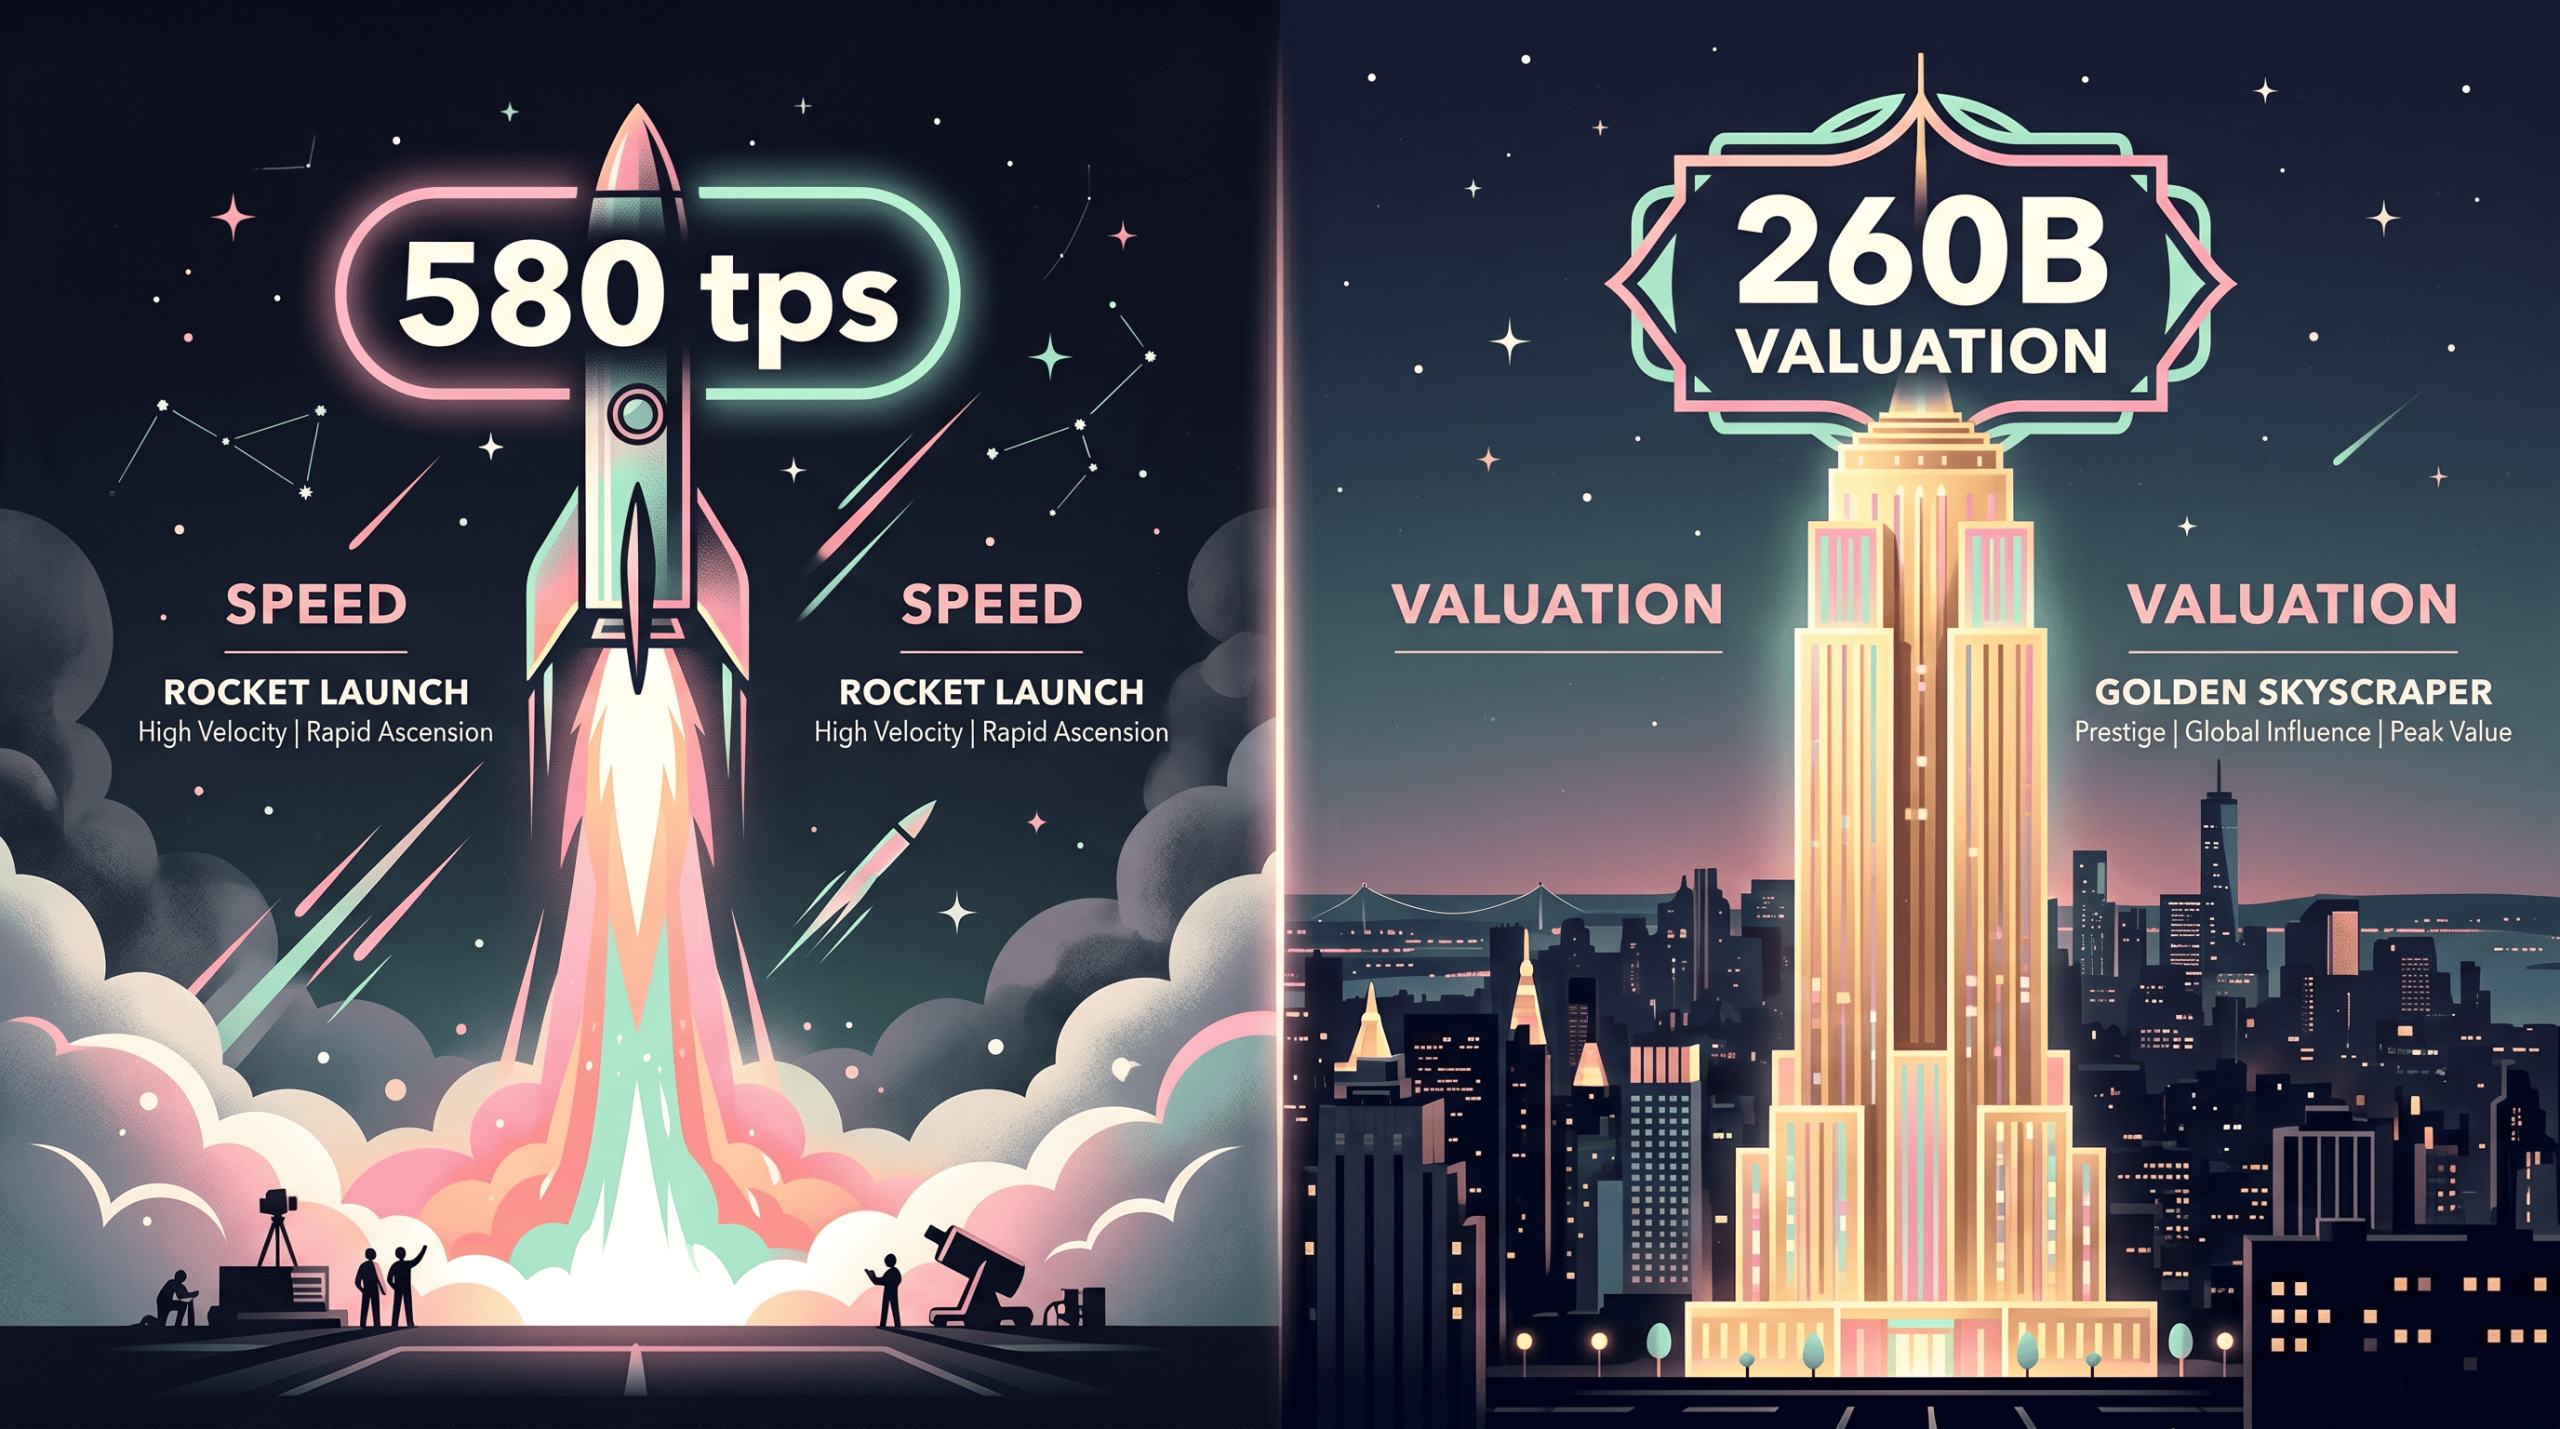
5 月 27 日,两个数字——一个关于速度,一个关于金钱——同时刷新了中国 AI 的天花板。
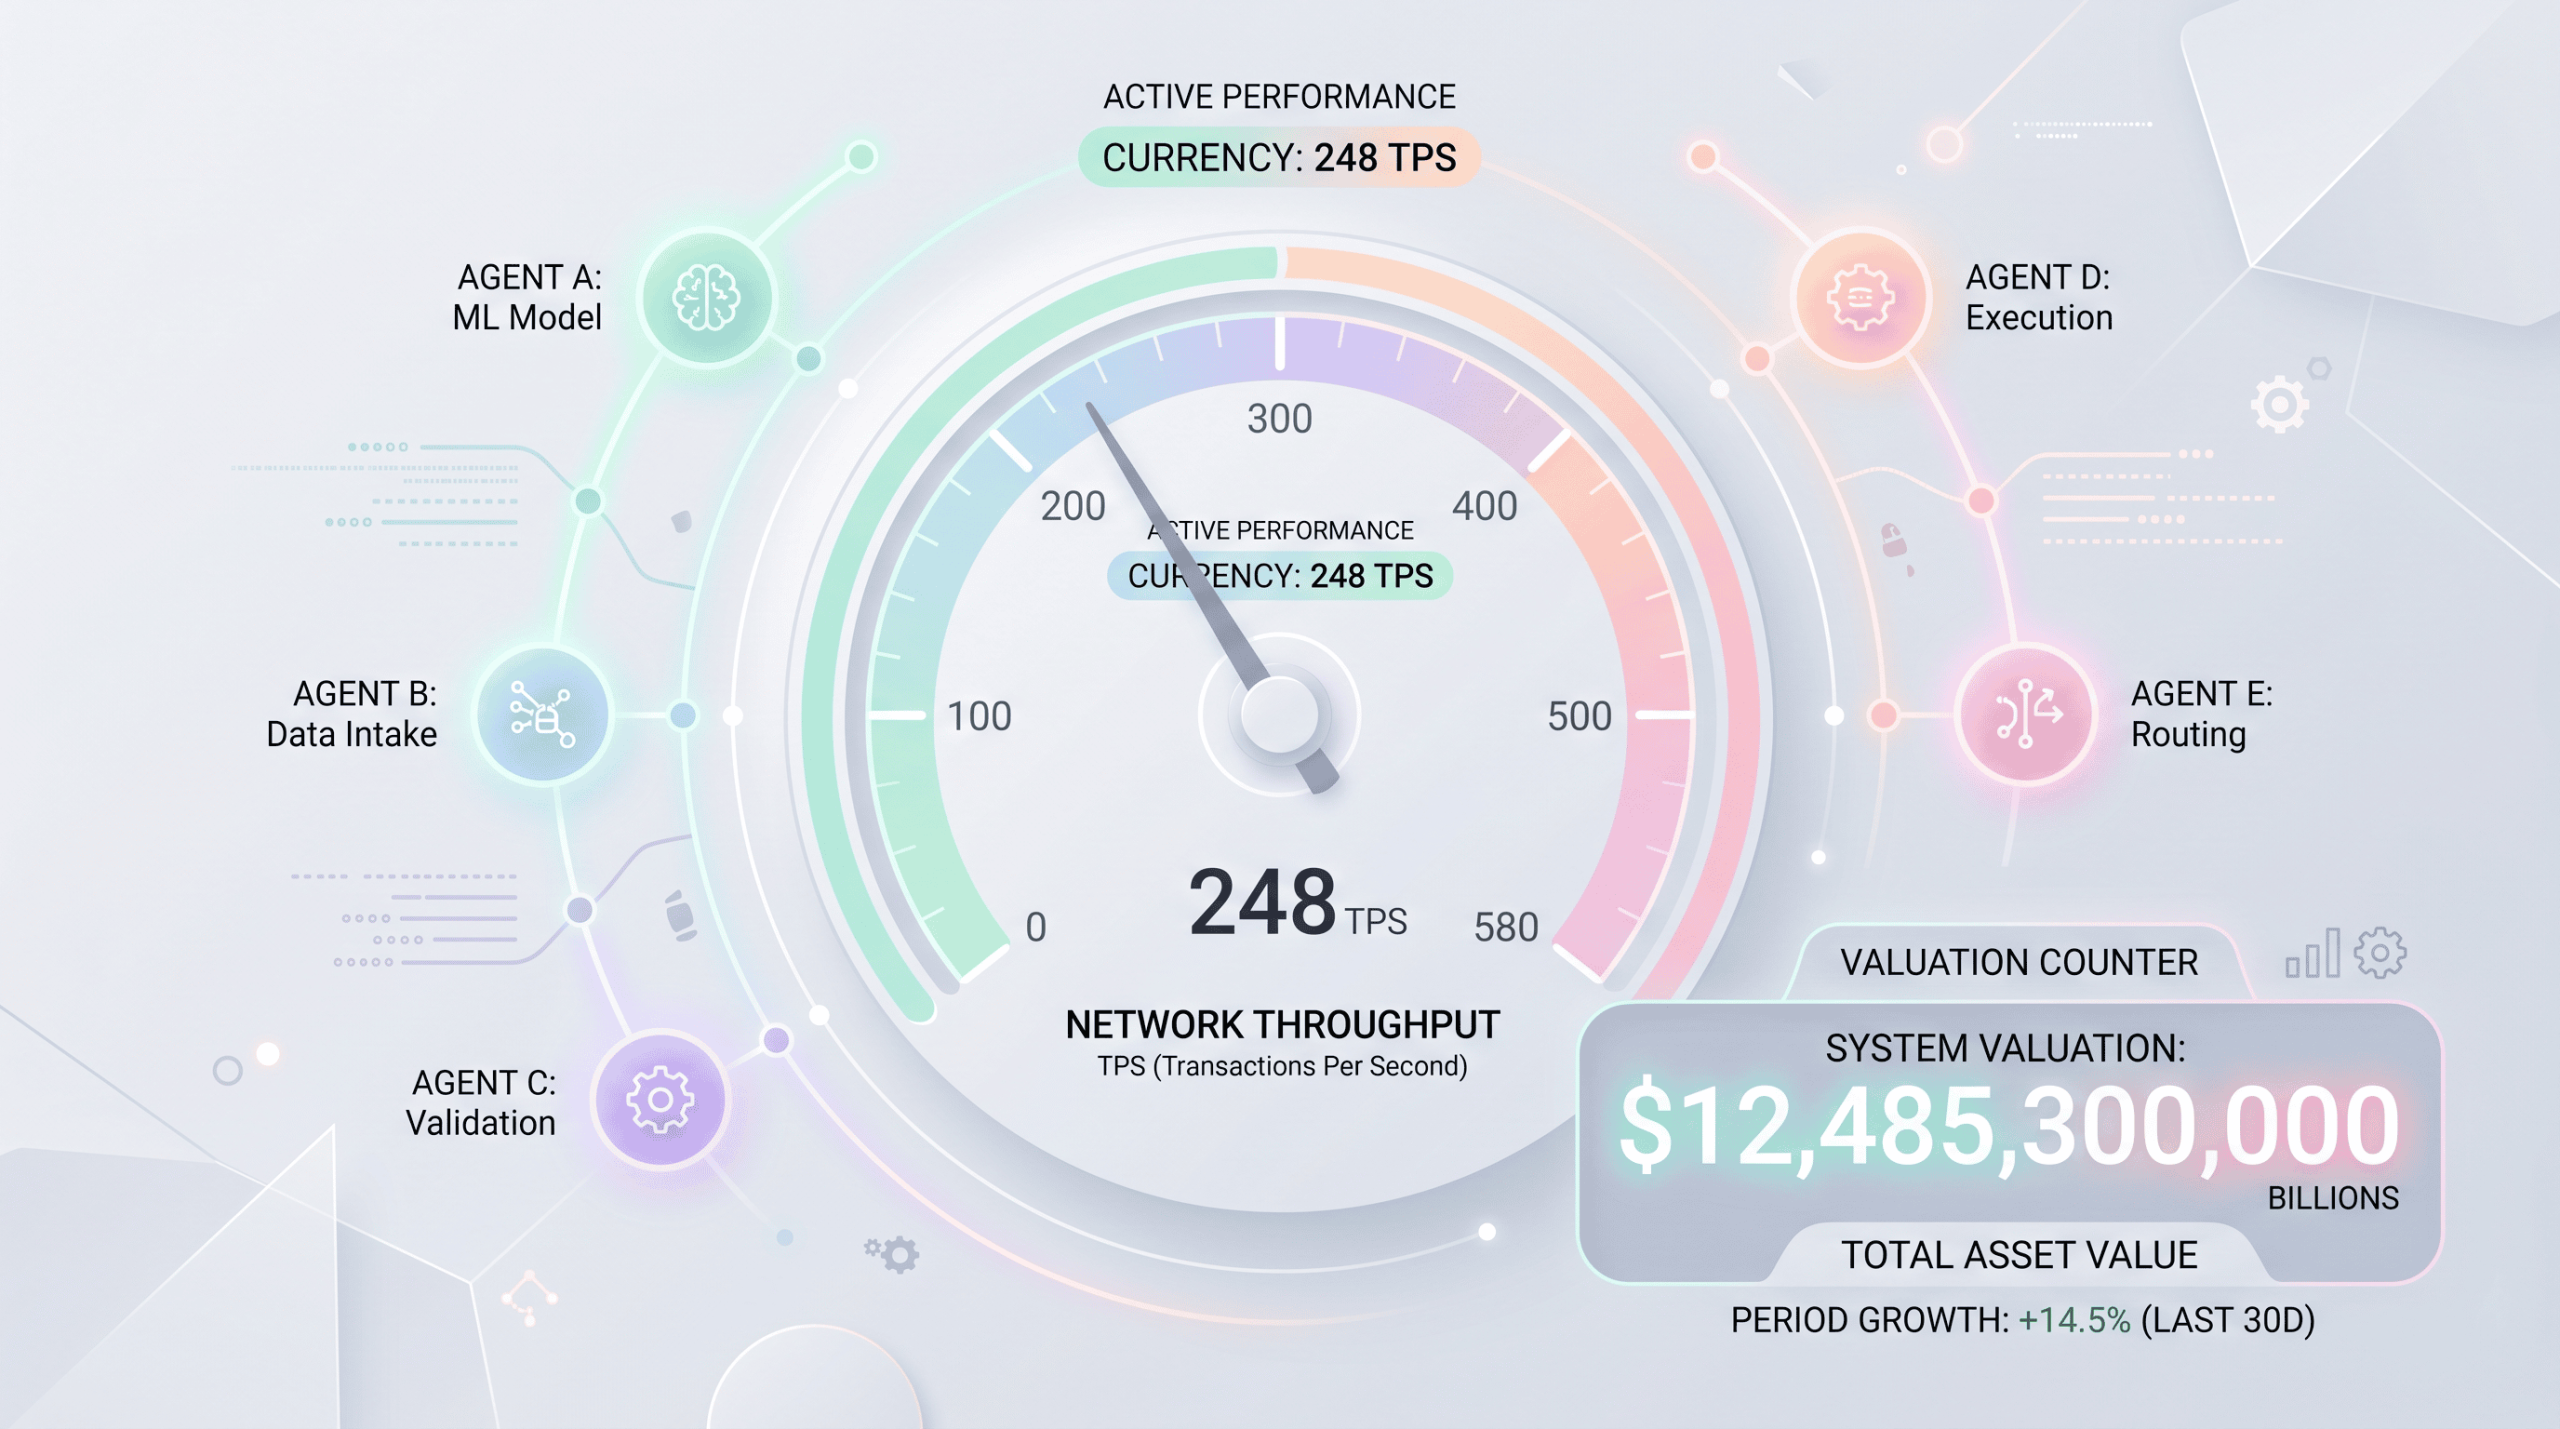
Qwen 3.5 跑出 580 tokens per second。 在 TokenSpeed 推理引擎上,针对 Agent 工作负载。这个速度由通义千问推理团队、Lightseek Foundation 的 TokenSpeed 团队、NVIDIA 和 Mooncake 联合实现,并采用了 FlashAttention-4(FA 4)优化。
Cognition 估值 260 亿美元。 Devin 的母公司完成超 10 亿美元融资,Lux Capital 和 General Catalyst 领投。年化收入 4.92 亿,企业用量年初至今增长超 10 倍。
来源:X: Alibaba_Qwen / X: swyx
一攻一守,两条战线
Qwen 是在攻——用开源模型的性价比和速度去蚕食闭源模型的份额。580 tps 不只是 benchmark 数字,它是开发者体验的核心指标。
Cognition 是在守——用商业化的深度来证明 AI 编程不是烧钱实验,是有真实付费意愿的生意。两件事共享同一个叙事:中国 AI 正在两条战线上同时证明竞争力。
580 tps 的技术细节
FlashAttention-4 在注意力计算上做了显著优化,特别适合 Agent 大量短序列推理场景。NVIDIA 的参与意味着硬件-软件协同优化。Mooncake 在长上下文推理优化上有深厚积累,可能是推动 580 tps 的关键贡献者。
260 亿背后的信号
AI 编程 Agent 的企业市场正在经历一个转折点:Qwen 在模型层证明技术力,Cognition 在应用层证明商业力。
延伸阅读
RELATED
Posts
15 10 月
Llama Windows 上手:Windows 11 托盘一键跑本地大模型,不用命令行
一句话结论:Llama Windows 是 Hugging Face 2026 年 10 月 13 日发布的免费开源 Windows 11 托盘应用(MIT 许可),把 llama.cpp 包装成「点图标、选模型、下载、开聊」四步,不需要终端、不需要编译、不需要管理员权限。它同时在本机提供 OpenAI 兼容接口,适合第一次在自己电脑上跑开源模型的人,也适合想给脚本接一个本地模型的开发者。 AI 摘要 资源类型:免费开源软件(Windows 11 桌面应用)来源:Hugging Face 官方博客发布,代码在 GitHub ggml-org/Llama-Windows适合人群:想在 Windows 电脑上离线跑开源模型的普通用户、需要本地 OpenAI 兼容接口的开发者使用价值:自动安装和管理 llama.cpp,一键下载推荐模型,模型缓存与其他 Hugging Face 工具共享风险边界:项目很新(GitHub 87 星,2026-10-14 核查);官方博客和 README 给出的本地端口不一致,需以本机实际为准 资源信息 资源名:Llama Windows(代码仓库内名称...
12 10 月
HowToCook 程序员做饭指南:10 万星开源菜谱怎么用、怎么部署、怎么接 AI
HowToCook 程序员做饭指南是 GitHub 10.2 万星的开源菜谱库,372 道家常菜用量精确到克。本文讲清在线使用、Docker 本地部署、按食材找菜工具和 MCP 接入 AI 助手的方法与风险。
9 10 月
Sharp 图片预处理:给 AI 截图输入建立尺寸上限和独立输出
Sharp 图片预处理适合将人工选定的图片规则写进 Node.js 流程。本文包含官方安装渠道、平台要求、完整单图脚本和独立输出目录设计,说明尺寸上限、不放大小图、无损编码与缩放损失的区别。示例以静态 PNG 为起点,要求比较小字和识别退化,不覆盖原件,不保证压缩率,也不把像素限制当作完整上传安全方案。
9 10 月
Python jsonschema:给模型输出加一道可执行的数据合同
Python jsonschema 可以把模型输出的数据合同变成可执行检查。本文包含虚拟环境安装、官方包下载、完整校验脚本和四个正反样本,解释 required、额外字段、格式检查与语义真实性的区别,并说明跨平台运行和失败处理方法。适合信息提取与工具参数入口,不调用收费模型,也不把结构通过误写成业务正确或权限批准。
9 10 月
Promptfoo 上手:先用本地输出检查评测规则,再连接模型
Promptfoo 可用 Echo provider 检查变量、模板和断言,不必调用模型。本文给出独立目录安装方法、Node 版本要求、两条合成样本配置及预期通过和失败路径,说明本地报告、锁文件、外部评分和隐私风险。适合已有固定任务的开发者建立回归入口,不提供未执行的准确率成绩,也不把本地工具与免费模型额度混为一谈。
9 10 月
Mermaid CLI:把 Agent 流程图源文件放进可重复的构建流程
Mermaid CLI 能把流程图源文本转为可构建的文档资产,适合经常随 Agent 代码变化的审批与异常流程。本文提供官方源码、项目内安装、引擎检查、完整示例和 SVG 导出命令,说明浏览器依赖、中文字体、版本锁定及 CI 隔离边界。它不是在线编辑器的重复介绍,也不把图像导出成功当成业务流程已经正确实现。
8 10 月
jq 日志整理:把 AI 调用的失败与未知用量留在统计里
jq 调用日志整理可以帮助 AI 开发者识别重试、失败与缺失 usage,避免把未知用量误记为零。本文提供三个平台的官方安装路径、三行合成 JSONL、TSV 导出过滤器及任务去重统计,说明跨平台引号、内存限制和实际账单核对边界。不读取真实客户数据,不代替供应商结算,也不把调用次数当作成功任务数量。
8 10 月
剪映全平台教程合集:AI 赋能视频剪辑的入门资源包(Windows / macOS / iOS / Android)
剪映全平台教程合集:Windows、macOS、iOS、Android 四端一站式入门资源,覆盖安装包、使用教程、AI 字幕/配音/抠图实战,适合短视频创作者和自媒体运营。
24 9 月
DeepSeek Harness(dsh)开源:DeepSeek 把自家跑模型 benchmark 的 agent harness 直接放出来了
DeepSeek 把内部跑 V4-Flash benchmark 的 agent harness 以 MIT 协议开源,叫 DeepSeek Harness(dsh)。全插件化、模型无关、4 种 runtime 模式,开发者预览版可上手。
24 9 月
Google 发布 Gemini 3.8 Flash TTS / Flash-Lite TTS:把 Gemini Audio 系列拉到「商用级别」的最后一公里
Google 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS:基础 Gemini 3 Pro、最长 64K token 音频输出、AI Studio 新增语音设计工作区,与 ElevenLabs、OpenAI Voice Engine 正式同台竞争。


评论 (2)
[…] 中国 AI 的一攻一守:Qwen 3.5 跑出 580 tps,Cognition 估值 260 亿美元 […]
[…] 中国 AI 的一攻一守:Qwen 3.5 跑出 580 tps,Cognition 估值 260 亿美元 […]
评论被关闭。