一句话结论:阿里通义团队 9 月 27 日在 arXiv 发布 QwenGyre 论文,这是一套专门训练「一次要跑几个小时」的 AI Agent 的在线强化学习框架。用在 2.4 万亿参数的 Qwen 3.8 上,48 步训练让 NL 2 RepoBench 得分从 52.5% 升到 58.5%,耗时 75.42 小时,比 Async 方案的 134.55 小时快 1.78 倍。不过截至 2026-10-14,我们没有找到公开的代码仓库,部分报道说的「开源」目前只指论文公开。
QwenGyre 是阿里通义团队提出的端到端在线强化学习框架,用来训练「超长程」(论文写作 xLong-horizon)AI Agent。所谓超长程,是指一次任务执行要持续几个小时、和环境交互数百轮、单条轨迹接近 100 万 token,比如让 Agent 从一段需求描述出发写出整个代码仓库。
它值得关注有两个原因。第一,这是通义少见地公开旗舰模型 Qwen 3.8 2.4 T 的后训练细节,说明国产厂商的竞争重点已经从「模型多大」转向「Agent 能连续干多久的活」。第二,论文的训练方式直接把 Claude Code 这类现成的 Agent 框架当作黑盒,不改写它们的控制流程,这意味着训练环境和用户实际使用的环境是同一套工具。想了解 Qwen 在国产模型里的整体位置,可以参考我们的 2026 国产大模型选型指南。
QwenGyre 论文把长程 Agent 强化学习的难点归结为两类:GPU 空等和样本重复。
GPU 空等来自执行时长差异太大。在 Qwen 3.6 122 B 的 NL 2 RepoBench 实验中,单次执行平均 1.93 小时,单个问题平均 2.96 小时,9.51% 的问题至少要跑 4 小时;换成 Qwen 3.8 2.4 T 后,至少跑 4 小时的问题占比升到 61.1%。传统的 Colocate 方案要等所有执行结束才能开始训练,GPU 只能干等最后几个慢任务;Async 方案把 GPU 固定分成推理池和训练池,又会出现一边忙、一边闲的情况。
样本重复来自 Agent 的工作方式。上下文快满时,框架会压缩历史;遇到子任务时,会另开子 Agent;失败了会重试。一次执行因此变成一棵有很多分支的树。如果把每条分支都展开成独立样本,公共前缀会被重复训练很多次,训练成本随之翻倍。
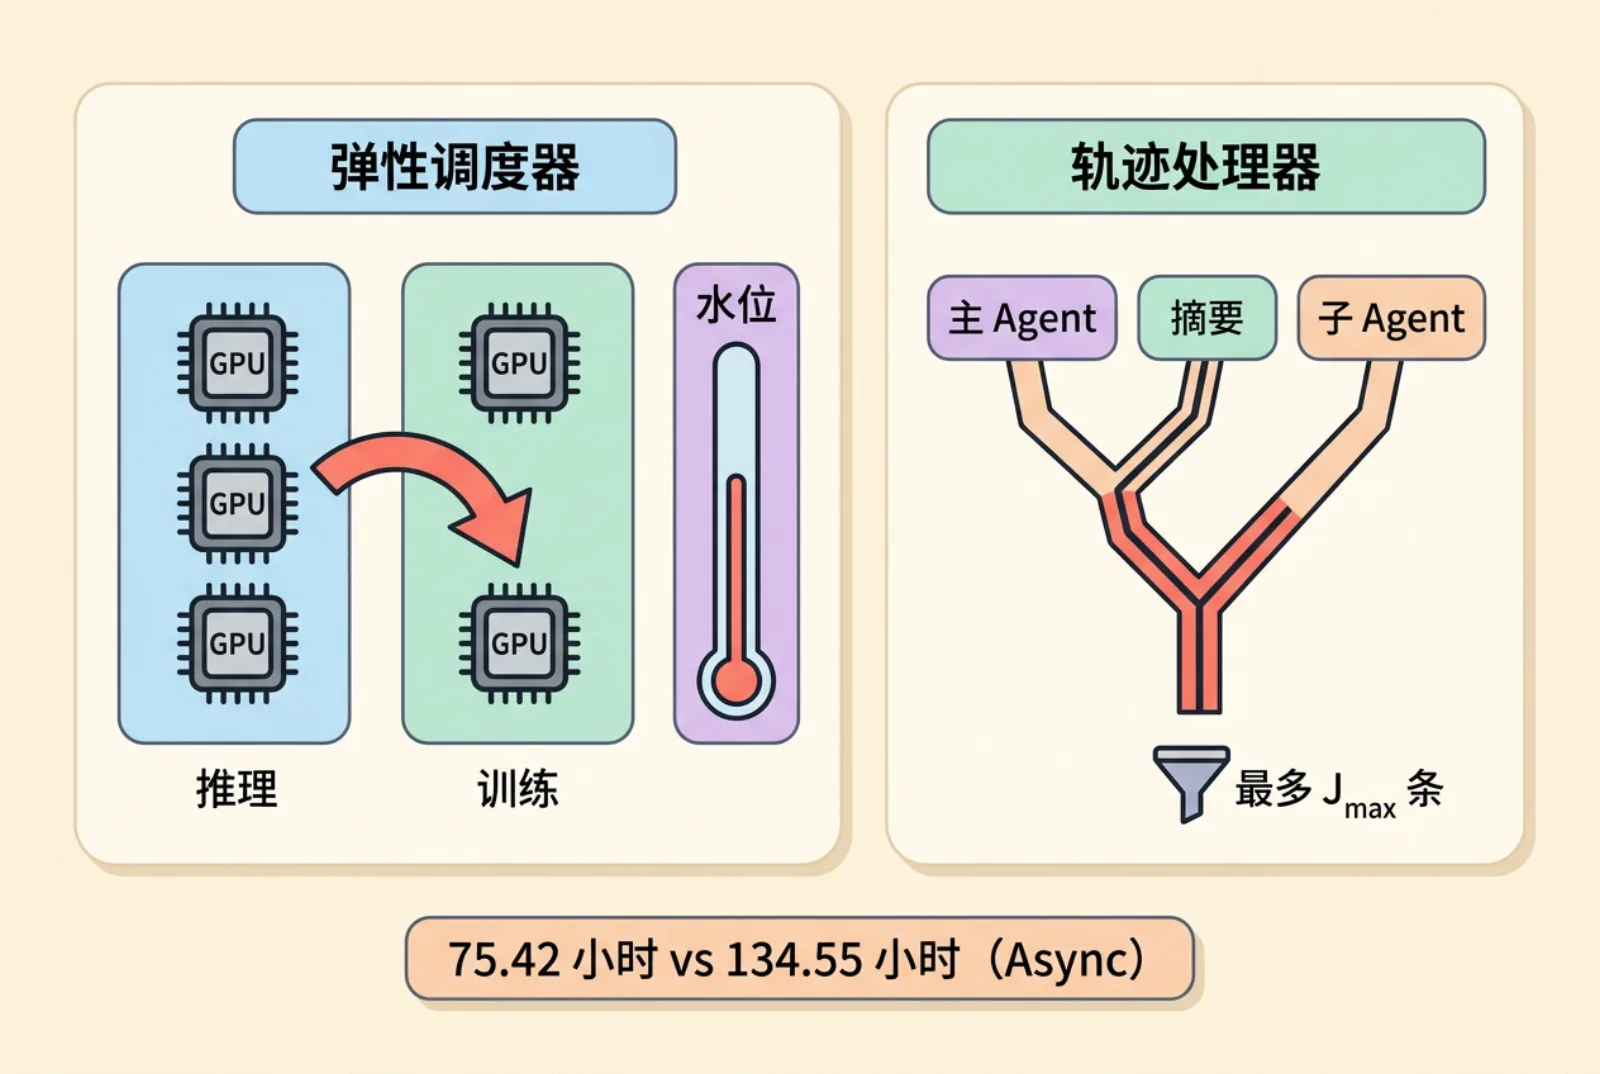
QwenGyre 的第一个组件是弹性调度器。它把 GPU 划分成若干「弹性单元」,每个单元既可以跑推理(rollout),也可以承载一份完整的训练副本,角色随时可以切换。
调度器持续跟踪还没跑完的执行数量,论文称之为「水位」。水位下降、剩余推理能力足够覆盖未完成任务时,就把多出来的单元转去训练。切换时,正在进行的模型请求会被转发到其他推理引擎,KV 缓存通过 RDMA 迁移过去,Agent 的执行不会被打断。新加入训练的单元会从核心单元拉取参数快照,中途加入当前批次,而不必等下一批。
论文还采用「流式训练」:已经完成的问题先进入训练,不等整批凑齐。在消融实验里,单是流式训练就能把 Async 方案的耗时减少 11.6%,但论文认为固定资源划分才是根本瓶颈,所以要和弹性调度配合使用。
第二个组件是轨迹处理器,目标是把一次分支繁多的执行变成数量有上限、不重复的训练样本。
具体做法分三步。第一步,代理层逐条记录模型请求的精确输入、输出 token 和概率,组织成共享前缀的「轨迹树」,每段输出都保留它当时真实看到的上下文。第二步,执行结束后由评估器给整次执行打分;即使超时,已经完成的部分进度也会被评估,不会整条作废。第三步,按角色优先级挑选最多 J_max 条轨迹参与训练:主 Agent 的任务轨迹优先,其次是摘要轨迹,然后才是子 Agent。
为了避免「分支多的执行权重更高」,损失函数先在单次执行内部按 token 平均,再在批次内按执行平均;共享前缀里的同一段输出只计算一次。这样做的好处是成本有上限,而且不会因为某次执行重试次数多,就被模型过度学习。
旗舰模型实验:Qwen 3.8 2.4 T,每条轨迹约 70 万 token,48 步训练后 NL 2 RepoBench 从约 52.5% 升到 58.5%,提升 6.0 个百分点。完成 48 步,QwenGyre 用了 75.42 小时,Async 用了 134.55 小时,Colocate 用了 91.47 小时,端到端加速分别是 1.78 倍和 1.21 倍。
在 Qwen 3.6 122 B 上,论文在 NL 2 RepoBench、DeepSWE、TerminalBench 三类任务上做了对比:同等 GPU 预算、同等调度延迟约束下,相对 Async 加速 1.38 到 1.78 倍,相对 Colocate 加速 1.21 到 1.85 倍,训练得分与基线相当。
读这些数字时要注意三点:
对模型团队来说,QwenGyre 回答了一个现实问题:Agent 任务越来越长以后,强化学习的瓶颈从算法转到了调度和数据工程上。小米 MiMo 此前也公开过自己的 RL 训练过程,可以对照阅读 小米 MiMo-V 2.6 开源与 RL 训练记录。微软的 Agent Lightning 同样把现成的 Agent 当黑盒来训练,两者思路相近,规模相差很大。
对普通开发者来说,这篇论文暂时不能直接拿来用:它没有公开代码,实验也动用了大规模 GPU 集群。更现实的影响在选型上。如果下一代 Qwen 在仓库级编程任务上兑现这类提升,写代码场景的模型排序可能会变,届时可以回到 国产大模型场景选型决策树 重新评估。长任务的计费方式也值得提前准备,把重试和失败任务记进同一本账 这篇文章里的记账方法同样适用于长程 Agent。
QwenGyre 论文中,Qwen 3.8 2.4 T 有 61.1% 的训练问题单次至少要跑 4 小时,每条轨迹约 70 万 token。短期看,QwenGyre 是一份基础设施层面的技术披露,不会立即改变用户手里的模型能力。中期看,它说明通义已经在用「几个小时、几十万 token 一条轨迹」的任务训练旗舰模型,长程编程和自主 Agent 很可能是下一代 Qwen 的主打方向。长期看,「训练时直接使用真实部署的 Agent 框架」这条路线如果被更多厂商采用,模型在 Claude Code、Codex 这类工具里的表现会和基准分数更一致。
截至 2026-10-14 没有。论文已在 arXiv 公开(编号 2609.33848),但我们在 GitHub 上没有找到对应的代码仓库,论文中也没有写明代码发布计划。部分媒体用「open sources」描述,指的是论文公开。
不是。QwenGyre 是训练框架,用来对 Qwen 3.8 2.4 T、Qwen 3.6 122 B 这类已有模型做强化学习后训练。它本身不能对话,也没有 API 可以调用。
和 Async 方案比较:48 步训练,QwenGyre 用 75.42 小时,Async 用 134.55 小时。和 Colocate 方案(91.47 小时)比,加速 1.21 倍。不同任务、不同配置下,加速区间为 1.21 到 1.85 倍。
不需要立即行动。更值得关注的是下一代 Qwen 发布时,它在仓库级编程和长任务上的实际表现,以及长任务的计费方式。届时再用自己的任务做一次对比测试。