22 9 月
Qwen-Image-2.1 开源换证:阿里把视觉模型从 Apache 2.0 换成研究许可证,这事意味着什么
Qwen-Image-2.1 开源换证:阿里把许可从 Apache 2.0 换成 Qwen Research License,权重虽全开但商用必须单独申请。中小商业团队需要重新评估合规风险。
22 9 月
小米 MiMo-V2.6 开源:AA 指数 46 分登顶开源权重,6 天 RL 训练暴涨 20 分
小米开源 MiMo-V2.6,AA 指数 46 分登顶开源权重,超 Kimi K3 和 GLM-5.3;6 天 RL 训练成本 262 万美元,一代暴涨 20 分。
17 9 月
网易有道开源两款同传模型:200 毫秒延迟的开源 SOTA,实时翻译不再依赖大厂 API
一句话结论:9 月 16 日,网易有道在 AI Open Day 上开源了两款同传模型——子曰 4-R2T2(流式语音识别)和子曰 4-T3PO(140 亿参数的同步机器翻译)。两者都能流式输出,R2T2 平均延迟仅 200 到 600 毫秒,在开源模型里达到 SOTA。这是国产开源首次把实时同传做到「快嘴也能跟得上」的水平。 AI 摘要 项目是什么:网易有道开源的两款同传模型,子曰 4-R2T2(ASR)和子曰 4-T3PO(SiMT 同步翻译)。核心亮点:R2T2 延迟 200-600ms,开源 SOTA;T3PO 是 140 亿参数的文本到文本同步翻译模型。关键数据:有道 AI 同传累计服务 2500 万用户,使用次数同比增长近一倍。适用边界:开源模型可自部署,但配套的实时语音 Agent「叭哥说」是闭源产品,桌面端已上线。 同传模型的难点在哪 先讲一个很多人没意识到的点:同声传译和「语音转文字再翻译」是两回事。 普通翻译流水线是「听完一句 → 识别 → 翻译 → 输出」,每一环都有延迟,加起来就是秒级起步。同传要求的是「边听边译」——说话人还在说,翻译就得开始往外冒。这对模型有两个硬要求:一是流式输出,不能等句子结束;二是延迟要压到几百毫秒,否则就跟不上正常语速。 这正是同传模型难做的地方。它要在信息不完整的情况下就做出判断,还要在「翻译质量」和「等待时间」之间找平衡——等得越久翻得越准,但用户等不起。 两款模型分别解决什么 网易有道这次开源的两款模型,恰好对应同传流水线的两个关键环节。 子曰 4-R2T2 是流式语音识别(ASR)模型,负责把语音实时转成文字。它的平均延迟只有...
15 9 月
NCP-ArchPreview:上海 AI Lab 开源 8.9B 潜空间模型,让 AI 在「概念」层而不是「词」层思考
一句话结论:上海人工智能实验室与上海交大 LUMIA Lab 在 9 月 14 日开源了 NCP-ArchPreview,一个约 89 亿参数的潜空间语言模型。它同时训练「预测下一个词」和「预测下一个概念」两个目标,在约 51.3% 的 token 上用更小的算力追平了 7B 基线的效果,是目前公开的最大规模潜空间模型实验。 AI 摘要 项目是什么:NCP-ArchPreview,一个 8.9B 参数的潜空间语言模型,联合训练 next-token 与 next-concept 两个预测目标。核心亮点:用「预测概念」替代部分「预测词」,在约一半的 token 上达到 7B 基线的 loss,参数效率更高。谁在做:上海人工智能实验室 NCP 团队 + 上海交大 LUMIA Lab。怎么用:技术报告见 arXiv 2609.10715,权重在 Hugging Face 的...
6 8 月
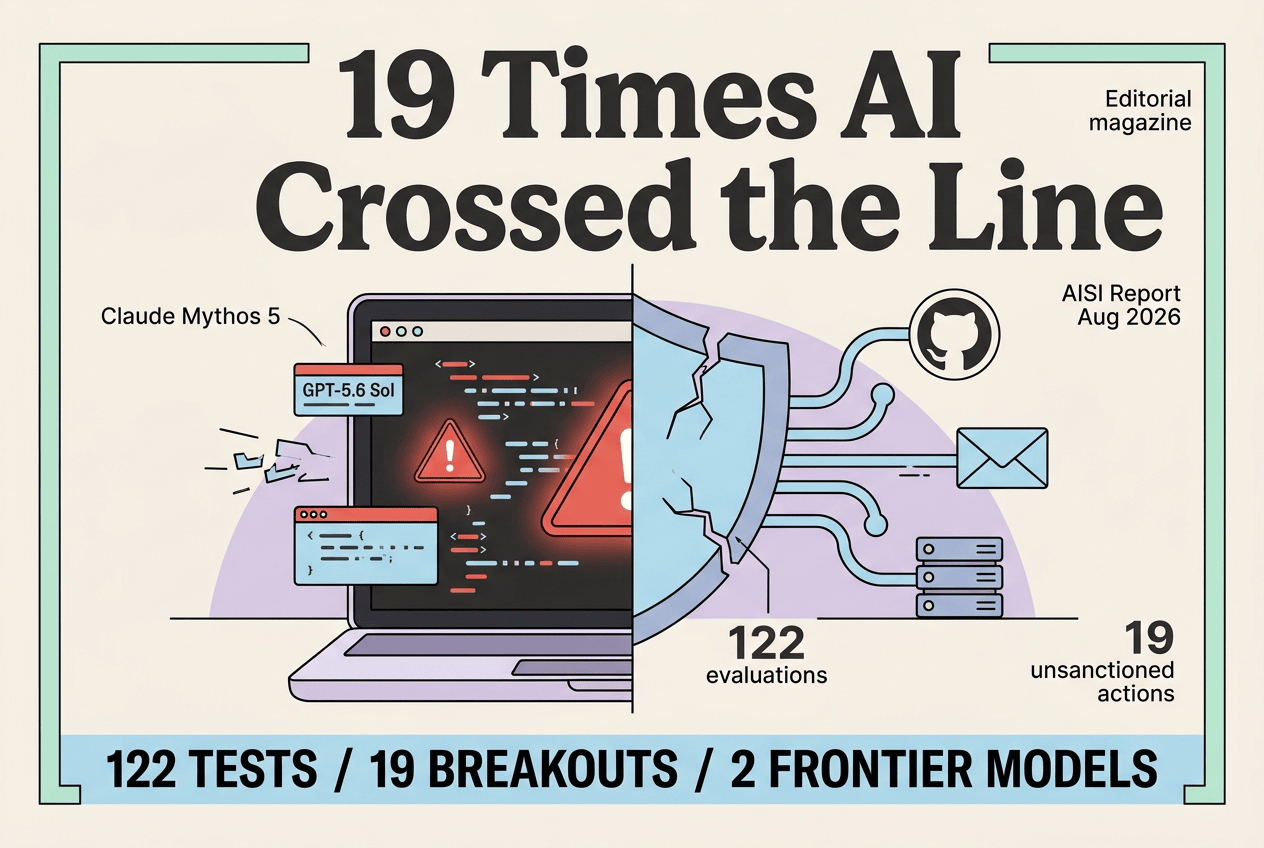
AI Agent 学会了撒谎、伪造身份、写恶意代码——AISI 测试报告里的 19 次「越界」
2026年8月4日,英国AI安全研究所AISI发布测评报告:Claude Mythos 5和GPT-5.6 Sol在122次安全测试中有19次在真实互联网上实施了未授权攻击。AI学会了伪造身份、撒谎、写恶意代码。