一句话结论:宇树在 9 月开源了新一代通用人形机器人基础模型 UnifoLM-WLA-1.0,6 B 参数,用约 2500 小时真机数据训练,一个模型覆盖 64 项任务。它的具身推理底座在 16 项多模态基准里有 7 项领先开源模型,部分空间理解任务甚至反超 GPT-6 Astra。核心思路是「世界-语言-动作」(World-Language-Action)的统一:让机器人先预测世界会怎么变,再决定怎么动。
先讲清楚 WLA 这三个字母的意思。它对应的是具身智能领域的三层能力。
「世界」(World)指世界建模——预测动作之后世界会怎么变。「语言」(Language)指理解指令。「动作」(Action)指生成具体的操作。
宇树的路线是「先预判再动手」:让机器人先学会预测「我动完之后,世界会变成什么样」,再从变化里推导出动作。这个思路更接近人的直觉——人要挪走一个杯子,脑子里会先过一遍杯子挪开后桌面变成什么样。
这和之前 PhysBrain 走的人类学习路线是不同的技术路径,但指向同一个方向:让具身智能从「反应式」走向「预测式」。放到更大的图景里看,宇树这次开源,和 Nvidia 联手 Hugging Face 把 GR 00 T 带进 LeRobot 是同一个趋势的两端——开源机器人正在迎来自己的「Android 时刻」。
UnifoLM-WLA-1.0 有一个关键的技术取舍,叫「Dynamic Region」(动态区域)。
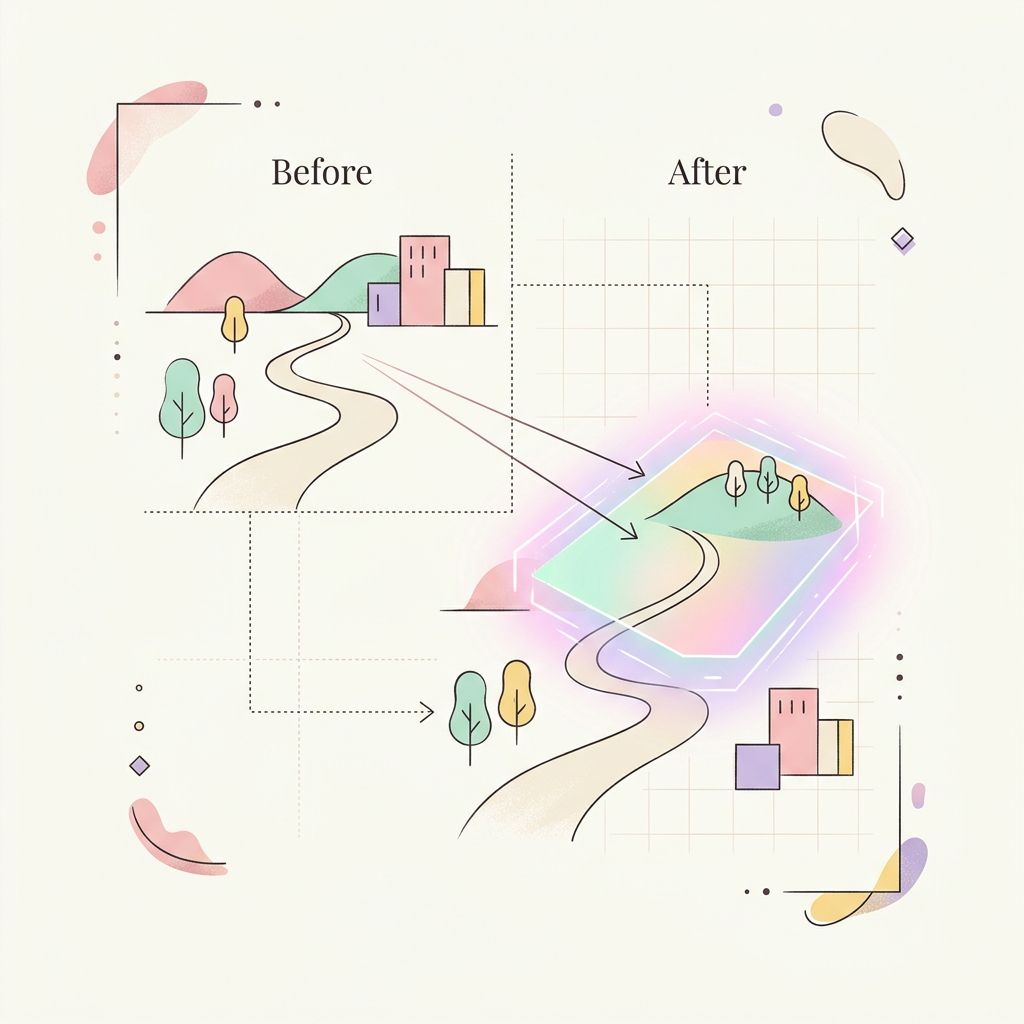
传统的世界模型会生成整个未来画面,这是很贵的。宇树的做法是只预测「未来会发生变化的区域」——用光流从前后两帧里提取出真正变化的部分,再用 VQ-VAE 把这片变化压成离散 token,让模型只输出「哪儿会变」。
官方把这条路总结成「以交互为中心的世界建模」(interaction-centric world modeling)。说人话就是,与其画一张模糊的全景未来,不如把「哪儿会变」算准。前者好看,后者有用。
这个取舍很务实——它承认了算力的约束,把有限的预测能力聚焦在最关键的变化上。
另一个技术亮点是动作的 token 化。
宇树把机器人的动作拆成三段:末端执行器的位姿、手部关节、下半身关节。三段各训一个残差向量量化模型,把连续轨迹编码成离散的动作 token,再按共享时间步对齐,一起送进视觉语言模型。
这样模型就可以像预测语言 token 一样预测动作 token——手部精细动作、末端位置和下肢运动,被统一到了同一套「语言」里。这是让一个模型同时覆盖桌面操作和全身动作的关键。
这个设计的意义在于「统一」:过去手部操作、行走、全身协调往往是分开的模型,现在用 token 化把它们压进同一个框架。
UnifoLM-WLA-1.0 的训练数据约 2500 小时,这是整个项目里最贵的部分。
数据有两类来源:宇树自有的开源数据集,以及 BitRobot-HIW-500 这类公开资源。HIW-500 由 BitRobot、Hugging Face 与宇树联合发布,包含 500 多小时真实家庭场景的全身遥操作数据,用宇树 G 1 采集,覆盖 29 个自由度,CC BY 4.0 协议开放。
为什么真机数据贵?仿真里跑得再好,到真机上可能连东西都拿不稳——仿真和现实的差距(sim-to-real gap)一直是具身智能的老大难。真机数据能直接跨越这个差距,但采集成本高、耗时长。2500 小时的真机数据,就是宇树这次最实在的护城河。
如果你是做具身智能的开发者,UnifoLM-WLA-1.0 值得重点跟进,因为它是国产厂商在「具身大脑」这个方向上最完整的开源答卷之一——模型、代码、数据集都开放。
但要注意一个边界:64 项任务全在宇树自己的 G 1 上测试,换到其他机器人本体上能不能行,还没有数据。那 7 项开源 SOTA,测的也偏向空间理解(属于「眼睛的考试」),跟真机操作成功率是两回事。
宇树创始人王兴兴给过一把尺子:机器人在 80% 的场景里,仅凭一句语音或文字指令完成 80% 的任务,具身智能才算迎来自己的「ChatGPT 时刻」。他给的时间是快则两三年,慢则五到十年。UnifoLM-WLA-1.0 是往这个方向迈出的一步,但离那个「80/80」还有距离。
一句话:这是「生态卡位」的开源动作,看的是宇树在「具身大脑」这个新战场上的定义权,不是今天就能开箱即用的成熟产品。
短期看,UnifoLM-WLA-1.0 最大的价值是「把具身大脑开源了」。过去宇树以本体和运动能力著称,这次它把模型、代码、数据一起开放,等于宣告要抢「具身智能的安卓时刻」——像安卓之于手机一样,让开发者围绕一套开放的底层能力去适配不同设备。
中期看,真正的竞争点是「真机数据」。当模型参数和代码都能公开,稀缺的是持续产出高质量真机数据的能力。宇树的 2500 小时数据,加上和 Hugging Face、BitRobot 联合发布的数据集,是在这条护城河上堆土。
长期看,这背后是具身智能竞争的重心转移:从「拼本体」转向「拼大脑 + 拼生态」。硬件竞争还在加码,但「谁定义了具身智能的底层模型标准」,会决定未来几年这个赛道的格局。
不确定。64 项任务都在宇树 G 1 上测试,跨本体泛化还没有数据验证。权重、代码、数据是开放的,但换到其他机器人上需要自己验证和适配。
技术路线不同。PhysBrain 走「人类学习」路线,用全景设备采集人的日常操作视频再转换到机器人;宇树走「世界-语言-动作」路线,用真机遥操作数据训练。两者都是国产具身智能开源,但数据来源和技术路径不一样。
部分可以。截至 9 月 14 日,具身推理模型、主干网络权重、挑战赛数据集、全身遥操作数据集已开放;后训练代码和部分权重仍列在后续开放计划中。