一句话结论:DeepSeek 用一套新架构把 V 4-Pro 这个自家旗舰直接干退役了——V 4.1-Flash 在多个 Agent 基准上反超 V 4-Pro,激活参数却只有它的六分之一,9 月 14 日起 V 4-Pro 请求会自动路由到新模型。
DeepSeek 在 9 月 10 日开源了 V 4.1-Flash,一个 552 B 参数的 Mixture-of-Experts 模型,权重放在 Hugging Face,MIT 协议。官方同步在 API 文档里宣布:V 4.1-Flash 已经在性能、成本、速度、总耗时上全面超过 V 4-Pro,所以计划让 V 4-Pro 有序退役。
时间点很明确。从 9 月 14 日中午 12 点(北京时间)开始,所有指向 deepseek-v4-pro 的请求都会被路由到 V 4.1-Flash,按 Flash 的价格计费。也就是说,如果你还在用 V 4-Pro,一周后你的代码不用改,但背后跑的是新模型。
这个发布时间也不是偶然。DeepSeek 正在筹备科创板 IPO,在路演前拿出一套「效率碾压自家旗舰」的架构,是很直接的信号。
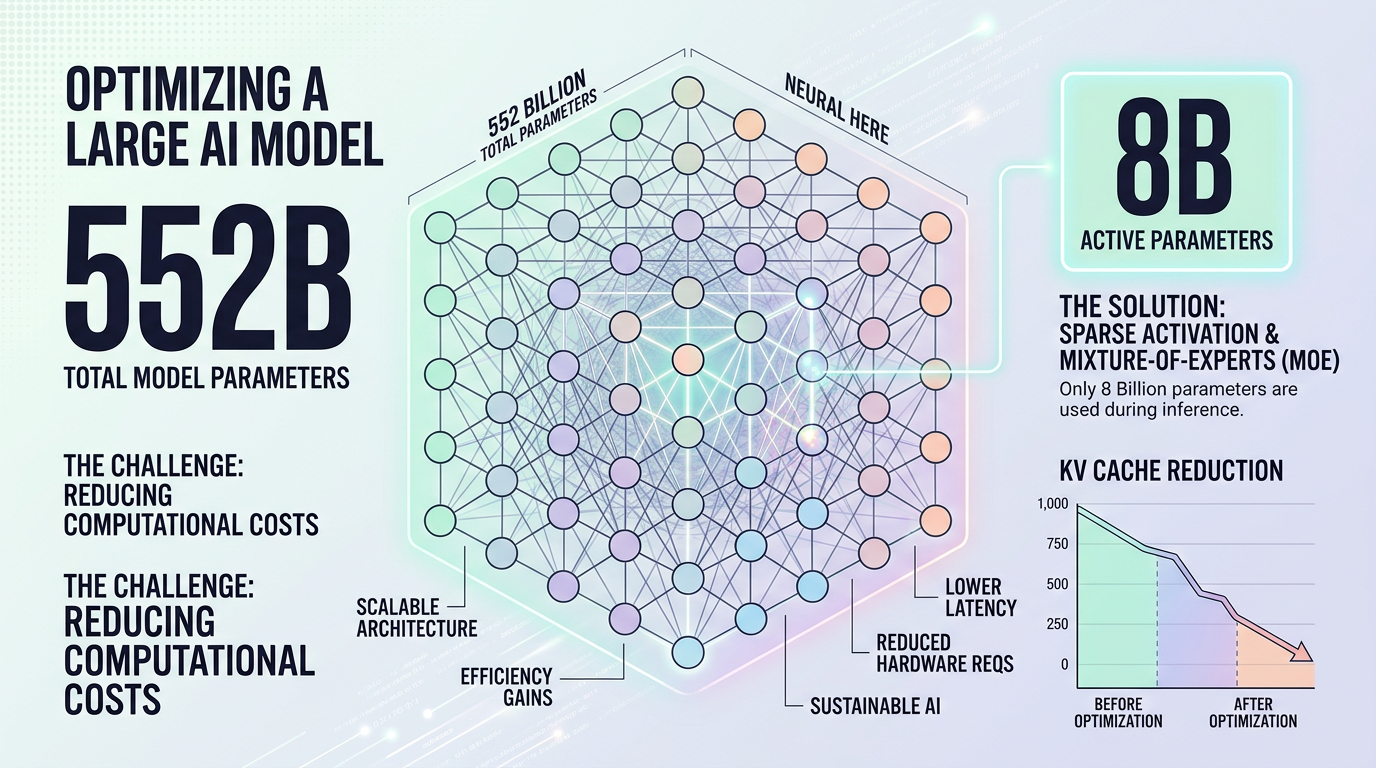
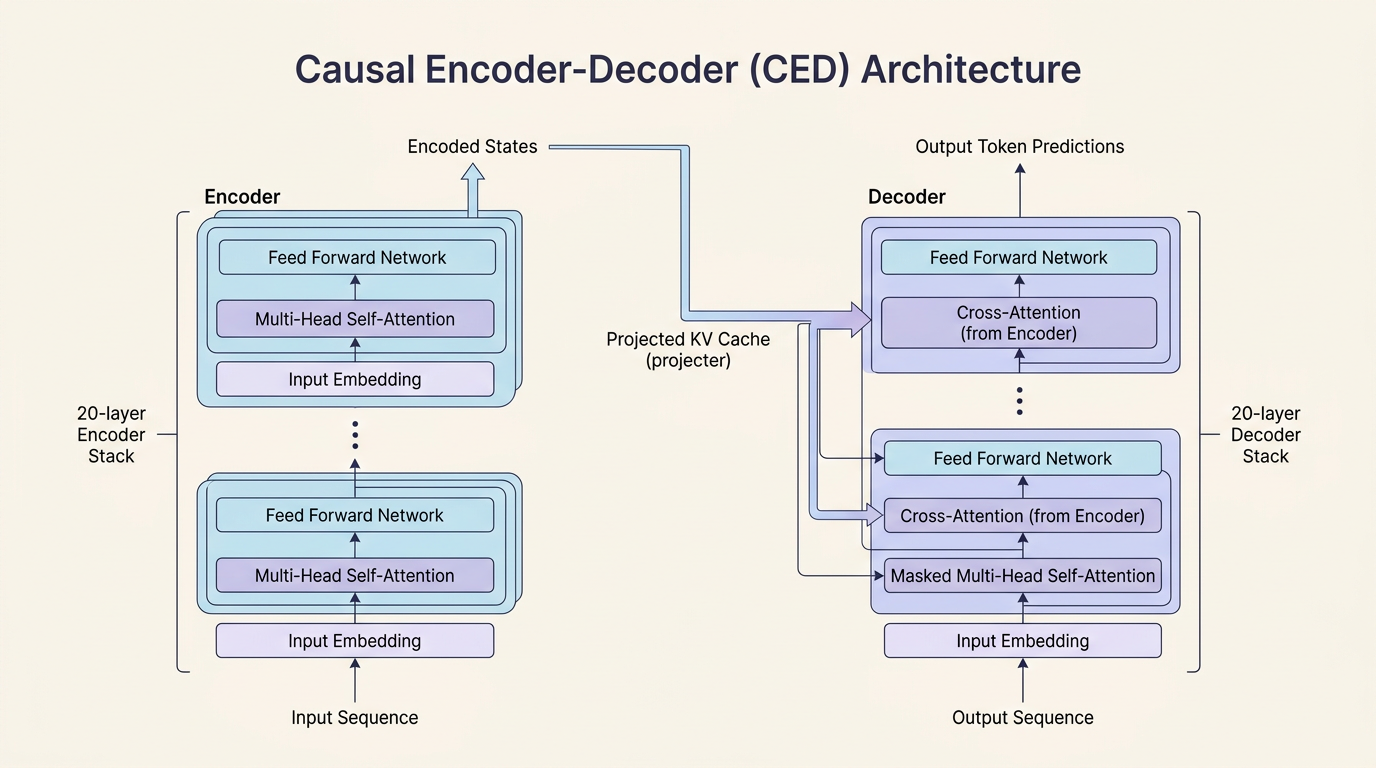
V 4.1-Flash 的核心变化是架构,叫 Causal Encoder-Decoder,简称 CED。传统 MoE 模型每次推理要激活的参数量,是成本的直接来源。V 4-Pro 激活 49 B,V 4.1-Flash 只激活 8 B(prefill 阶段)和 16 B(decode 阶段)。
具体做法是把 40 层 Transformer 拆成两段:20 层因果编码器加 20 层解码器。解码器的 KV cache 直接投影自编码器最后一层的隐藏状态,而不是每一层各自算一遍。再加上 SWA Bounded Replay 和 Compressed Sparse Attention 2,把 KV cache 的持久化占用砍到了 V 4-Flash 的约八分之一。
对开发者来说,这组数字翻译成人话是:输入密集型的 Agent 工作负载,尤其是要反复读长文档的场景,成本会明显下降。官方给的最直观对比是——按 token 计算的 KV cache 大小,V 4.1-Flash 是 V 4-Flash 的四分之一,是 V 1 的四百三十七分之一。
看基准测试要冷静。V 4.1-Flash 不是全面碾压,是有选择地赢。
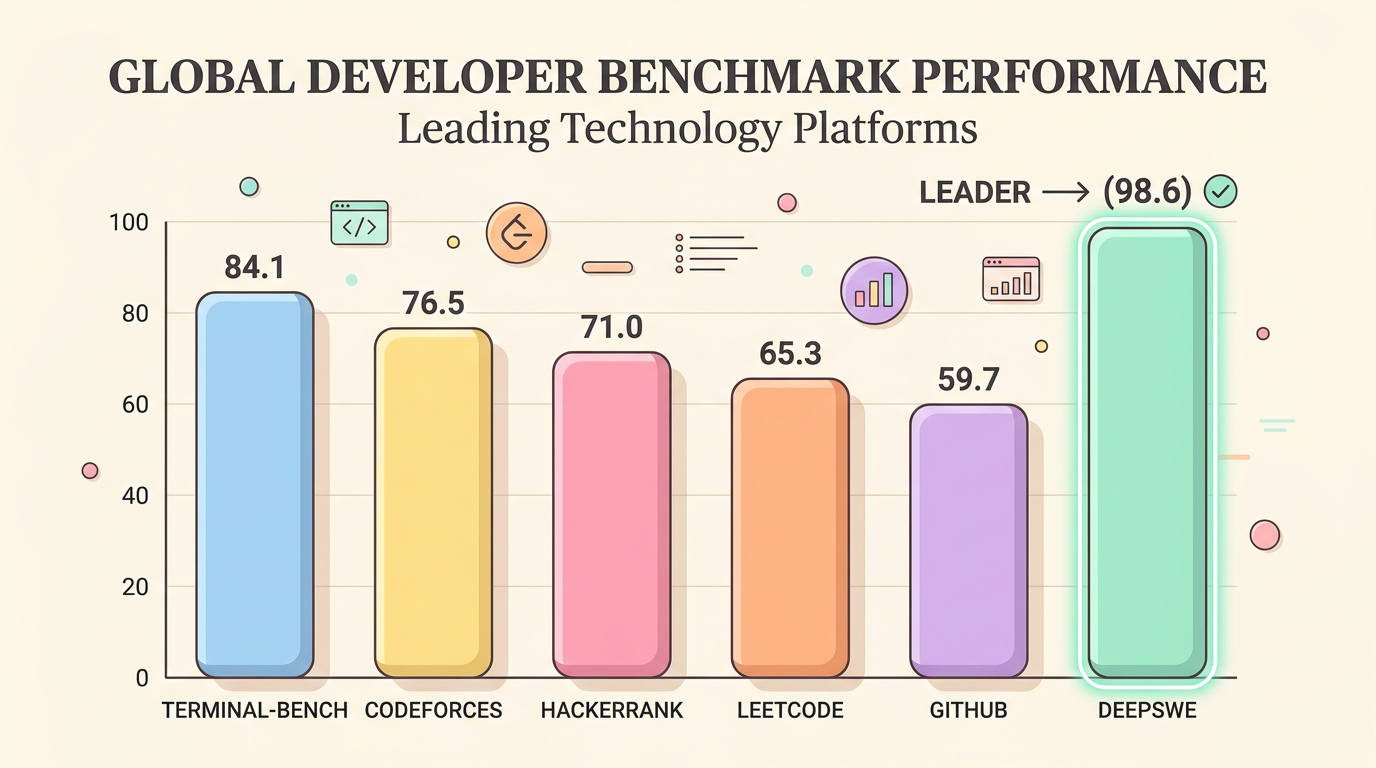
赢的地方集中在 Agent 和代码:DeepSWE v 1.1 的 Resolved 分数 74.2,超过 V 4-Pro 的 62.7,也超过 Opus-5.0 的 74.0;Terminal-Bench 2.1 拿到 90.6,是列表里最高的;Codeforces 评分 3471,同样是最高。这几项说明它在真实软件工程任务上确实有东西。
但也有一些指标是退步的。MGSM 从 V 4-Flash 的 85.7 掉到 80.2,MathArena Apex 虽然和 Kimi K 3 打平 65.6,但和 V 4-Pro 的 65.3 差不多。HLE 的 36.8 也低于 V 4-Pro 的 42.7。翻译成结论:这代 Flash 更偏「干活」而不是「刷分」,Agent 和代码是主战场,纯推理和数学不是它最亮的地方。
V 4.1-Flash 的发布,让「Flash 系列反超 Pro 系列」这件事在国产模型里又发生了一次。之前智谱的 GLM-5.3-Flash 也是走这个路线,用更小的激活参数打出了接近甚至超过上一代旗舰的表现。
放到 国产大模型选型决策树那篇的判断框架里,这个趋势在强化一个结论:选型看激活参数和单位成本,比看总参数量更有意义。552 B 的 V 4.1-Flash 论体量比 284 B 的 V 4-Flash 大,但激活参数反而从 13 B 降到了 8 B,这中间的效率提升才是关键。
对开发者最实际的影响是迁移成本。9 月 14 日之后 V 4-Pro 自动路由到 V 4.1-Flash,意味着你不需要改 API 端点就能拿到新模型。但如果你在跑本地推理,552 B 的权重对硬件要求并不低——官方给的最低配置是 1 张 B 200 或者 2 张 H 100,FP 4 量化,这不是普通开发者一台机器能扛的。想跑轻量本地模型,48 GB Mac 上的 slotstream 那篇讲了更现实的方案。
短期看,这是一次漂亮的架构叙事。用 CED 架构把激活参数压下来,同时保住 Agent 和代码基准,DeepSeek 在 IPO 前交出了一份「我还在涨」的答卷。
中期看,真正的变量是 9 月 14 日的调价。官方说「把节省的成本让给用户」,但具体价格表还没完全铺开。如果 Flash 的价格真的比 V 4-Pro 便宜到明显一截,那对国产模型的 API 市场又是一轮挤压,其他厂商的 Pro 系列会很难受。
长期看,CED 这种架构思路如果被验证有效,会像之前的 MLA 一样成为下一批国产模型的标配。DeepSeek 在架构创新上已经形成了「发布一个、带动一批」的节奏,这是它和纯靠堆数据的厂商拉开差距的地方。这也延续了我们在 国产模型周报里观察到的趋势——国产模型的竞争已经从前沿刷分转到了成本和场景。
| 观察点 | 为什么重要 |
|---|---|
| 9 月 14 日调价落地 | 决定 Flash 是否真的比 V 4-Pro 便宜 |
| V 4-Pro 退役后的迁移体验 | 自动路由是否真的无感 |
| 本地推理的 FP 4 量化表现 | 552 B 权重能不能在 2 张 H 100 上跑顺 |
| 科创板 IPO 进展 | 技术叙事能否兑现成融资 |
不需要。9 月 14 日之后请求会自动路由到 V 4.1-Flash,按 Flash 价格计费。但建议你在那之前用几个自己的典型任务测一下新模型,确认输出风格符合预期。
对,本地门槛很高。官方最低配置是 1 张 B 200 或 2 张 H 100 加 FP 4 量化,这已经超出个人开发者和小团队的硬件范围。
三者路线不同。V 4.1-Flash 强在 Agent 和代码,GLM-5.3-Flash 走匿名测试的热度路线,Kimi K 3 在长上下文和中文场景有积累。具体到「写代码」这个场景,V 4.1-Flash 的 DeepSWE 和 Terminal-Bench 分数目前看是最扎实的,但选型还是得回到你自己的任务上测。