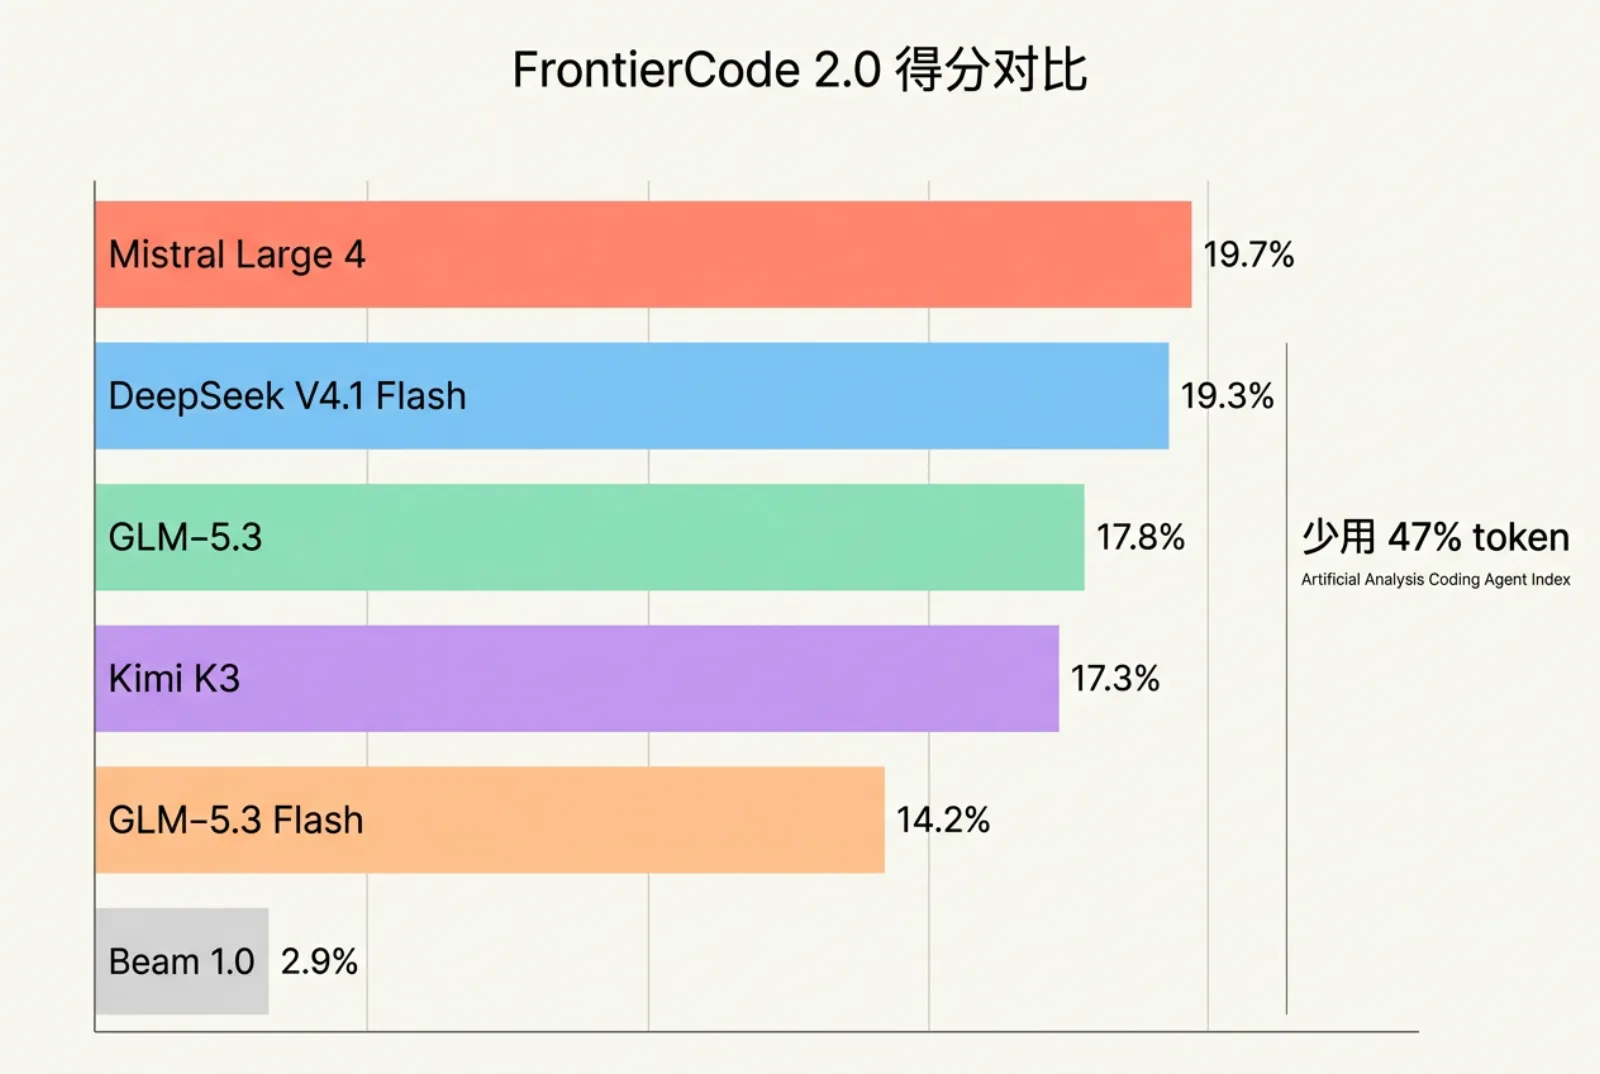
一句话结论:Mistral 于 2026 年 10 月 29 日开放 Mistral Large 4(代号 Le Chonk)权重。这是一个 1 万亿总参数、每 token 激活 49 B 的原生多模态 MoE 模型,支持 1 M 上下文和 160 多种语言,用 3,800 张 NVIDIA Grace Blackwell GPU 在欧洲自有数据中心从零训练。官方称它在 FrontierCode 2.0 上得 19.7%,超过 DeepSeek V 4.1 Flash 的 19.3%;在 Artificial Analysis Coding Agent Index 上得 48%,与 GLM-5.3 基本持平,但每个任务少用 47% 的 token。许可证不是 Apache 2.0,而是 Mistral 生态开放权重许可证:内部使用和嵌入产品功能免费,但把它做成对外提供的模型服务(MaaS)必须先与 Mistral 签商业授权。
mistralai/Mistral-Large-4-1T-A52B 公开下载datePublished);Hugging Face 仓库 9 月 30 日创建,10 月 29 日最后更新Mistral Large 4 是 Mistral 迄今最大的模型,官方代号 Le Chonk。按模型卡描述,它是一个 1 万亿总参数的原生多模态混合专家(MoE)模型,每个 token 激活 49 B 参数,算上嵌入与输出层为 52 B。它把指令跟随、推理、编程和 Agent 工作流放进同一套权重里,训练全程在 Mistral 位于欧洲的自有数据中心完成,使用 3,800 张 NVIDIA Grace Blackwell GPU,从零开始训练而非在既有模型上继续训练。
和上一代相比,最直接的变化是规模与用途定位。Mistral 不再把它定位成通用聊天模型,而是明确面向「写代码的人」和「做防御的人」——博客副标题就是 Built for Coders, Trusted by Defenders。官方在模型卡中称其视觉定位(visual grounding)超过闭源前沿模型,并在网络安全、金融、法律三类工作负载上表现突出。这对一家以「主权 AI」为叙事核心的欧洲公司来说是一次定位收拢:开放权重不是做生态广撒网,而是给需要自托管、需要数据不出境的机构一个可审计的基座。
值得单独说明的是权重体积。FP 8 主仓库约 1061 GB,拆成 54 个分片,个人设备无法运行;官方另提供一个 NVFP 4 量化版本,目标平台是 Blackwell 架构 GPU,官方称精度不变、推理更快。
按官方公布的数据,Mistral Large 4 的强项集中在 Agent 编程,而不是通用智能总分。在 Cognition 的 FrontierCode 2.0 上——这个基准考察端到端代码质量、以及仓库维护者是否愿意合并 Agent 提交的改动——Mistral Large 4 得 19.7%,同榜的 DeepSeek V 4.1 Flash 为 19.3%、GLM-5.3 为 17.8%、Kimi K 3 为 17.3%、GLM-5.3 Flash 为 14.2%、Reflection Beam 1.0 为 2.9%。领先幅度很薄,属于并列第一梯队而非断层领先。
真正的差异在 token 效率。在 Artificial Analysis Coding Agent Index 上,Mistral Large 4 得 48%,官方称与当前领先的开放权重模型 GLM-5.3 基本持平,但平均每个任务少用 47% 的 token。对按量计费的 Agent 场景,这个指标比分数更影响账单:同样的代码任务如果 token 消耗减半,单位成本就接近减半。
反面也要说清楚。在 Artificial Analysis Intelligence Index v 5 这个综合聚合指数上,Mistral Large 4 得 26,是西方开放权重模型里最高的,但官方自己承认中国头部开放模型的综合分更高。换句话说,它赢的是编程与安全这两个具体赛道,不是通用能力全面领先。想把模型用在中文长文写作、多轮常识问答这类任务上,综合指数仍是更可靠的参考。
Mistral Large 4 不采用 Apache 2.0,而是使用 Mistral 生态开放权重许可证(Mistral Ecosystem Open-Weight License),官方描述为 MIT 许可证的修改版。它保留了 MIT 的宽松部分:可以免费使用、复制、修改、合并、发布、分发、再许可和销售模型,也可以继续训练和做衍生模型,只需保留版权与许可声明。
关键限制在第 2 条:如果被许可方或其关联方经营「模型即服务」(Model as a Service)业务,必须在使用该模型或其衍生作品从事任何商业用途之前,与 Mistral 单独签订商业许可。许可证对 MaaS 的定义是:让第三方通过任何方式(例如 API 或托管端点)访问该模型或其衍生作品用于推理或后训练,并且该第三方能够对输入、参数或训练数据行使有意义的控制。
第 3 条给出了豁免:纯内部使用(不让第三方获得模型能力)不受此限;通过 Mistral 官方产品访问模型也不受此限。此外,把模型能力嵌入到具体功能或 harness 的终端用户产品不属于 MaaS。这条豁免的边界值得留意——做一款内置了该模型的 SaaS 产品通常没问题,但做一款让客户自己上传微调数据、自己控制参数的托管推理服务,就落进了需要单独授权的一侧。
和国产开放权重模型对比,这个条款更接近 MiniMax 社区许可证的思路(商用需署名并通知、超阈值需授权),而不是 DeepSeek V 4.1 Flash 或 Reflection Beam 1.0 采用的 Apache 2.0。差别在落地时很实际:Apache 2.0 可以直接做转售推理,Mistral 生态许可证需要先谈授权。
官方推荐 8 卡张量并行,走 vLLM 的现成镜像即可跑起来。模型卡给出的启动命令使用官方 Docker 镜像 vllm/vllm-openai:mistral-large-4,关键参数是 --tensor-parallel-size 8,同时必须加 --tool-call-parser mistral 和 --reasoning-parser mistral,否则工具调用不可用、推理过程也无法与正文分离。显存不足时官方建议下调 --max-model-len 或 --max-num-seqs。
| 项目 | 要求 |
|---|---|
| 推荐部署方式 | vLLM(官方推荐)或 SGLang,均有 mistral-large-4 标签的官方镜像 |
| 张量并行 | 8 卡 |
| 权重体积 | FP 8 约 1061 GB;NVFP 4 版本更小,仅限 Blackwell |
| 推理强度 | low / medium / high 三档,默认 high |
| 上下文 | 1 M token |
需要提醒的是,模型卡没有给出「最低几张卡能跑」的明确下限,只给了推荐配方。按 1061 GB 的 FP 8 权重加 KV cache 粗算,8 卡每卡需要 140 GB 以上的可用显存,这已经超出单张 H 100 的 80 GB,实际上指向的是 B 200/GB 200 级别的硬件。个人开发者和小团队应当把它当作「云端自托管选项」,而不是本地可跑模型。
短期看,Mistral Large 4 的直接使用价值有限,参考价值更大。它验证了一件事:开放权重模型的竞争重心已经从「总分高不高」转向「跑完一个 Agent 任务要烧多少 token」。Mistral 用 47% 的 token 节省作为核心卖点,说明厂商判断企业客户的痛点已从能力不足转为成本过高。
对做 Agent 产品的人来说,FrontierCode 2.0 这个基准本身值得关注。它不只测代码能不能生成,还测「维护者是否愿意合并」,这比单元测试通过率更接近真实工程价值。国内模型在榜单上的位置(DeepSeek V 4.1 Flash 19.3%、GLM-5.3 17.8%、Kimi K 3 17.3%)与 Mistral Large 4 差距在 0.4 到 2.4 个百分点区间,属于同一梯队。
许可证层面的启示更实际。开放权重不等于可以自由转售推理服务,Mistral 用一条 MaaS 条款把「用模型」和「卖模型算力」分开。国内厂商的社区许可证(如 MiniMax M 3.1-Flash 的署名加通知要求、Kimi K 3.1 Pro 的权重开放时间表)也在往同一个方向走。做商业化选型时,先读许可证再读榜单。
价格方面,Mistral 通过官方 API 提供 mistral-large-4,模型卡指向 Mistral API 文档,本次未在页面取到公开的每百万 token 单价,因此不做估算。需要横向比价的读者可参考本站维护的国产大模型 API 价格对比,注意该页口径为国产模型。
Mistral Large 4 可以免费商用吗? 内部使用和把模型能力嵌入自有产品功能都可以免费商用,只需保留版权与许可声明。但如果你的业务是让第三方通过 API 或托管端点调用该模型、并让他们能控制输入参数或训练数据,就属于 MaaS,必须先与 Mistral 签商业许可。
Mistral Large 4 能在单机跑吗? 不能。FP 8 权重约 1061 GB,官方推荐 8 卡张量并行,实际需要 B 200/GB 200 级别硬件。个人开发者应使用 Mistral 官方 API 或第三方托管服务。
Mistral Large 4 的中文能力怎么样? 模型卡列出的支持语言包含中文,共 160 多种。但官方明确说明该模型主要面向英语开发,且所有公开基准均为英文任务,没有中文能力数据。中文场景建议以实测为准,不要直接套用英文榜单结论。
和 DeepSeek V 4.1 Flash 比该选哪个? 如果任务以 Agent 编程为主、且在意每次任务的 token 消耗,Mistral Large 4 有官方数据支撑的优势(FrontierCode 2.0 领先 0.4 个百分点、少用 47% token)。如果主要服务中文用户、或者需要 Apache 2.0 级别的自由度做推理转售,DeepSeek V 4.1 Flash 更合适。
开放权重和开源是一回事吗? 不是。开放权重只保证能下载到参数,不保证许可证允许任意使用。Mistral Large 4、MiniMax M 3.1-Flash 属于开放权重但带附加条款;Beam 1.0 采用 Apache 2.0,才是通常意义的开源许可。