

一句话结论:9 月 17 日,智谱创始人唐杰公开了一个内部 RSI 早期案例——GLM-5.3 驱动的 Infra Agent 在超过 10 万张国产芯片组成的集群上,从零参与搭建并优化了一套生产级推理系统,不到两周把端到端吞吐提升到初始基线的 3.2 倍。这可能是国产大模型第一次把「递归自我改进」从口号变成了跑进生产环境的工程事实。
先讲清楚背景。GLM-5.3-Flash 上线时,要在一套超过 10 万张国产芯片组成的集群上跑起来,本身就是一个没人干过的活——芯片内存和带宽受限,还要支持 1 M 上下文和多模态请求,生态不成熟,算子不完备,很多文档基本靠猜。
按传统做法,这需要一支资深 Infra 团队花数周时间。但智谱做这件事的主力,是 GLM-5.3 驱动的 Infra Agent。
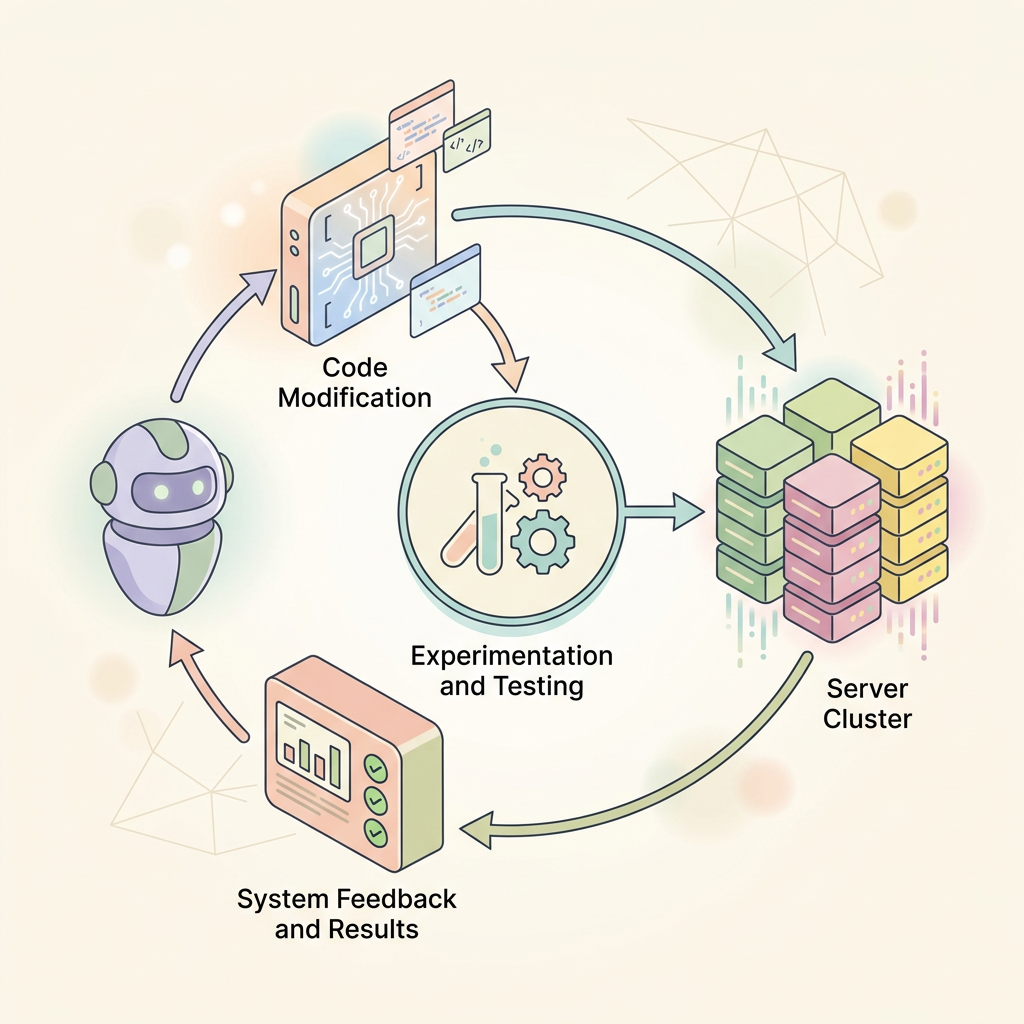
唐杰的描述很具体:Agent 能自己读取系统反馈、提出假设、修改代码、跑实验,再根据结果继续迭代。它定位出了 KV Transfer 场景里 Python GIL 导致的并发阻塞,把 Prefill + KV Transfer 相比单独 Prefill 超过 20% 的性能损失压到了 1% 以内;还在 KDA Decode 算子上通过重新组织计算,拿到了 1.71 倍的性能提升。
过去半年,RSI(递归自我改进)这个词从硅谷火到国内,但真正「交卷」的屈指可数。OpenAI 和 Anthropic 都承认在推进 RSI,谷歌被曝 API 泄露疑似跑通,但公开的、可复盘的工程案例很少。
智谱这个案例的特殊之处在于,它展示了 RSI 一个具体的、有边界的形态:模型不修改自己的权重,而是通过「改代码、跑实验、看结果、再迭代」的闭环,去优化支撑自己运行的推理系统。
这里有一个「套娃」式的闭环:GLM-5.3 驱动的 Agent 优化了推理系统,而这个推理系统又反过来支撑 GLM-5.3-Flash 稳定地服务用户。模型优化系统,系统服务模型。这和 Reef 那套「推理服务器边服务边学习」 的思路是同一个方向,只是智谱把它做进了国产算力的生产环境。
唐杰的博客披露了几个具体的工程突破,值得开发者关注。
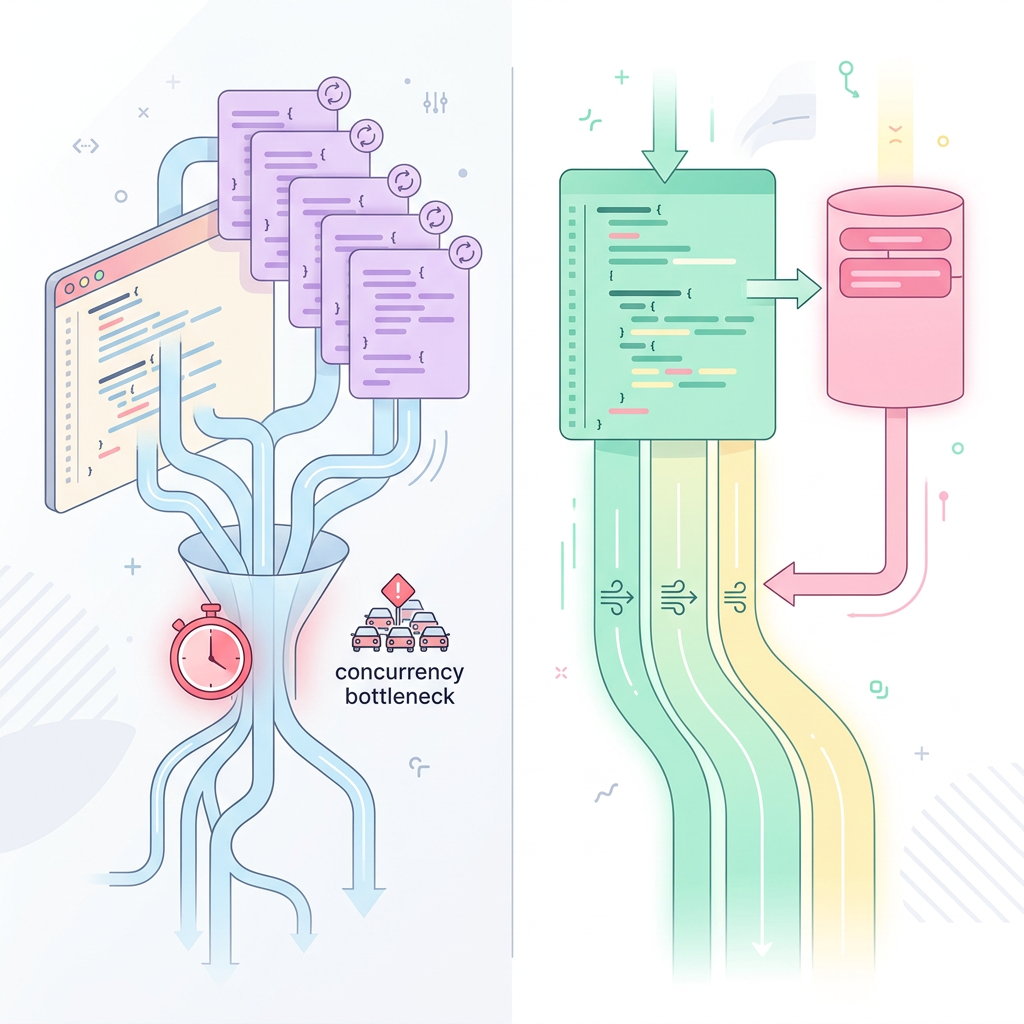
第一个是 GIL 并发瓶颈。在 KV Transfer 场景,DeepEP v 1.2.1 的 intranode 调用没有显式释放 Python GIL,导致负责 Mooncake Transfer 的 Python 线程拿不到 GIL,传输任务被推迟。修复的办法是在相关 C++ 执行区间释放 GIL。这个问题的定位和修复,是 Agent 自己沿着调用链一路查下去的。
第二个是 KDA Decode 算子的重复计算。Agent 发现原实现沿 V 维度分块,导致相同的 FP 32 归一化与门控计算被重复执行四次。它把分块合并到同一线程块,用牺牲部分并行度换来了 1.71 倍的性能提升。
这两个案例的共性在于:Agent 不是凭空写出优化,而是从系统反馈里发现问题、提出假设、验证。这正是「用稠密反馈驱动优化」和传统「人类凭经验优化」的区别。
智谱这个案例,加上同一天的几个新闻,拼出了一个更完整的图景。
国产厂商正在把 RSI 从「实验室概念」推进到「生产工程」。云知声的 U 2-Flash 用后训练闭环参与自身训练,智谱用 Infra Agent 优化推理集群,谷歌用 Dream-RSI 让模型「做梦」进化。三条路线各不相同,但都指向同一个判断:模型开始参与「构建下一版自己」的某个环节。
这也呼应了 Anthropic CEO 呼吁给前沿减速 的焦虑——Amodei 担心的正是这种「模型优化系统、系统让模型更强」的正反馈循环,而智谱和谷歌都在用各自的方式证明这个循环已经转起来了。
短期看,这个案例最大的价值是「可信度」。它给出了具体的数字(3.2 倍吞吐、20% 损失压到 1%、1.71 倍算子提升)和具体的技术路径(GIL 释放、分块合并),比「我们实现了 RSI」这种口号可验证得多。虽然数据是自测的,但技术细节经得起内行推敲。
中期看,Infra Agent 这类「让模型优化基础设施」的落地,可能比「让模型优化模型权重」更早规模化。因为前者边界清晰、可回滚、有明确验收标准,风险可控;后者涉及权重安全和失控风险,短期内还很难放开。这可能是 RSI 落地的第一条现实路径。
长期看,国产厂商在 RSI 上的集体发力,正在改变一个认知:RSI 不是硅谷大厂的专利。当智谱、云知声、谷歌都在用不同路线推进,这场竞争已经从「谁先提概念」变成了「谁先把闭环跑进生产」。技术底线的意义,也开始从纸面宣言变成工程事实。
没有。这个案例里的 RSI 是「模型优化支撑系统」,Agent 改的是推理系统的代码和算子,不是模型权重。这是 RSI 的一个早期、有边界的形态。
数据来自智谱官方技术博客的自测,未经第三方独立验证。但技术细节(GIL 释放、算子分块合并)是内行可以复盘的,比单纯报一个数字更有参考价值。
路线不同。谷歌 Dream-RSI 让模型在「虚拟世界」里做梦进化搜索策略,智谱是让模型优化真实生产环境的推理集群。前者偏算法研究,后者偏工程落地,都属于「不直接改权重」的 RSI 路线。

评论 (1)
[…] 真正值得关注的是它怎么涨上来的。这不是靠堆更多预训练数据,而是靠 RL 算力规模化——这正是站内一直在跟的 RSI 叙事(谷歌 RSI 泄露、智谱 Infra Agent)在国产模型上的一次落地。 […]
评论被关闭。