

一句话结论:MIT 研究员 Ao Qu 团队在 9 月 15 日开源了 Reef,一个 Apache-2.0 协议的持续自我改进 Agent 基础设施。它的核心思路是让推理服务器不再只是「跑模型」,而是记录每次推理的轨迹和反馈,自动训练、评估、发布新版本——把「模型上线后就不再变」这个默认假设改成了「模型边服务边进化」。
先讲一个被默认接受的假设:推理服务器是「静态」的。你用 vLLM 或 SGLang 部署一个模型,它上线后就一直那样跑,直到你手动换新版本。模型本身不会从它处理过的请求里学到任何东西。
Reef 挑战的就是这个假设。它把「推理服务器」改造成了「边服务边学习」的闭环:记录每次推理的轨迹和用户反馈,把这些记录喂给学习任务,评估候选更新,通过后再热更新到线上——全程不用重启服务。
这个定位和 context-mode 砍掉 98% 上下文膨胀 那种「优化单点」的思路不同,Reef 做的是「把学习这件事搬进推理基础设施本身」。
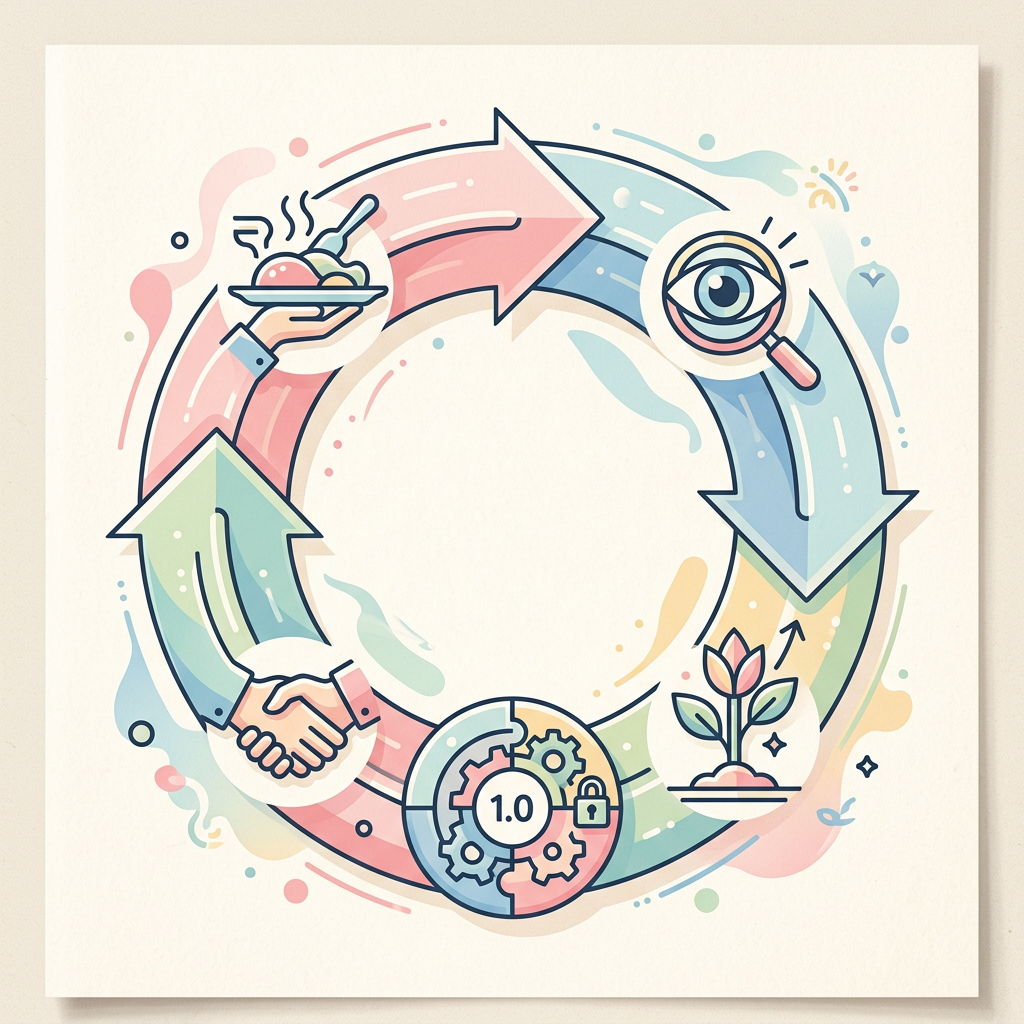
Reef 的核心是四个阶段的循环,论文里叫 serve、observe、grow、commit。
前两个阶段负责「采集」。serve 阶段正常服务,observe 阶段把交互轨迹和反馈配对,处理 off-policy 陈旧、会话合并、去重这些工程难题,形成一个结构化的「经验流」。
第三个阶段 grow 负责「学习」。这里分两条线:模型侧用学习配方(learning recipe)消费记录来更新权重,训练用分布式后端异步跑,产出 checkpoint 或 LoRA 适配器;harness 侧用 Cordis 分析 Agent 轨迹和反馈,提出对 Agent 代码的改动。
第四个阶段 commit 负责「把关」。候选更新必须先通过评估,评估通过才作为新版本发布;被拒绝的话,线上版本保持不变。这个发布门控是 Reef 最务实的地方——它承认持续学习可能把系统改坏,所以用版本控制和评估兜底。
过去几天,RSI(递归自我改进)这个词反复出现。我们写过 谷歌 API 泄露疑似跑通 RSI,写过 Opus 5.2 背后的 Model 2 传闻,也写过 Amodei 呼吁给前沿减速。但那些都停在「实验室爆料 + 推测」层面。
Reef 是这些讨论里第一次出现的可落地的开源工程。它没承诺「AI 无限自我改进」,而是给出一个具体的、有边界的版本:一个服务器,能记住发生过什么,能提出有限的改动,能在改动上线时保留版本历史。
论文作者自己也把话说得很克制:这不是一个让 Agent 重写整个智能栈的系统,而是一个「更小的承诺」。在 RSI 被炒作得越来越玄乎的当下,这种克制反而让它更可信。
如果你是做 Agent 部署的,Reef 值得关注,因为它回答了一个真实痛点:Agent 上线后怎么持续变好,而不是每次都要停机重训重部署。
它和现有工具是互补关系,不是替代。vLLM、SGLang 专注推理,Slime、veRL 专注强化学习训练,Reef 的定位是把「实时服务、反馈收集、训练、harness 编辑、评估、版本交付」放进一个控制循环。如果你已经有推理栈和训练栈,Reef 是在这两者之间加一层「学习闭环」的胶水。
如果你只是想跑个模型,Reef 不是你的菜——它是给「想让 Agent 从真实使用中持续进化」的团队准备的,门槛不低,需要理解强化学习、harness 编辑和版本管理。
一句话:这是一个「研究型 + 工程型」项目,看的是「持续学习 Agent」这个方向怎么落地,不是今天就能开箱即用。
短期看,Reef 最大的价值是「把 RSI 从口号变成了可审查的代码」。它把「边服务边学习」这件事拆成了可安装、可配置、可验证的具体机制,让持续学习从论文概念变成工程实践。
中期看,发布门控(评估通过才发布)是这个项目最可能被借鉴的设计。当越来越多 Agent 开始「自己改自己」,怎么防止它改坏一个正在服务用户的系统,会成为基础设施层的刚需。Reef 的版本控制 + compare-and-swap 发布链,给了一个可参考的答案。
长期看,这背后是一个更大的判断:AI 基础设施正在从「静态的推理服务」走向「有状态的、会学习的系统」。Reef 是这个转向的早期信号之一,和 open-connector 让 Agent 连上 SaaS 一样,都是在给「Agent 真正跑在生产里」补基础设施的课。
不是。它是「有边界」的持续学习:记录交互、提出有限改动、评估通过才发布、保留版本历史。作者明确说这是「更小的承诺」,不是让 Agent 重写整个智能栈。
互补关系。vLLM/SGLang 专注推理速度,Slime/veRL 专注 RL 训练,Reef 是把「实时服务 + 反馈 + 训练 + 评估 + 版本交付」串成一个循环,是夹在推理和训练之间的一层学习闭环。
代码在 GitHub(Human-Agent-Society/reef)开源,Apache-2.0,有安装、快速开始和运行说明。但它面向的是想给 Agent 加持续学习能力的团队,不是普通用户的即开即用工具。

评论 (3)
[…] Reef 让 Agent 边服务边学习 是同一类「不改权重」的 RSI 路线,只是 Dream-RSI […]
[…] 源码,从配置层直接换模型、加工具、接 MCP 装技能。这呼应了站内之前Reef 持续自我改进基础设施 那篇里观察到的趋势——基础设施层的可插拔性,正在成为 agent […]
[…] Reef 持续自我改进基础设施 […]
评论被关闭。