一句话结论:谷歌联合 Google DeepMind、马里兰大学和弗吉尼亚大学在 arXiv 上发表了一篇论文(2609.14858),开源了 Dream-RSI——一种不修改模型权重的递归自我改进方法。它让智能体把自己走过的每一步存成一棵树,然后在树里「做梦」回放,练出更优的探索策略。论文称算法优化任务上只需 317 次调用就达到主流进化搜索跑 51200 代的效果。
过去谈起 RSI(递归自我改进),大家想到的通常是「AI 修改自己的权重,训出下一代」。这条路难在权重安全、失控风险和算力成本。
Dream-RSI 换了一个方向:模型权重不用变,让 AI 通过「做梦」来优化自己的探索策略。
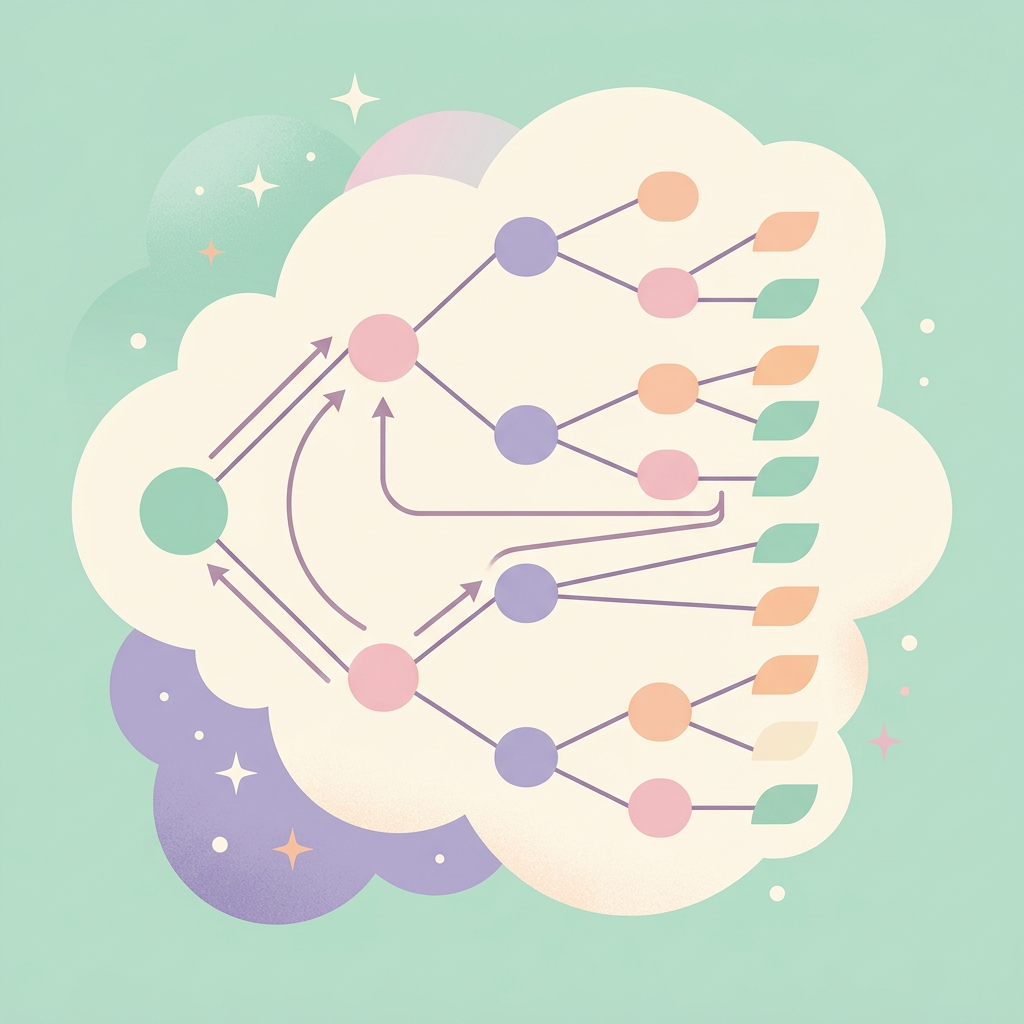
具体做法是,智能体把每一次尝试、每一步决策都记录成一棵树——这是一段「历史」。然后在训练阶段,它回到这棵树的各个节点「做梦」,在虚拟的历史里演练不同的探索路径,学出一个更优的搜索策略。这个策略再回到现实里指导下一次执行。
这个思路的巧妙之处在于:它绕开了「改权重」这个最危险也最昂贵的环节,转而优化「怎么搜索」这个相对安全、可复现的外围能力。这和 Reef 让 Agent 边服务边学习 是同一类「不改权重」的 RSI 路线,只是 Dream-RSI 把「回放」这个机制做成了核心。
论文给出的几个数字,是它引起轰动的直接原因。
在算法优化任务上,主流的进化搜索系统需要跑 51200 代才能达到的水平,Dream-RSI 只调用了 317 次就达到了。在 GPU 内核优化上,达到同等性能所需的生成次数降低了 2.43 倍;在圆填充问题上,追平了谷歌自家 AlphaEvolveV 2 的最强纪录。
更值得注意的是普适性。论文明确说「底层权重一字未改」,Gemini 3.1 Pro 和 3.7 Flash 都可以直接套用。这意味着 Dream-RSI 是一个「外挂」——不挑模型,只要模型够聪明,就能通过做梦来改进自己的搜索策略。
还有一个反直觉的结论:人给 AI 指方向,反而比不指更差。这暗示在「探索最优策略」这件事上,人类先验可能是在限制而非帮助模型。
Dream-RSI 不是孤立的。把谷歌最近的几条线串起来看,逻辑就清楚了。
9 月初,谷歌 API 泄露疑似跑通 RSI,被曝出 rsi-model-liverl-le 的模型标签;产品负责人 Logan Kilpatrick 透露谷歌正在「死盯前沿,已经看到 RSI 的早期迹象」,并拿 Gemini 3.5 到 3.8 每三四周一更当证据。
Dream-RSI 论文挂上 arXiv 的时间是 9 月 14 日,正好在这一串动作之后。它给了一个具体的技术方案,解释谷歌说的「RSI 早期迹象」可能长什么样——不是模型自己改权重,而是模型学会在自己的历史里做梦、进化。
如果你是做搜索优化、进化算法或 Agent 策略研究的,Dream-RSI 值得重点跟进。它是「不改权重做自我改进」这一路线上最清晰、最可复现的公开方案之一,代码在 GitHub 上开源,论文的 discovery-tree 日志格式可以直接拉下来复现。
如果你想立刻把它用到生产里,那还太早。它是研究系统,刚发论文,复现需要一定的深度学习工程能力。但它指出的方向很明确:当「改权重」这条路充满风险时,「优化搜索策略」这条外围路径可能是 RSI 落地的现实入口。
这和同一天曝光的智谱 Infra Agent 优化推理集群的思路形成了有趣的对照——谷歌让模型在虚拟世界里做梦,智谱让模型在真实生产环境里干活,两者都是「不改权重」的 RSI,只是一个偏研究、一个偏工程。
短期看,Dream-RSI 最大的价值是「给 RSI 降温」。在「AI 自我进化」被炒得越来越玄乎的当下,它给出了一个具体的、可验证的、不涉及权重安全的方案,把讨论拉回了工程和算法的地面。
中期看,「做梦回放」这个机制本身可能比 RSI 更值得关注。让模型从自己的历史轨迹里学策略,这其实是一个通用的思路,不只适用于自我改进,也可以用在任何「需要从经验中学习」的 Agent 场景。它可能催生一批「回放式学习」的开源项目。
长期看,这背后是一个更根本的判断:RSI 的第一波落地,大概率不是「AI 重写自己的大脑」,而是「AI 优化自己的行为方式」。Dream-RSI、Reef、智谱 Infra Agent,都在用各自的方式验证这个判断。谁先把这条路径跑顺,谁就在 RSI 的早期阶段占得先机。
不修改。它优化的是智能体的「搜索策略」——怎么在问题空间里探索,而不是模型本身的能力。论文明确说「底层权重一字未改」。
论文称在某个算法优化任务上,主流进化搜索系统要跑 51200 代才能达到的效果,Dream-RSI 只调用 317 次就达到了。这是自测数据,具体任务细节以论文为准。
代码在 GitHub(dream-rsi/dream-rsi)开源,论文有 discovery-tree 日志格式,可以 git clone 复现。但需要深度学习工程能力,不是开箱即用的产品。