一句话结论:9 月中旬,ChatGPT 核心发明人之一 Diogo Almeida 创办的 TypeSafe AI 发布了 Jev——一个不会生成任何文字、只输出结构化概率决策的「System One 模型」。它端到端响应仅 70 到 500 毫秒,输入每百万 token 0.042 美元、输出永久免费。发布不到 36 小时,14 万开发者涌入内测,Vercel、Cloudflare、LangChain 三天内完成集成。
Jev 最反常识的一点是:它连一个标点符号都吐不出来。
它不写文章、不写代码、不陪聊。你扔一段极其混乱的输入(一封炸毛的客诉邮件、卡壳的代码),它只做一件事——返回一个类型化的决策,附带精确概率。官方只给了三种交互方式:Choice(从选项里挑一个)、Score(打分)、Noul(输出 0 到 1 的概率值)。
这个设计直接砍掉了大模型最核心的能力(文字生成),却换来两个大模型做不到的东西:零幻觉,和极致的快与便宜。
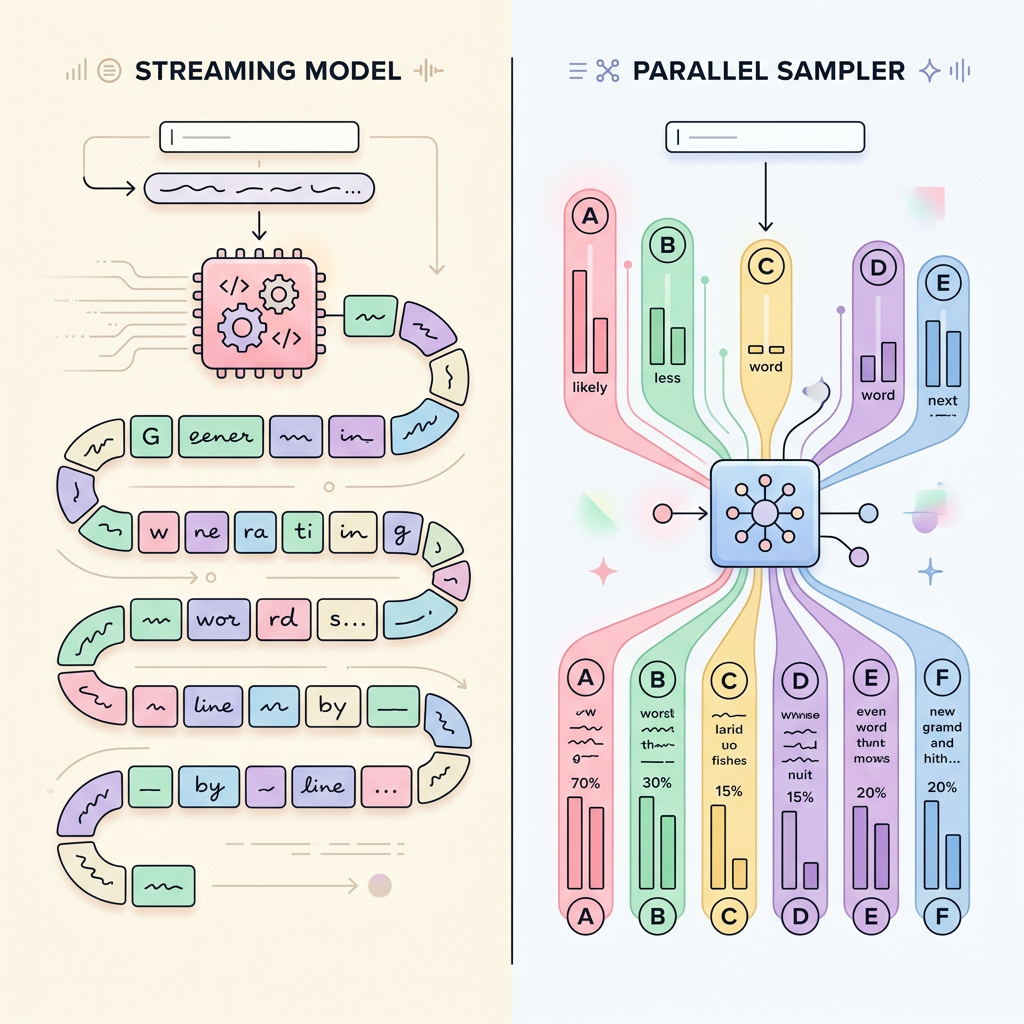
零幻觉的逻辑很简单——模型只是给划定好的几个选项分配概率,选项之外的东西它想编也编不出来,程序拿到的永远是一个合法的值。而「快」和「便宜」来自同一件事:它不做逐 token 的自回归生成,而是把所有输出并行采样、一次性给完。
「System One」这个名字来自诺奖得主卡尼曼的《思考,快与慢》。系统一是那种不过脑子、凭直觉瞬间给出的本能判断;系统二才是需要慢慢推演的深度思考。
Almeida 的定位是:以 ChatGPT 为代表的大模型属于「系统二」,而 Jev 是专门做快速决策的「系统一」。
这个分工的逻辑在于,大量真实场景里的 AI 调用,其实根本不需要「生成一大段文字」。工单分类、内容合规初筛、数据打标、在几十个 API 里选一个调用——这些活儿需要的是一个快速、可靠、便宜的概率判断,而不是一篇漂亮的文章。
Almeida 的原话是「零样本 + 通用 = 可编程」:任何一个判断都能用几行代码描述清楚,根本不需要微调。这和他当年做 InstructGPT 时下的赌注一模一样——只要底座足够通用,颠覆性的用例会自己长出来。
Jev 的成本结构,是它引发狂欢的直接原因。
TypeSafe 只对输入收费,每百万 token 0.042 美元,输出永久免费。官方博客的原话相当嚣张:「便宜到根本不值得计费。」
有人拿它审 PR,一次约七万分之一美元,1000 个 PR 才花 7 美分,同样的活交给 Opus 5 要烧掉 14.5 美元。还有演示让它实时打《毁灭战士》,每秒做 10 次决策,一小时算力成本只要 7 美元左右。
这种「便宜到可以随手用」的定位,指向的是一个更大的押注——经济学里的「杰文斯悖论」:蒸汽机效率越高,烧掉的煤反而越多。Almeida 把模型命名为 Jev,就是在赌:当 AI 决策的成本趋近于零,开发者对 AI 决策的需求不会减少,反而会像大爆炸一样席卷所有代码。
这里要划清一件事:Jev 不是来取代大模型的,而是来和大模型「搭伙」的。
Almeida 描述的关系是「双核搭档」:大模型在前面吭哧吭哧干活,Jev 在旁边花几十毫秒用概率给这活儿打分,看合不合格。能过就放行,不能过直接打回重写。
这种「生成 + 校验」的分工,实际上把大模型从「既要干活又要自检」的尴尬里解放出来了。过去大模型自己评估自己的输出,往往不可靠;现在换一个专门做概率判断的模型来把关,逻辑上更干净。
谷歌的反应印证了这条路的吸引力——Gemma 官方账号火速发了条「DiffusionGemma as Jev」,把自家扩散模型塞进这个范式,一步去噪、一次性并行给出所有选项的概率,还顺手补上了视觉能力。
短期看,Jev 最大的价值是「提出一个尖锐的问题」:智能到底是什么?图灵测试让整个行业朝着「把话说漂亮」狂奔了七十年,ChatGPT 把这条路走到了极限。Almeida 反其道而行,先让机器闭嘴、让它可靠、再让它便宜到可以随手用。这个反直觉的解法,值得认真对待。
中期看,真正要盯的是「决策层基础设施」这个新赛道的形成。当 AI 的成本从「生成一段文字」降到「给个概率」,软件架构里会多出一层「毫秒级决策」——成千上万个微小的、敏捷的神经网络突触嵌进代码。这比任何单点模型发布都更能改变软件行业的成本结构。这也呼应了 OpenAI 把 Codex 拆成基础设施 的趋势——AI 正在从「对话」走向「分层的基础设施」。
长期看,代价也必须说清楚。Jev 在面对需要一步步推导的数学推理时,顶多只有 GPT-4 水平,目前也不支持图像输入。它解决的是「快速判断」这一个子任务,不是通用智能。但恰恰是这种「专注一个子任务、做到极致便宜」的路线,可能比「什么都做但都贵」更早规模化。
不能。它刻意放弃了文字生成能力,只输出结构化决策(Choice/Score/Noul)和概率。它的定位是「系统一」——快速判断,不是「系统二」——深度生成。
在它的任务范围内是的。因为它只给划定的选项分配概率,选项之外的内容编不出来。但代价是它做不了需要自由生成的复杂任务,数学推理也只有 GPT-4 水平。
目前是小范围邀请内测,TypeSafe 的 API 一度因访问量过大而无法服务。基准测试是自设的(用 Astra/Fable 的预测概率做参照),独立第三方验证还没完成,真实企业级表现待观察。