7 9 月

Claude 首次证明费马大定理:11 天写 1300 万行 Lean 代码,AI 完成数学史上最大自动形式化

一句话结论:Anthropic 用 Claude 在 11 天内完成了费马大定理的首个端到端机器验证证明,生成 1300 万行 Lean 代码、验证近 3 万条定理——这不是新数学发现,而是把 Wiles 1995 年的证明变成计算机可逐行验证的凭据。 AI 摘要 发生了什么:Claude 在 11 天内完成费马大定理的机器验证证明,规模是 Mathlib 的 5 倍多。核心变化:多智能体协作从「乱套」到「可并行」,靠的是一个叫 Prove2Me 的定理任务树平台。影响对象:数学家、AI 研究者、关注形式化验证的开发者。下一步观察:这个模式能否复制到其他未形式化的重大数学定理上。 发生了什么 9 月 5 日,Anthropic 宣布 Claude 完成了费马大定理的首个端到端机器验证证明。费马大定理折磨了数学家 350 多年,Andrew Wiles 在 1995 年给出了最终证明,但那套证明长达 129 页,之后人类一直在尝试把它「形式化」——也就是翻译成...
6 9 月

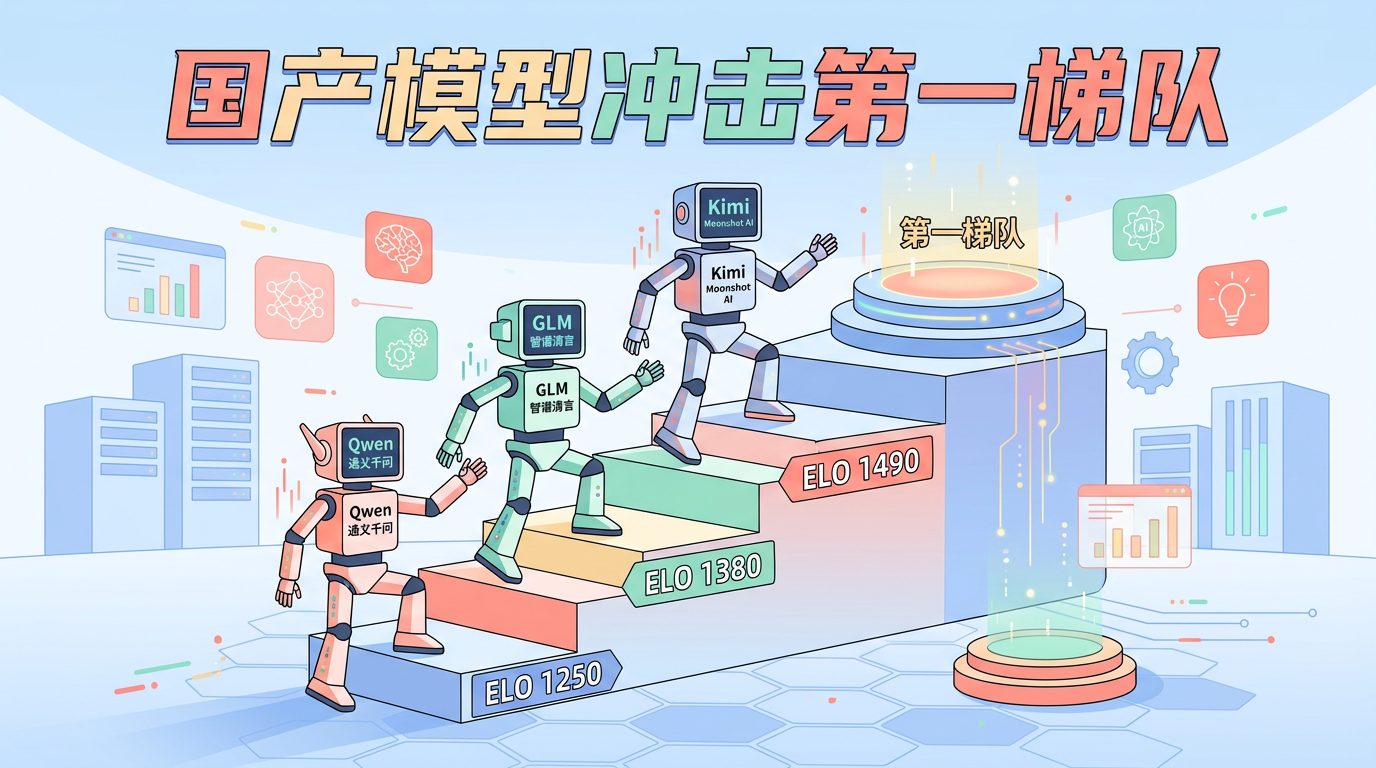
Arena 第35周盲测榜:Qwen3.8-Max 登顶前端榜,国产模型集体冲击第一梯队

一句话结论:在 LMArena 第 35 周(8 月 24–30 日)的第三方盲测中,Qwen3.8-Max-0902 首次入榜即以 1691 分登顶前端开发榜,GLM-5.3-Flash 闯入代码榜前十,这是国产模型第一次在多个细分榜单同时逼近全球第一梯队。 AI 摘要 发生了什么:LMArena 发布 2026 年第 35 周盲测榜,多款国产新模型集体亮相。核心变化:Qwen3.8-Max-0902 前端开发榜登顶(1691 分),把 Claude Opus 5 Max 挤到第二;GLM-5.3-Flash 代码榜首进 Top 10。影响对象:国产大模型开发者、模型选型团队、关注 AI 编程工具的从业者。下一步观察:Qwen3.8-Max 的 AA 智能指数评测何时补上,以及 GLM-5.3-Flash 的排名能否站稳。 发生了什么 LMArena(arena.ai)在 9 月 2 日更新了 2026...
6 9 月

GPT-6 Astra 全量上线:OpenAI 宣告「欢迎来到 AGI 时代」,网安能力首达 Critical 红线

一句话结论:GPT-6 Astra 是 OpenAI 首个在网络安全维度达到「Critical」等级的模型,也是其总裁口中「AGI 时代开始」的标志;但它 99.9% 的基准神话有测试框架的前提,第三方综合评测仍落后于 Claude Fable 5.1。 AI 摘要 发生了什么:OpenAI 于 9 月 3 日发布 GPT-6 Astra,9 月 5 日全量向 Plus、Business 用户开放。核心变化:计算机操作能力跃升、网络安全首次触及 Critical 阈值、API 定价翻到 Sol 的 2.5 倍。影响对象:ChatGPT 订阅用户、AI Agent 开发者、关注前沿模型安全的企业。下一步观察:第三方评测是否会复现 OpenAI 的基准成绩,以及 Critical 级网安能力如何被限制分发。 发生了什么 美东时间 9 月...
5 9 月

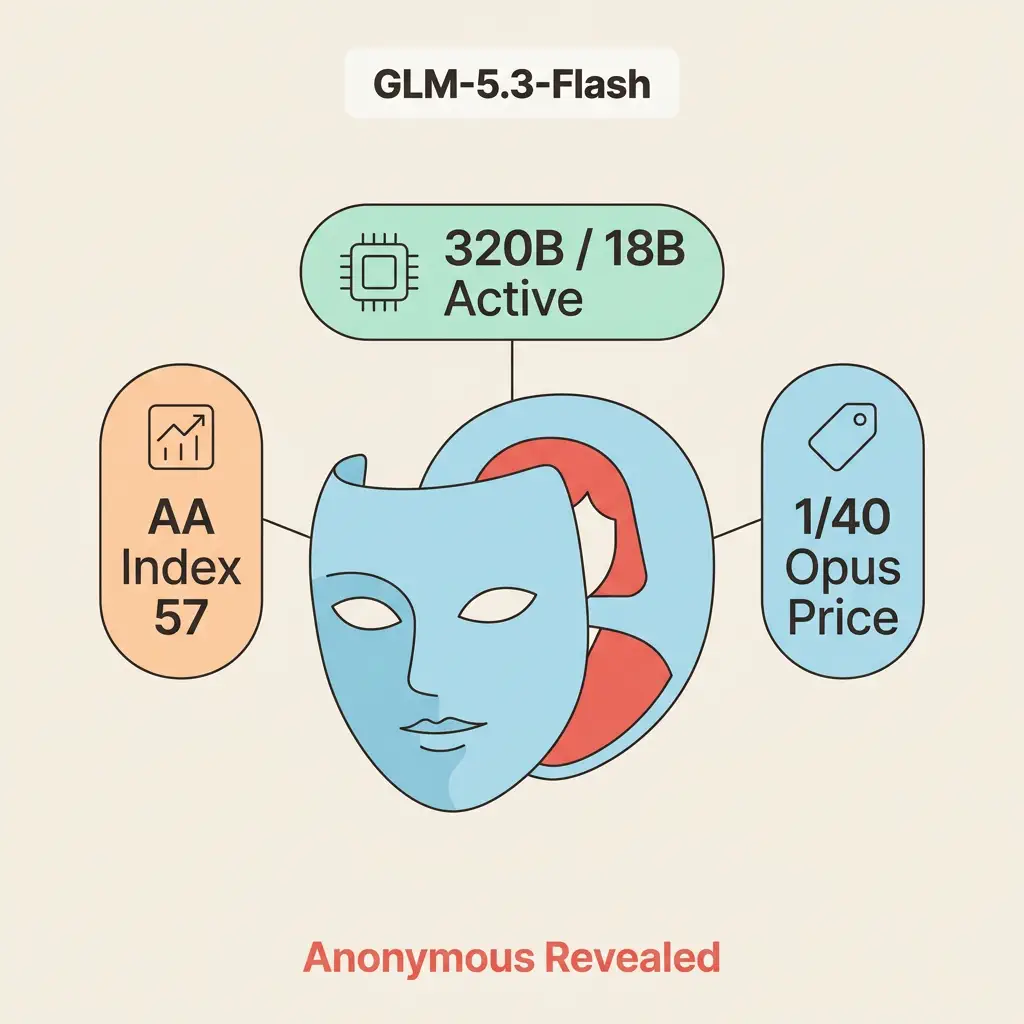
「牛来」身份揭晓:智谱正式开源 GLM-5.3-Flash,六天匿名测试换来双平台调用量新高

智谱认领匿名模型 Ox Alpha,正式开源 GLM-5.3-Flash——320B 参数仅激活 18B,AA 指数 57 分持平 Opus 4.8,定价仅其 1/40。六天匿名测试换来双平台调用量新高。
5 9 月

Gemini 3.8 Flash 与 Flash Cyber 发布:Google 把速度、成本和安全拆成两条线

Google 在 2026-09-02 发布 Gemini 3.8 Flash 与 Flash Cyber,前者面向长任务 agent,后者面向可信防御者;这次更新最重要的不是“更强”,而是把速度、成本和安全拆成了两条产品线。