一句话结论:Google 9 月 23 日在 Gemini API 和 AI Studio 推出两款文本转语音(TTS)模型——Gemini 3.8 Flash TTS(深度创意场景)和 Gemini 3.8 Flash-Lite TTS(大规模成本高效),基础是 Gemini 3 Pro,最长支持 64 K token 音频输出。这不是又一个 TTS 模型发布,而是 Google 把音频生成从「实验能力」推进到「企业可生产部署」的关键一步。
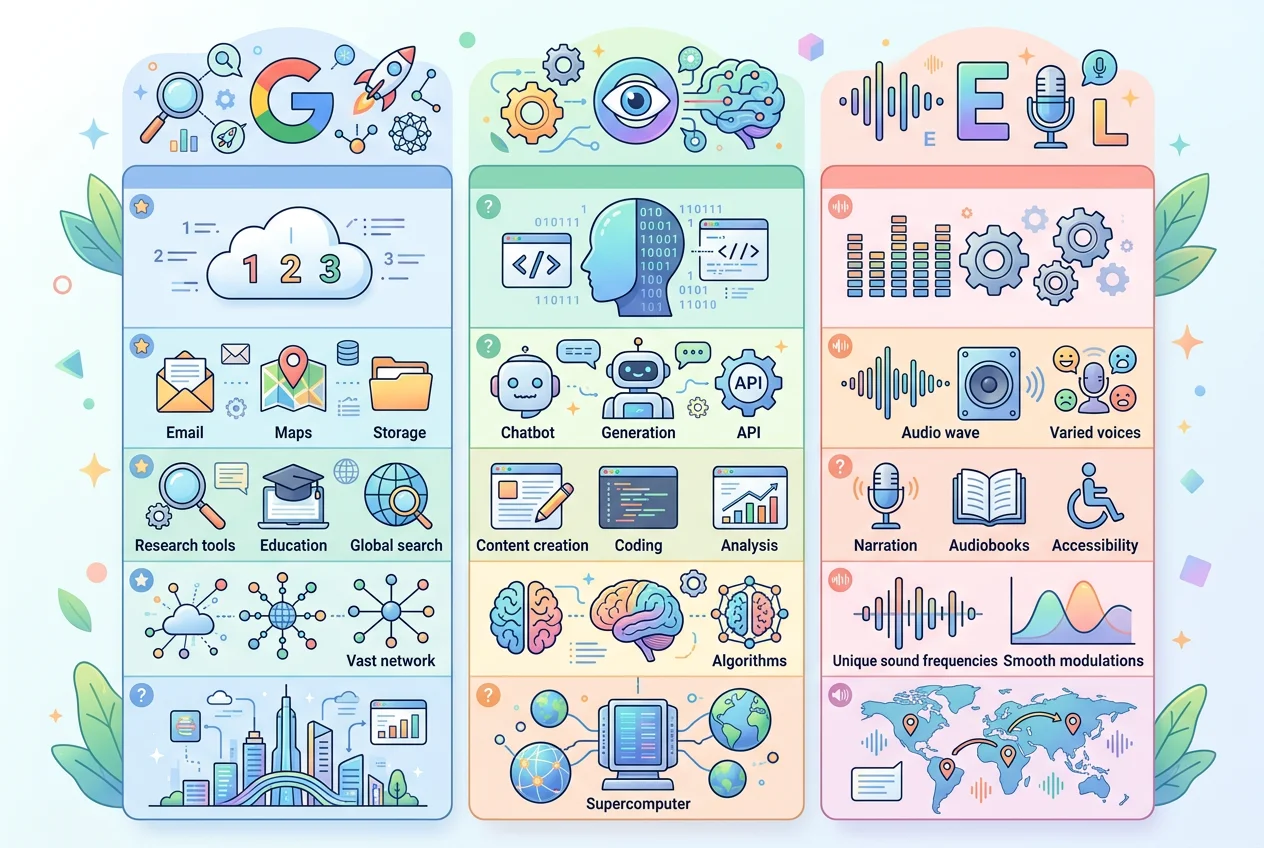
Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 都是基于 Gemini 3 Pro 的文本转语音模型,定位是对话、叙事和多角色音频内容的生产化。Gemini 3.8 Flash TTS 主打深度创意场景——游戏 NPC 配音、有声书、播客的叙事指导、交互式媒体的角色设计。Gemini 3.8 Flash-Lite TTS 主打大规模成本高效场景——配音本地化、语音 Agent 的细粒度音调/节奏控制、批量音频生成。
两个模型已经在 Gemini API 和 Google AI Studio 中推出。配套还有几个关键集成:
TTS 模型过去几年的故事是:单看 demo 都不错,但真到生产环境就会暴露一堆工程问题——延迟、稳定性、长音频一致性、API 配额、企业合规。Google 这次的发布重点不只是模型效果,更是一整套生产化配套:
| 维度 | Gemini 3.8 Flash TTS | OpenAI Voice Engine | ElevenLabs | | — | — | — | — | | 文本输入上限 | 8 K token | 未公开统一上限 | 视套餐 | | 音频输出上限 | 64 K token | 未公开 | 视套餐 | | 声音克隆 | ✅(地理受限) | ✅(早期访问) | ✅(全开放) | | 多说话人剧本编辑器 | ✅ | ❌ | ✅(Studio) | | 商用 API | ✅ Gemini API | ✅ | ✅ | | 工作流集成 | Vercel/Agora/LiveKit/Pipecat | OpenAI 生态 | Conversational API 等 | | 定价透明度 | 中(按 Gemini API token 计费) | 低(未完全公开) | 高(按字符计费) |
ElevenLabs 的优势是声音自然度和工作流生态——它的 Studio 工具、Conversational API 一直是行业事实标准。OpenAI Voice Engine 优势在 OpenAI 工具链一致性。Gemini 的优势是和 Gemini 3 Pro 共享底层模型,理论上能跟多模态 Agent 衔接更紧。
注意 Gemini 3.8 Flash TTS 不是「第一个」商用级 TTS——它要追赶的是 ElevenLabs 已经跑了 3 年的市场。但 Google 把模型、API、Studio、合作伙伴生态一次性摆出来,相当于直接对标 ElevenLabs + OpenAI + AWS Polly 整个赛道。
最低门槛:
“`python from google import genai client = genai.Client(api_key=”YOUR_KEY”) response = client.models.generate_content( model=”gemini-3.8-flash-tts”, contents=”Your script here”, config={“response_modalities”: [“AUDIO”]}, ) “`
完整 SDK 文档在 ai.google.dev。生产化时建议先在 AI Studio 的 Playground 里调好声线参数(pitch / tempo / character),再把脚本转 API 调用。
短期看,Google 终于补齐了「严肃商用 TTS」这个产品线,但面对 ElevenLabs 这个三年老兵,模型本身可能只是入场券——真正决定能不能抢到市场份额的是工作流和生态。AI Studio 新增的语音设计工作区、Vercel/Agora/LiveKit/Pipecat 的预集成,这两件事比模型架构本身更重要。
中期变量在于 OpenAI Voice Engine 是否会在 GPT-6 时代正式开放更完整的商用渠道。如果 OpenAI 把 Voice Engine 接入 GPT-6 Sol/Luna 体系,整个 TTS 市场的价格和稳定性会被快速重塑。
长期看,TTS 这件事正在从「专业音频工具」变成「多模态 Agent 的基础设施组件」。当声音合成跟文本推理一样按 token 计费、一样可以即插即用时,「有声内容生成」的工业化才真正开始。这也呼应了站内 ChatGPT Images 2.5 那篇观察到的「多模态 Agent 的基础设施组件化」趋势——9 月这一波(图像 2.5 + Audio 3.8)说明 OpenAI 和 Google 在多模态基建上的步调几乎完全一致。
取决于你的场景。ElevenLabs 在声音自然度、声音克隆效果、Studio 工作流上仍是行业领先;Gemini 的优势在和 Gemini 3 Pro 多模态生态衔接、API token 计费透明、Vercel/LiveKit 等开发者栈预集成。建议拿自己最关键的 10-20 个真实场景做对照测试,而不是看 demo。
可以。Gemini API 商用条款允许,但具体合规边界取决于你的产品使用方式——尤其如果用了声音克隆功能,注意脚注里列出的地理限制(伊利诺伊、德州、EEA、英国、瑞士、印度)。
ElevenLabs Conversational API 是更成熟的对话方案,延迟优化和 turn-taking 做得更细。Gemini 这次定位偏「TTS 单点能力」,不是端到端对话 Agent。要做对话式语音产品,建议把 Gemini TTS 跟 LiveKit/Agora/Pipecat 组合,自行管理 turn-taking 和打断逻辑。
两个都是「闭源大厂的 TTS 集成方案」。OpenAI 的优势在 GPT 生态一致性;Gemini 的优势在 64 K 长音频输出上限和 Vercel 生态。如果你的产品已经重度绑定某个大模型家族,跟它走最省事。如果要做新项目,建议两边都跑对照测试。