8 10 月
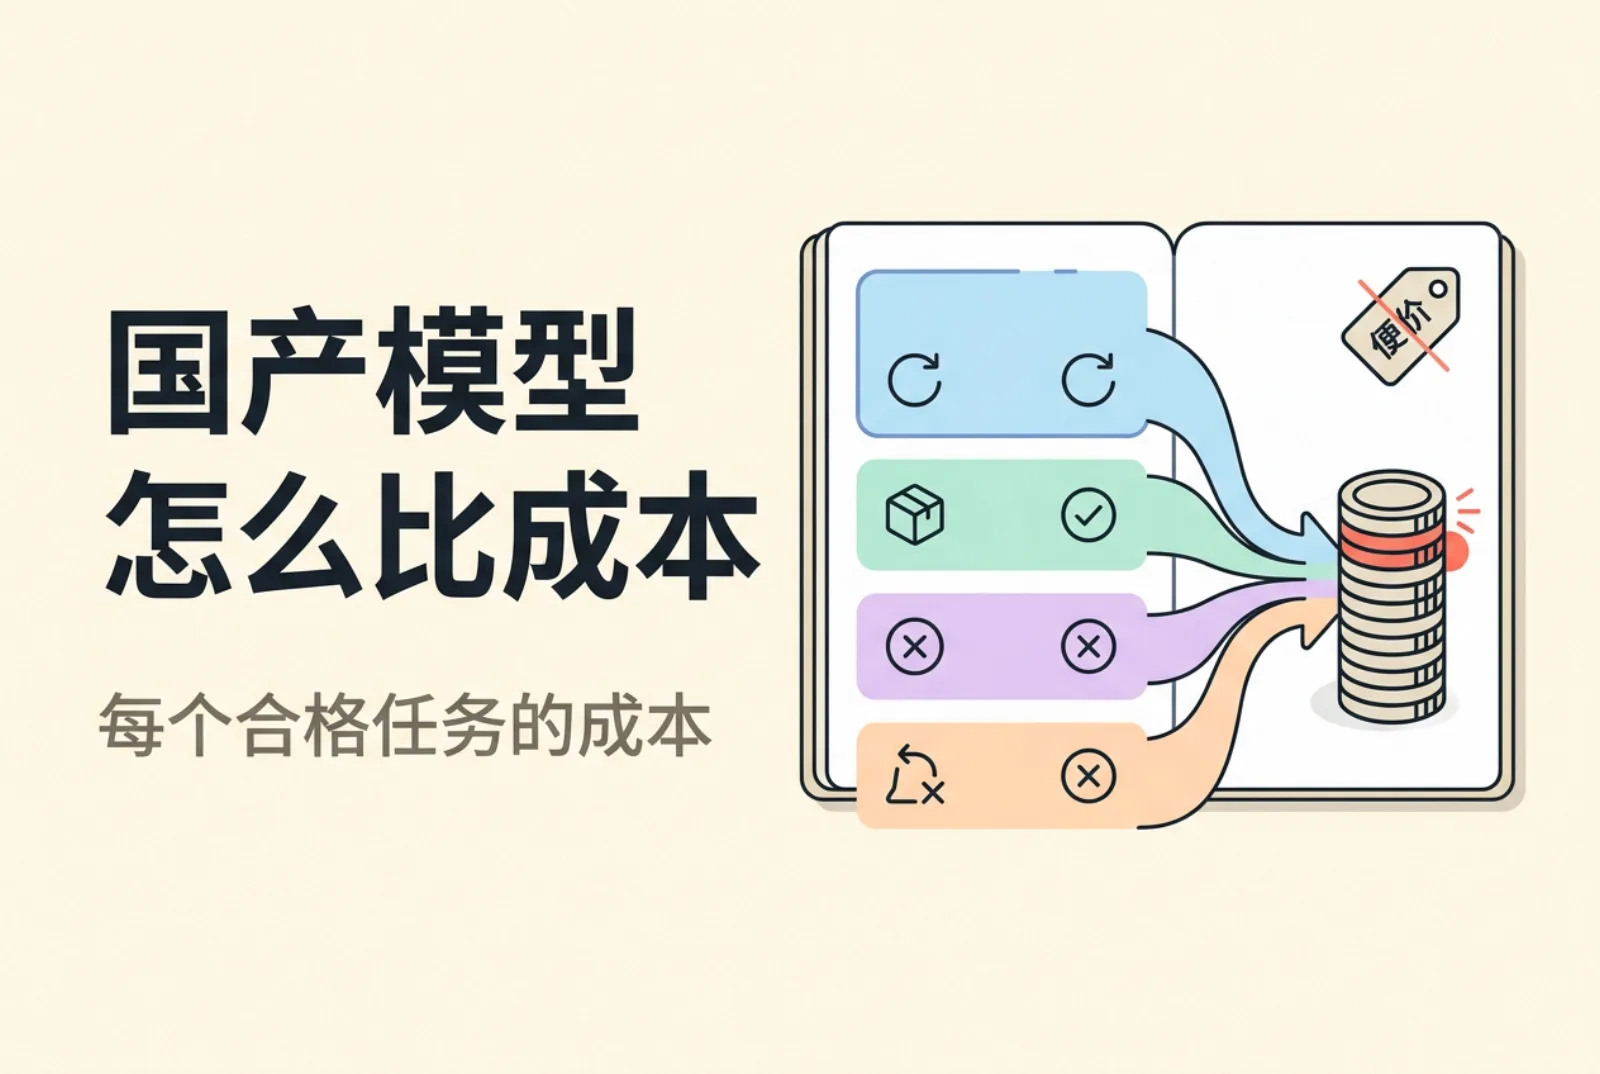
国产模型怎么比成本?把重试、缓存和失败任务记进同一本账
国产模型成本核算不能只看每百万 token 单价。本文用一份任务账本说明输入、输出、缓存命中、重试和未知费用怎样归集,并用四个虚构任务演示合格任务平均成本的计算。附日志字段、Python 算术示例和公平比较清单,帮助开发者保留质量门槛、延迟与实际费用证据,不提供实时模型价格,也不把失败调用误记为免费。
8 10 月
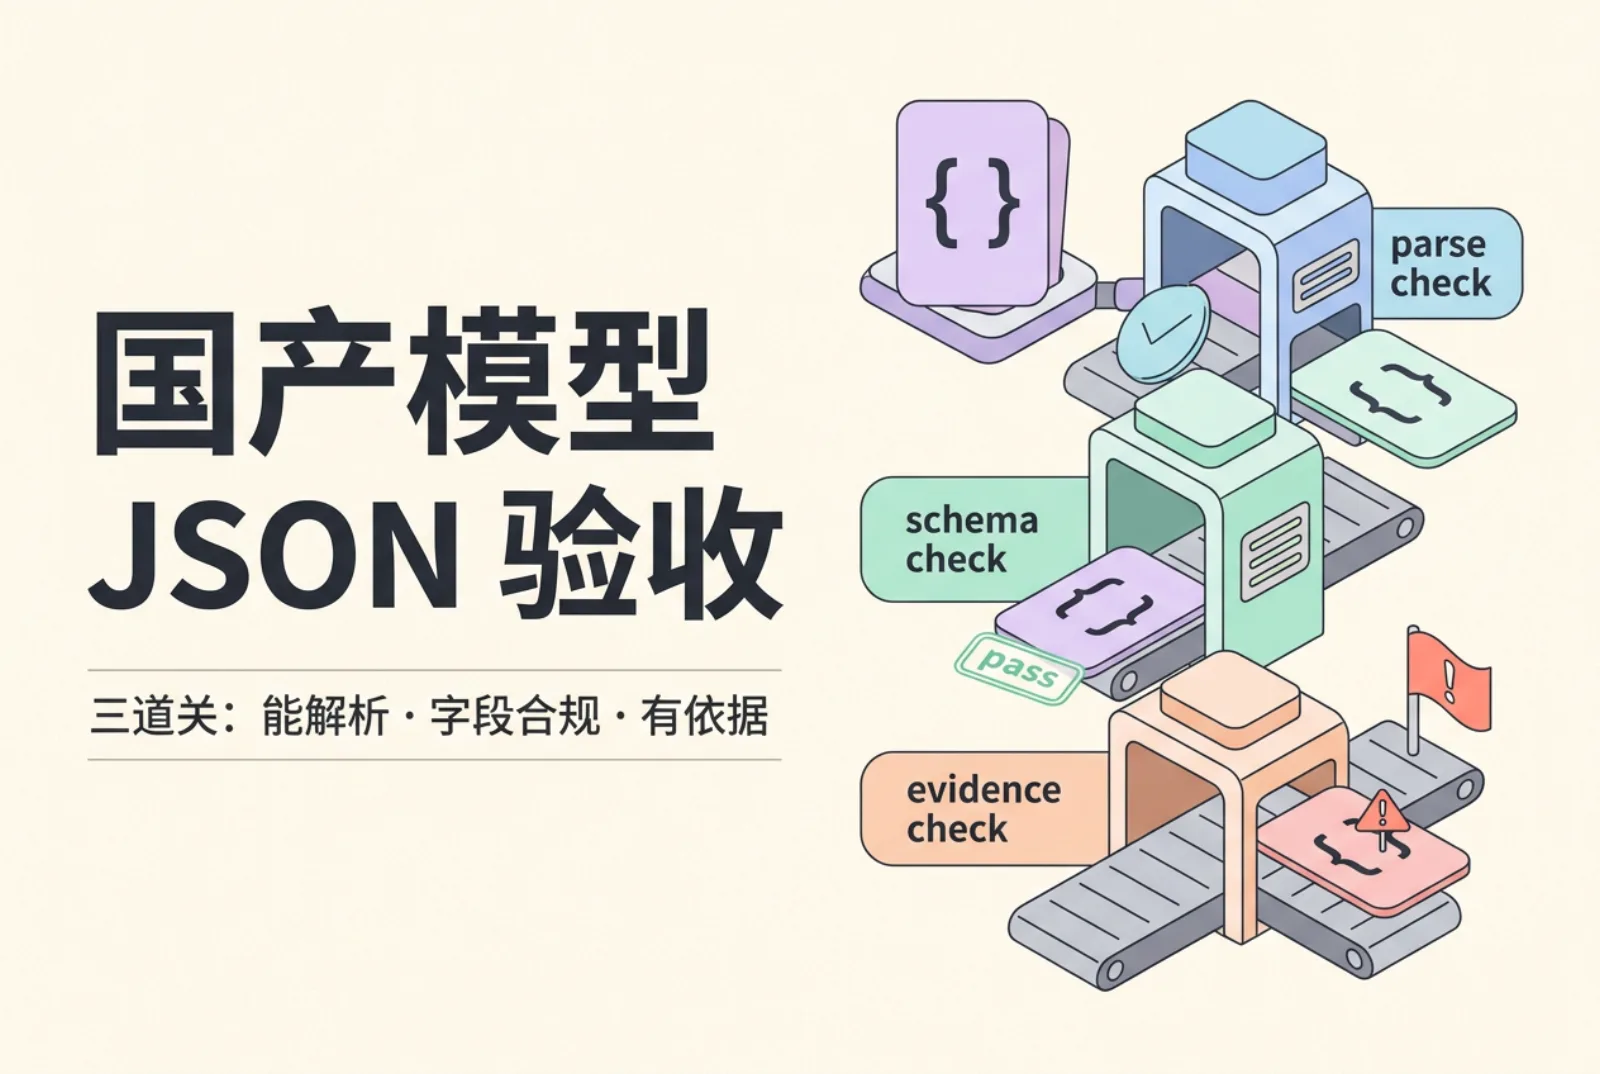
国产模型输出 JSON 就能上线?先做这套结构化验收
国产模型能输出 JSON,不代表字段正确或可以直接入库。本文提供一套包含三层校验、12 条冒烟样本设计、异常分类和人工审核门槛的验收方法,帮助开发者比较候选模型的实际业务适配性。附可复用的数据合同与测试示例,解释空响应、截断、额外字段和语义错误的处理边界,不提供未经验证的模型排名、成功率或价格结论。
13 9 月
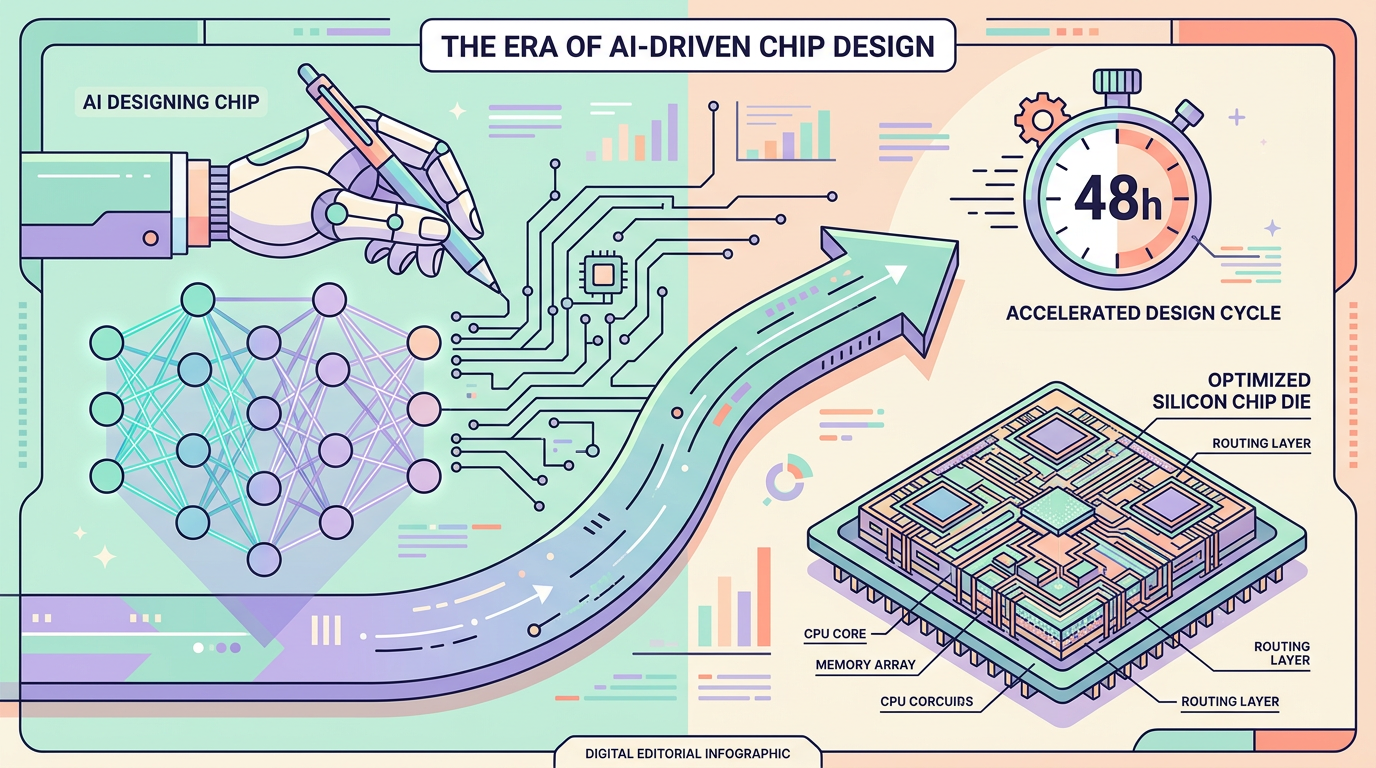
nano-kpu:Kimi K3 用 48 小时给自己设计了一颗推理芯片,这是开源芯片的「DeepSeek 时刻」吗
一句话结论:Moonshot AI 开源了 nano-kpu——一颗完全由 Kimi K3 设计、用开源 EDA 工具跑通全流程的推理芯片 RTL,48 小时完成设计,4 平方毫米、100MHz、模拟 8700 tokens/s。但它明确声明是「能力演示」,不是产品。 AI 摘要 项目用途:Kimi K3 自主设计的推理芯片 RTL 源码,含功能仿真和时序/面积综合流程。适合人群:关注 AI 自主工程、芯片设计、国产大模型的人。上手门槛:高,需要 Verilator 5 + yosys 工具链。智盒结论:作为「AI 能不能做芯片设计」的标尺很有价值,作为实际芯片还差得远,别把演示当产品。 项目信息 项目名:MoonshotAI/nano-kpuGitHub URL:https://github.com/MoonshotAI/nano-kpuLicense:Apache-2.0Star / Fork:47 / 5(截至 2026-09,早期) 它解决什么问题 严格说,nano-kpu 不解决任何生产问题。它回答的是一个更根本的问题:一个 AI 模型,能不能在没有人干预的情况下,独立完成一颗芯片的设计全流程。 答案在 Moonshot AI 的开源仓库里。nano-kpu 是一颗...
12 9 月
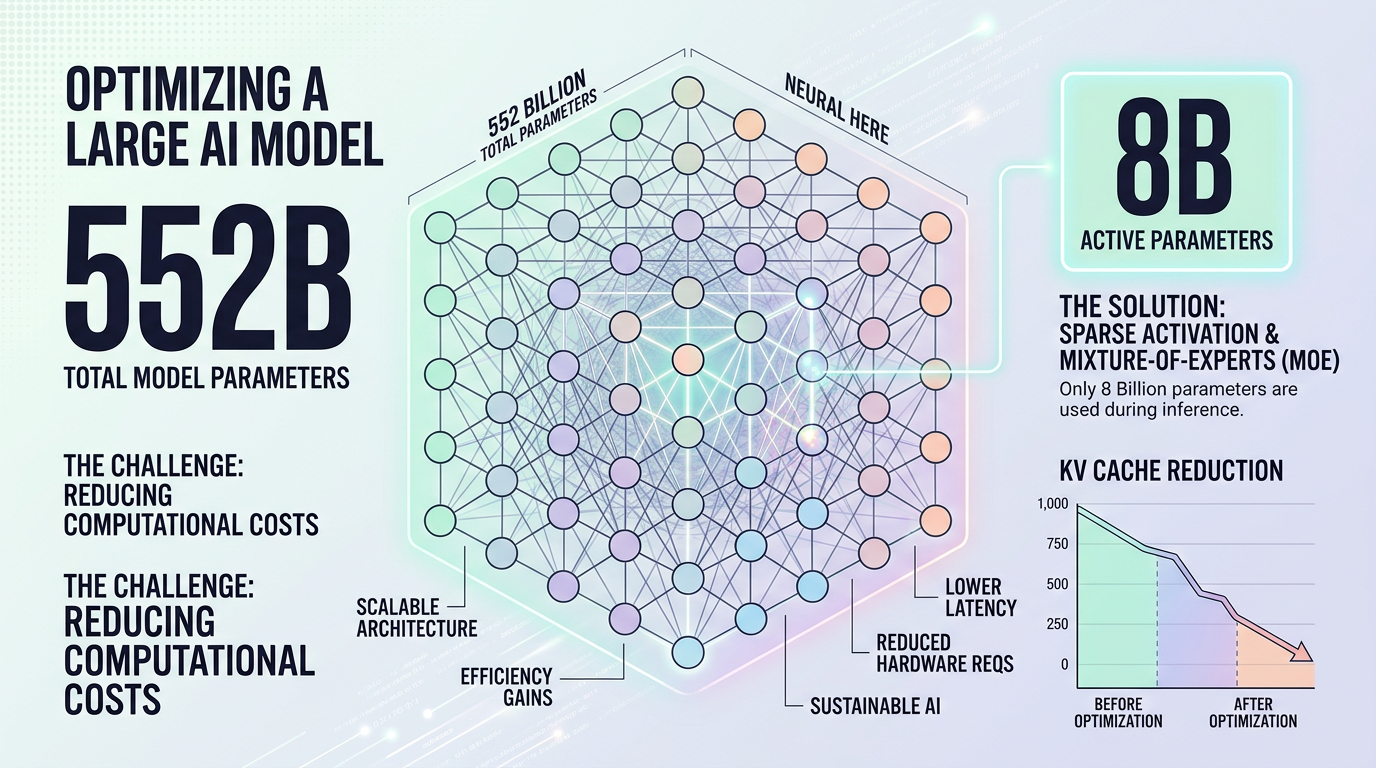
DeepSeek V4.1-Flash 发布:552B 参数只激活 8B,百万上下文还涨价前的最后一班车
一句话结论:DeepSeek 用一套新架构把 V4-Pro 这个自家旗舰直接干退役了——V4.1-Flash 在多个 Agent 基准上反超 V4-Pro,激活参数却只有它的六分之一,9 月 14 日起 V4-Pro 请求会自动路由到新模型。 AI 摘要 发生了什么:DeepSeek 9 月 10 日开源 V4.1-Flash,552B 参数的 MoE 模型,支持百万 token 上下文。核心变化:新 CED 架构让每次推理只激活 8B(输入)/16B(输出)参数,比 V4-Pro 的 49B 大幅下降。影响对象:用 DeepSeek API 的开发者、跑本地开源模型的团队、关注国产模型选型的人。下一步观察:9 月 14 日调价和 V4-Pro 退役后的实际成本变化。 发生了什么 DeepSeek 在...
6 9 月
Arena 第35周盲测榜:Qwen3.8-Max 登顶前端榜,国产模型集体冲击第一梯队
一句话结论:在 LMArena 第 35 周(8 月 24–30 日)的第三方盲测中,Qwen3.8-Max-0902 首次入榜即以 1691 分登顶前端开发榜,GLM-5.3-Flash 闯入代码榜前十,这是国产模型第一次在多个细分榜单同时逼近全球第一梯队。 AI 摘要 发生了什么:LMArena 发布 2026 年第 35 周盲测榜,多款国产新模型集体亮相。核心变化:Qwen3.8-Max-0902 前端开发榜登顶(1691 分),把 Claude Opus 5 Max 挤到第二;GLM-5.3-Flash 代码榜首进 Top 10。影响对象:国产大模型开发者、模型选型团队、关注 AI 编程工具的从业者。下一步观察:Qwen3.8-Max 的 AA 智能指数评测何时补上,以及 GLM-5.3-Flash 的排名能否站稳。 发生了什么 LMArena(arena.ai)在 9 月 2 日更新了 2026...