29 5 月

Claude Opus 4.8 发布了:4 倍更诚实、Dynamic Workflows、价格不变——GPT-5.5 还能打吗?

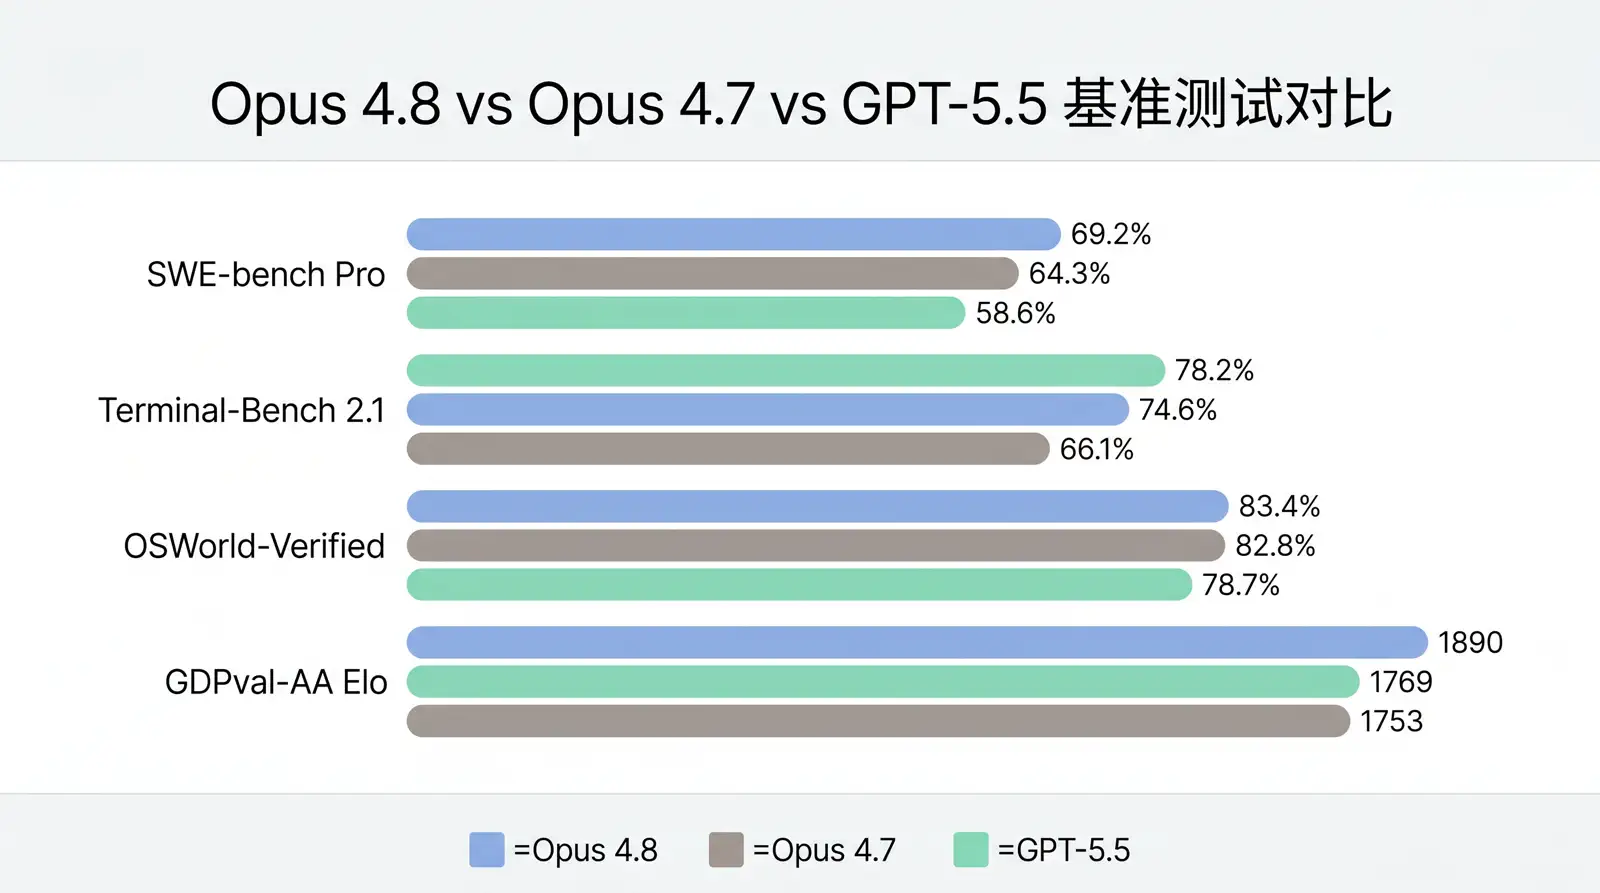
Opus 4.8 不是一次参数升级,而是一次「可靠性革命」——Anthropic 选择让模型主动告诉你「我不确定」,而不是假装知道答案。SWE-bench Pro 69.2%,价格不变,4 倍更诚实。
29 5 月

ITBench-AA 基准测试:所有前沿模型在真实企业 IT 任务中得分不及格——最高只有 47%

一个刚发布的基准测试,把 AI Agent 在企业级场景的「真面目」暴露了出来。 ITBench-AA 由 Artificial Analysis 和 IBM 联合推出,聚焦 SRE(Site Reliability Engineeri……
26 5 月

Cursor Composer 2.5 实测:一个 Kimi K2.5 微调模型,凭什么在代码基准上对标 Opus 4.7——价格只要 1/60

5 月 18 日,Cursor 发了 Composer 2.5。 没有发布会,没有博客预告。一个周日下午,版本号悄悄跳了。社区开始跑分,然后数据出来了:SWE-bench Multilingual 79.8%,比 Composer 2 高了 6 个百分点。CursorBench 默认模式下 63.2%,超过 Opus 4.7 的 61.6%。但真正让开发者社区讨论的不是分数——是价格。 Standard 模式下,每任务成本 $0.07。Opus 4.7 max 是 $4.10。差了将近 60 倍。 Key Takeaways – Composer 2.5 SWE-bench 79.8% 对标 Opus 4.7 的 80.5%,CursorBench 默认模式 63.2%...
25 5 月

Claude Managed Agents 三大新能力详解:Dreaming、Outcomes 和多代理编排,Agent 不再只是「接个 API」

5 月 6 日,Anthropic 在旧金山举办了第二届 Code with Claude 开发者大会。和去年发布新模型不同,今年他们没有发任何新模型——而是发了一套 Agent 基础设施。 Claude Code 的创作者 Boris Churnney 在台上说了一句话:”Anthropic 内部已经没有手写代码了。“与其说这是炫耀,不如说是一个信号:当一家 AI 公司自己的开发流程已经完全由 Agent 驱动,他们要解决的下一个问题就不是「模型够不够强」,而是「Agent 能不能稳定跑在生产环境里」。 这就是 Code with Claude 2026 的主题。Anthropic 为 Claude Managed Agents 发布了三个核心能力——Dreaming(跨会话记忆)、Outcomes(评分驱动的质量循环)、Multi-Agent Orchestration(多代理并行编排)——外加 Claude Finance 和 Add-ins...
25 5 月

Claude Agents 会做梦了:Anthropic 如何用"睡眠学习"让 AI Agent 从工具进化为同事

2026年5月Anthropic发布Dreaming功能,让AI Agent在会话间"做梦"学习。深度解析四阶段Consolidation、Harvey 6倍完成率案例,以及Agent记忆如何成为2026年AI新战场。