15 9 月

Colibri:纯 C 零依赖推理引擎,让前沿 MoE 模型跑在普通硬盘上

一句话结论:开源项目 Colibri 用纯 C 语言写了一个零依赖的 MoE 推理引擎,核心思路是不把整个模型的专家权重一次性装进显存,而是推理时从硬盘按需流式加载稀疏专家。这让前沿规模的混合专家模型第一次有可能跑在普通消费级硬件上,项目因此冲上了 GitHub Trending。 AI 摘要 项目是什么:Colibri,一个纯 C、零外部依赖的 MoE 模型推理引擎,作者 JustVugg。核心思路:推理时从磁盘流式加载稀疏 MoE 专家权重,而不是预加载整个模型到显存。价值:大幅降低前沿模型对显存和企业级硬件的依赖,推动本地化部署。适用边界:牺牲了部分速度换取显存门槛,适合实验和本地部署,不是云推理的替代。 Colibri 是什么 Colibri 是一个开源的 MoE 模型推理引擎,作者是开发者 JustVugg。它最近冲上了 GitHub Trending,原因是解决了一个很具体的问题:前沿混合专家(MoE)模型太大,普通电脑跑不动。 MoE 模型的特点是「大而稀疏」。像 DeepSeek、Kimi 这类模型,总参数动辄几百亿甚至上万亿,但每次推理只激活其中一小部分专家。问题在于,传统推理引擎为了速度,会把全部专家权重都预加载进显存——哪怕大部分专家这次根本用不到。这就把门槛拉到了需要企业级显卡集群的高度。 Colibri 换了个思路。它不预加载,而是推理到哪个专家,就从硬盘把哪个专家的权重流式读进来。这样显存里只放当前需要的那部分,门槛一下子就降下来了。 它凭什么跑得动前沿 MoE 关键在两点:纯 C,和零依赖。 纯 C 意味着没有 Python 运行时、没有深度学习框架的层层封装,推理路径短,内存开销可控。零依赖意味着它不依赖 CUDA 之外的任何重型库,部署简单。 流式加载是这个设计的核心。MoE 模型每一层有几十个专家,一次推理只会命中其中几个。Colibri 把这个「命中」和「从磁盘读取」绑定在一起,用 I/O 换显存。代价是速度会慢一些——磁盘读写总比显存慢——但换来的是一台普通电脑也能跑前沿模型的可能。 这跟
12 9 月

DeepSeek V4.1-Flash 发布:552B 参数只激活 8B,百万上下文还涨价前的最后一班车

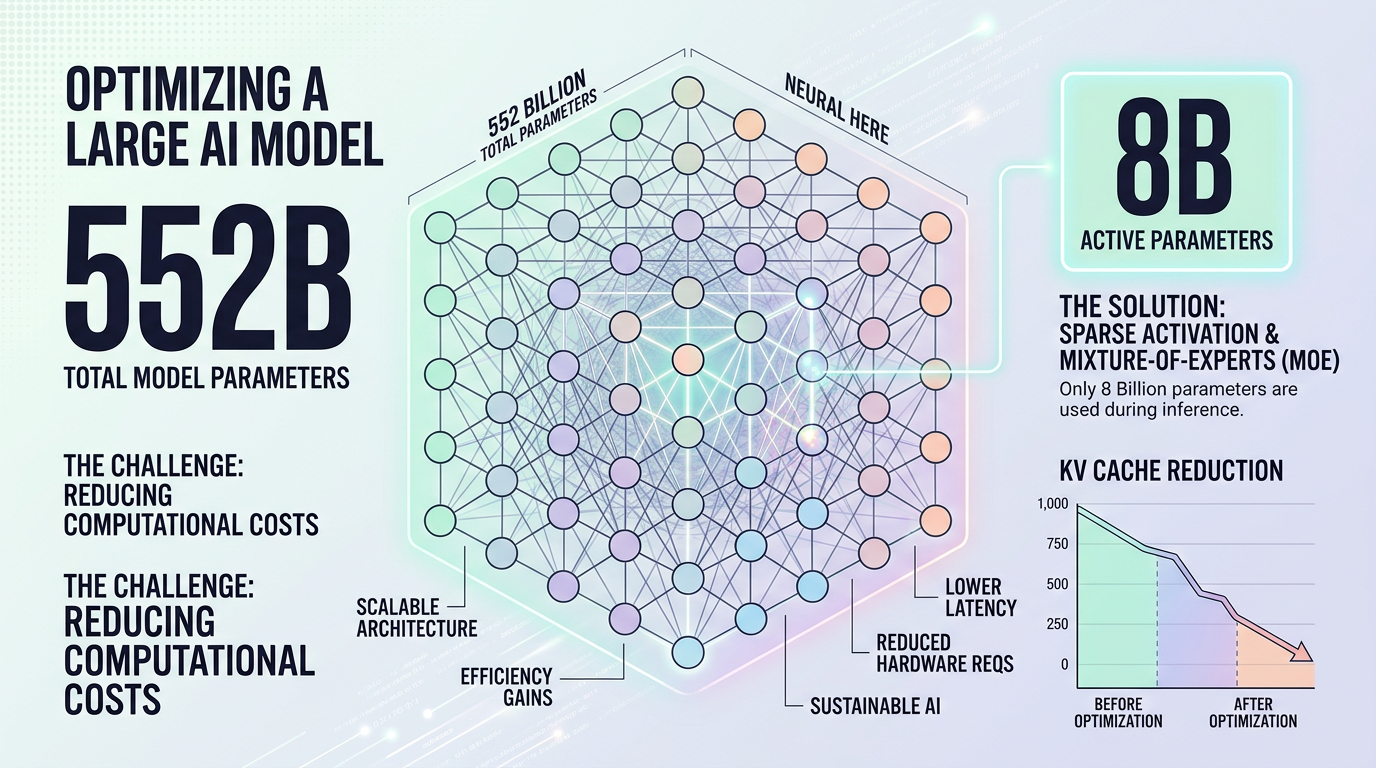
一句话结论:DeepSeek 用一套新架构把 V4-Pro 这个自家旗舰直接干退役了——V4.1-Flash 在多个 Agent 基准上反超 V4-Pro,激活参数却只有它的六分之一,9 月 14 日起 V4-Pro 请求会自动路由到新模型。 AI 摘要 发生了什么:DeepSeek 9 月 10 日开源 V4.1-Flash,552B 参数的 MoE 模型,支持百万 token 上下文。核心变化:新 CED 架构让每次推理只激活 8B(输入)/16B(输出)参数,比 V4-Pro 的 49B 大幅下降。影响对象:用 DeepSeek API 的开发者、跑本地开源模型的团队、关注国产模型选型的人。下一步观察:9 月 14 日调价和 V4-Pro 退役后的实际成本变化。 发生了什么 DeepSeek 在...
5 9 月

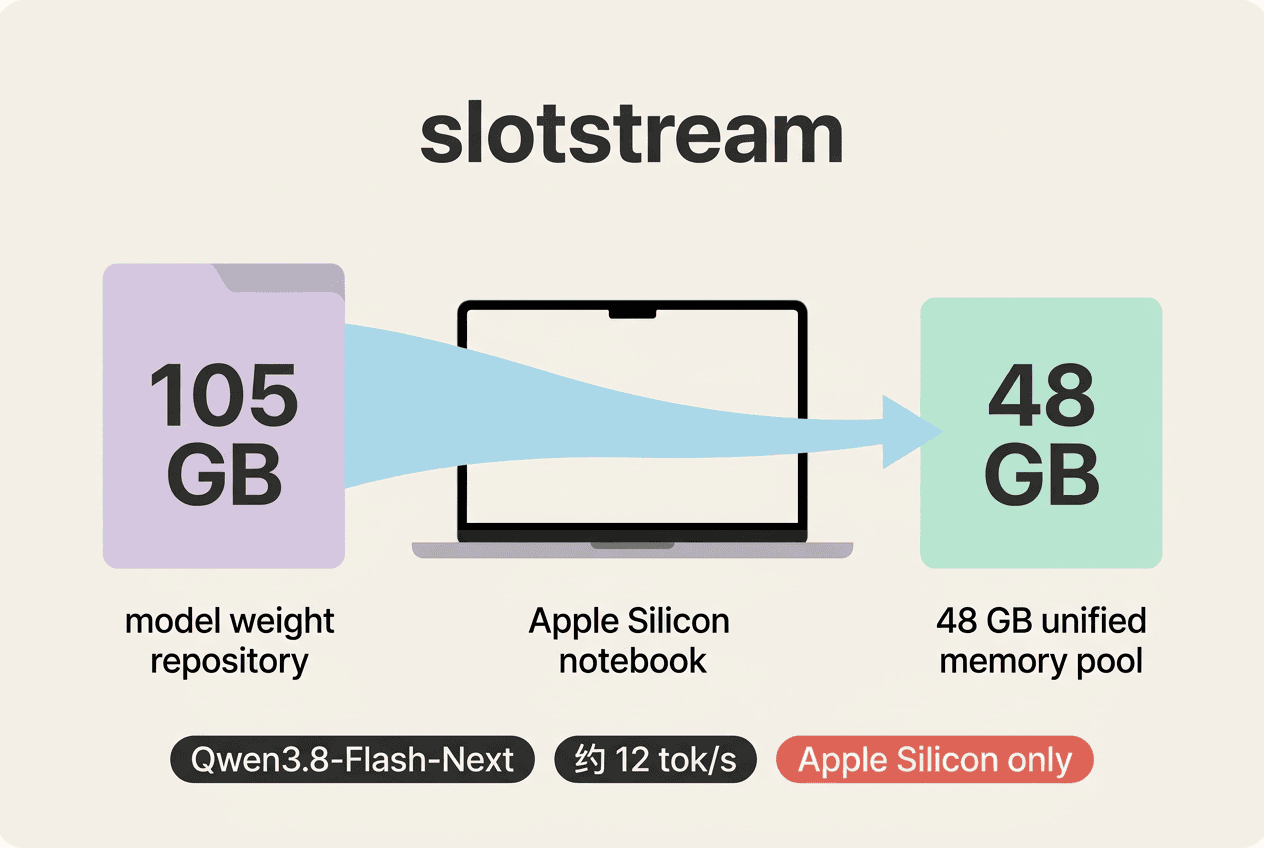
slotstream:105 GB 的 Qwen3.8-Flash-Next,怎样在 48 GB Mac 上跑到约 12 tok/s

slotstream 用 SSD 流式读取 MoE 专家权重,让 105 GB 的 Qwen3.8-Flash-Next 在 48 GB Apple Silicon Mac 上运行。本文核验它的机制、门槛、速度边界与适用人群。
27 7 月

Kimi K3 幻觉率 51%:开源模型的自信回答越准确,编造的风险也越高

一句话结论:Moonshot 7 月 27 日开源的 Kimi K3 在自信回答中有 51% 是编造的,幻觉率较前代 K2.6 的 39% 明显上升。但同期的准确率也从 33% 提升至 46%——Kimi K3 变得更"敢说"了,代价是说错的比例跟着涨了。 51% 的幻觉率意味着什么? Artificial Analysis 评测的独立评测显示,Kimi K3 在其自信回答中,有 51% 的内容是编造的。换句话说,当 Kimi K3 拒绝承认自己不知道、而是给出一个听起来有道理的答案时,这个答案有一半以上的概率是错的。 这是一个需要被认真对待的数字,但它并非 Kimi K3 独有的问题。对照组 Claude Fable 5 在同一基准上的幻觉率为 54.9%,甚至更高。幻觉是当前大语言模型的一个系统性问题,而非某一厂商或某一模型的"故障"。 相比前代 Kimi K2.6...
3 7 月

美团 LongCat-2.0:1.6 万亿参数编码模型,100% 国产芯片训练,全开源

美团发布 LongCat-2.0:1.6万亿参数 MoE 编码模型,5万张国产芯片全流程训练,全开源。不到一年参数规模从5600亿翻三倍。全栈自主训练可行性获验证。