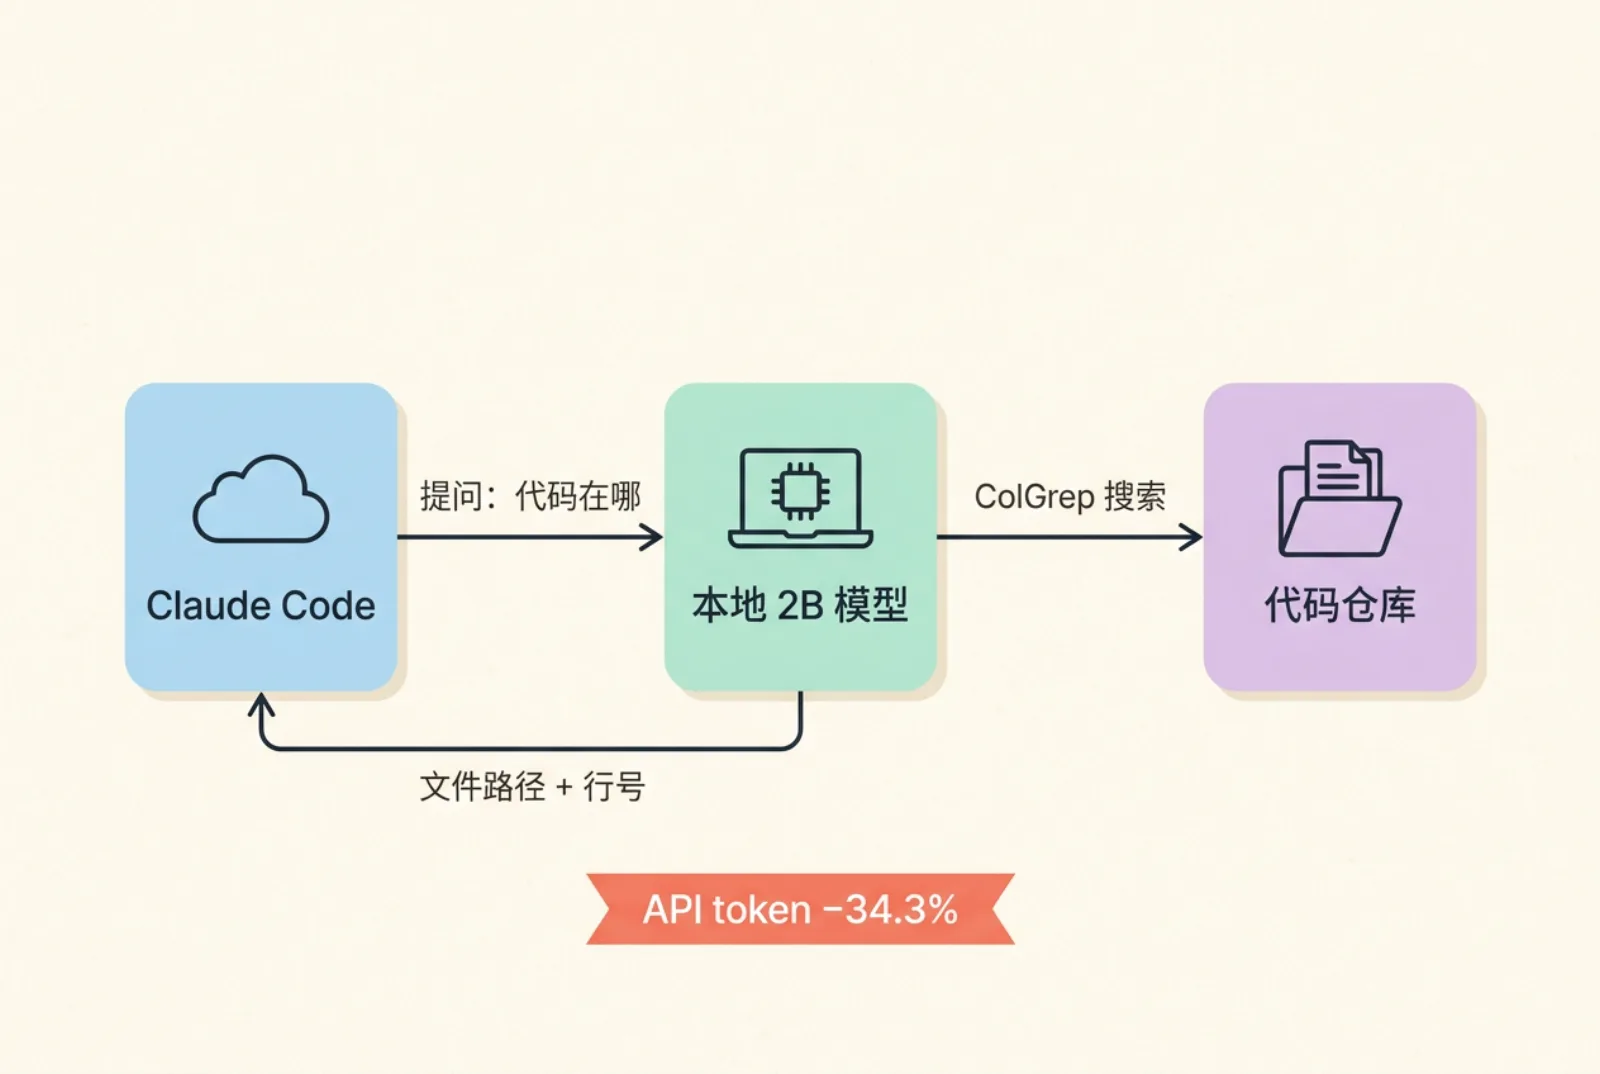
一句话结论:ColGrep-Agent-2 B 是 LightOn 2026 年 10 月 12 日开源的本地代码搜索模型(Apache 2.0),基于 MiniCPM 5-2 B 微调。Claude Code、Codex 遇到「这段逻辑在哪个文件」这类问题时,可以交给它在本机检索,再只把文件位置和代码片段交回主 Agent。官方用 Claude Code + Sonnet 5.5 在 13 个仓库、624 次会话里测试:API token 平均减少 34.3%,每题成本从 7.3 美分降到 4.4 美分,代价是每题耗时从 13.0 秒增加到 21.6 秒,准确率从 83.3% 降到 80.8%(差异不显著)。
ColGrep-Agent-2 B 是一个专门做「代码定位」的小模型。给它一个关于仓库的自然语言问题,比如「重试次数在哪里配置」,它会用 ColGrep 反复搜索、通过只读终端打开候选文件,最后返回相关的文件路径、行号范围和代码片段。
它要解决的是编程 Agent 的一项隐性开销。Claude Code 这类工具在动手修改之前,常常要先用 grep 搜好几轮、打开一堆文件,这些搜索结果都会进入上下文,按 API token 计费。LightOn 的思路是把这一步交给本地的 2 B 模型:本地模型产生的 token 不收费,主 Agent 只收到整理好的结果。
ColGrep 本身是 LightOn 此前开源的本地语义代码搜索工具,把正则过滤和语义排序结合起来,是一个打包好一切依赖的 Rust 单文件程序。ColGrep-Agent-2 B 在 MiniCPM 5-2 B 基础上先做少量监督微调,再用 GRPO 强化学习训练,让它学会调用 ColGrep 搜索。模型卡标题写 2 B,Hugging Face 文件元数据显示约 3 B 参数。
最适合的是这三类人:
不太适合的情况:仓库很小、grep 一两次就能找到;或者对响应速度很敏感,不愿意每题多等几秒。如果你更关心让 Claude Code 少走弯路的使用习惯,可以先看 Claude Code 自动模式的 5 个步骤;如果问题是 Agent 引用了过时的 API,Context 7 是更对口的工具。
官方给了四种安装方式,安装 ColGrep 后再执行 --install-agent 下载模型:
| 平台 | 安装命令 |
|---|---|
| macOS / Linux(Homebrew) | brew install lightonai/tap/colgrep && colgrep --install-agent |
| macOS / Linux(安装脚本) | 从 GitHub Release 下载 colgrep-installer.sh 执行,再运行 colgrep --install-agent |
| Windows(PowerShell) | 从 GitHub Release 下载 colgrep-installer.ps1 执行,再运行 colgrep --install-agent |
| 已装 Rust | cargo install colgrep && colgrep --install-agent |
安装后三步用起来:
colgrep initcolgrep --agent "where are retries configured",加 --json 可以得到结构化输出colgrep --install-claude-code,Codex 用 colgrep --install-codex,OpenCode 用 colgrep --install-opencode默认模型文件是 colgrep-agent-2B-Q8_0.gguf,约 2.5 GB。推理支持 Apple Silicon 的 Metal、NVIDIA/AMD/Intel 显卡的 Vulkan,也可以只用 CPU。官方在 M 3 Pro 上测试,一个问题约 20 秒,峰值内存 3~4 GB。整个过程不需要 Python 环境、推理服务或 API Key。
colgrep --install-claude-code 会给 Claude Code 装上 hooks(钩子)。按官方说明,这些 hooks 只是「建议」Claude 使用这个搜索工具,并不强制,Claude 仍可能自己用 grep。
搜索行为可以用 colgrep settings --hook-mode 切换三种模式:
官方测试里的「Balanced」配置在准确率上和 grep 持平(83.3%),token 少用 21.2%,适合不想牺牲准确率的人。具体每种模式对应哪组测试结果,以官方文档为准。
LightOn 用 Claude Code + Sonnet 5.5 做测试,由 Claude Opus 5.5 出题和评分。题库是 13 个 2026 年新建的公开仓库(Rust、Go、TypeScript、Python,规模从 1.7 万行到 180 万行),每个仓库 4 道题,每题跑 3 次,四种配置共 624 次会话。
| 配置 | token 节省 | 每题成本(计入缓存) | 准确率 | 每题耗时 |
|---|---|---|---|---|
| Grep(基线) | — | 7.3 美分 | 83.3% | 13.0 秒 |
| ColGrep | 24.6% | 6.0 美分 | 79.5% | 15.0 秒 |
| ColGrep-Agent | 34.3% | 4.4 美分 | 80.8% | 21.6 秒 |
| Balanced | 21.2% | 5.1 美分 | 83.3% | 17.7 秒 |
读这张表要注意四点:
想把这类节省落到账本上,可以参考 把重试和失败任务记进同一本账,按任务而不是按单次调用统计成本。
如果你还想在本机跑通用对话模型,Windows 用户可以看 Llama Windows 托盘应用,它和 ColGrep-Agent 一样都用 GGUF 格式的本地模型。
是。模型权重以 Apache 2.0 许可发布在 Hugging Face,ColGrep 工具所在的 next-plaid 仓库同样是 Apache 2.0。它在本地运行,不需要账号和 API Key,唯一的成本是本机算力:默认模型约 2.5 GB,Apple Silicon 上峰值内存 3~4 GB。
不一定。34.3% 是官方在 52 道代码搜索题上的平均值,置信区间 28%~40%,而且只统计「找代码」这一步。你的仓库大小、提问方式,以及 Claude 是否采纳 hooks 的建议,都会影响实际节省。建议先在自己的项目里对比一周账单。
支持。官方提供 PowerShell 安装脚本,推理可以走 Vulkan(NVIDIA、AMD、Intel 显卡)或 CPU。官方性能数据是在 M 3 Pro Mac 上测的,Windows 上的速度需要自己测。
grep 按字符串匹配,结果全部进入主 Agent 的上下文;ColGrep 先做语义排序,ColGrep-Agent 还会在本地读文件、筛选,只把结论交给主 Agent。代价是更慢:官方测试中每题多花约 8.6 秒。