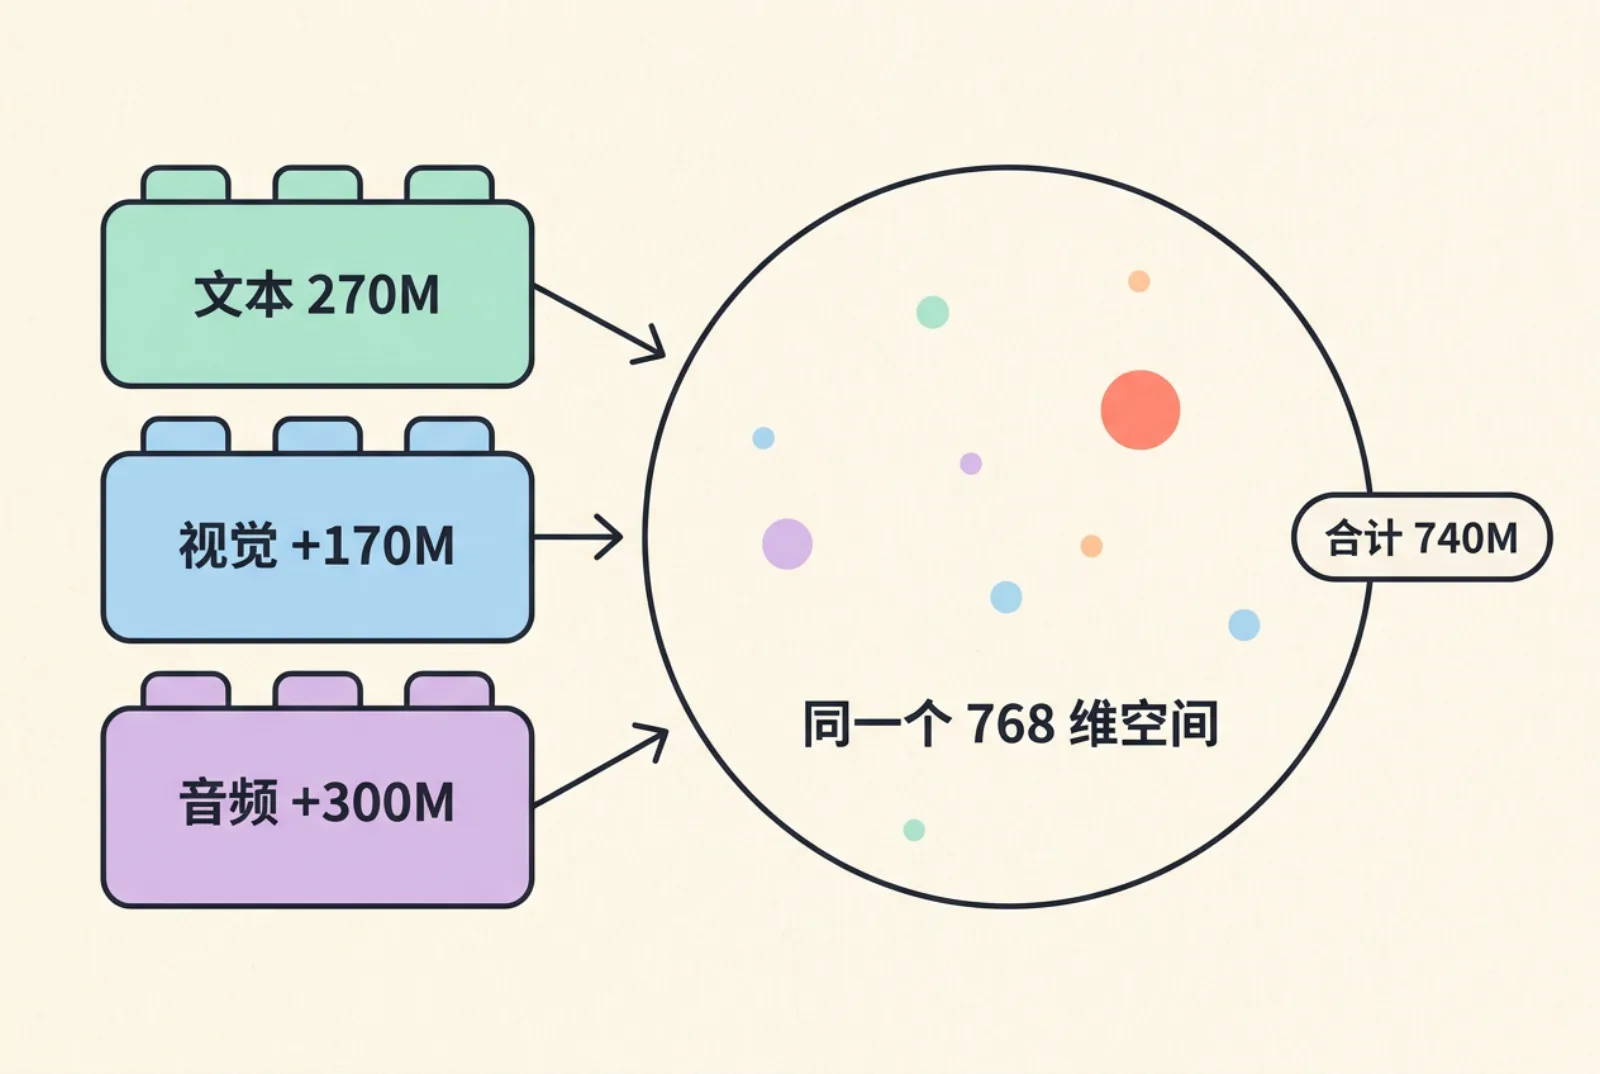
一句话结论:EmbeddingGemma 2 是 Google DeepMind 2026 年 10 月 6 日开源的多模态嵌入模型,Apache 2.0 协议,能把文本(含代码)、图片、视频和音频映射到同一个 768 维向量空间,适合做本地语义搜索、RAG 和分类。它采用模块化设计:只用文本时加载 270 M 参数,加上视觉和音频编码器共 740 M。Google 称量化后在 Pixel 11 Pro 上纯文本仅占约 191 MB 内存,全模态约 567 MB。代码检索基准 MTEB Code 从上一代的 68.76 提升到 78.68,但多语言文本基准几乎持平(61.15 → 61.36),官方没有单独公布中文成绩。
嵌入模型的作用是把一段内容变成一串数字(向量),内容越相近,向量距离越近。RAG 知识库、语义搜索、去重、聚类都靠它。EmbeddingGemma 2 的特别之处在于多模态共用一个空间:一句「防水越野跑鞋」可以直接和商品图片、演示视频、语音片段比较相似度,不用分别训练几套模型再拼接。
模型卡列出的用途包括:跨文本、代码、图片、视频、音频的语义检索;企业知识库 RAG;用自然语言搜代码;情感分类、内容审核、音频事件识别;按主题聚类用户反馈;为事实核查检索证据文档。
它基于 Gemma 4 架构,训练数据覆盖 140 多种语言,官方称理解 100 多种语言,数据截止 2025 年 1 月。和 ColGrep-Agent-2 B 本地代码搜索 这类「生成式小模型」不同,嵌入模型只输出向量,不生成文字,通常作为搜索系统的底层组件。
适合:
不适合:
官方推荐用 sentence-transformers(版本不低于 6.1.0,旧版不能正确处理多模态输入的顺序):
pip install -U sentence-transformers transformersfrom sentence_transformers import SentenceTransformer
model = SentenceTransformer("google/embeddinggemma-2")
q = model.encode("北极光是怎么形成的?", prompt_name="SearchQuery")
d = model.encode("北极光由太阳风中的带电粒子撞击大气产生。", prompt_name="Document")
print(model.similarity(q, d))以上代码来自官方模型卡示例(问题文本改为中文),本站未在本机实测。三个用法要点:
SearchQuery,文档用 Document;有标题的文档写成 title: 标题 | text: 正文。分类、聚类、相似度各有自己的前缀,不加也能用但精度会下降config_kwargs={"vision_config": None, "audio_config": None},模型降到 270 Mmodel.encode(..., truncate_dim=256, normalize_embeddings=True),查询和文档必须用同一维度除了 Python,官方列出的接入方式还有 MediaPipe、LiteRT、transformers.js、WebGPU(浏览器端)、MLX、vLLM、llama.cpp、SGLang、Ollama、LM Studio,向量库集成 Qdrant,微调用 Unsloth。
所有模态共用 8,192 token 的上下文,按固定比例消耗:
| 模态 | 消耗 | 单独输入上限 |
|---|---|---|
| 文本 | 每个子词 1 token | 8,192 token |
| 图片 | 每张 280 token(默认) | 约 29 张 |
| 视频 | 每帧 140 token,默认每秒 1 帧 | 约 58 帧 |
| 音频 | 每秒 25 token,需 16 kHz 单声道 | 约 327 秒 |
以下为模型卡公布的全精度、768 维成绩,均为 Google 自测:
| 模态 | 基准 | EmbeddingGemma 2 | 上一代 |
|---|---|---|---|
| 文本 | MTEB 多语言 v 2 | 61.36 | 61.15 |
| 代码 | MTEB Code v 1 | 78.68 | 68.76 |
| 图像 | MIEB lite | 64.64 | 不支持 |
| 视觉文档 | MMEB v 2 VisDoc | 67.84 | 不支持 |
| 视频 | MMEB v 2 Video | 50.67 | 不支持 |
| 音频 | MSEB 检索 | 69.54 | 不支持 |
维度截断的影响:从 768 维截到 256 维,多语言文本分数从 61.36 降到 60.41;截到 128 维,多模态总分从 59.01 降到 45.65。官方结论是 256 维以上接近无损,128 维只适合纯文本任务。Google 博客称它在 1 B 以下多模态嵌入模型中,MTEB Code 和 MAEB 两项排名第一,并「超过一些两倍体积的专用模型」,但没有点名对比对象。
如果你的知识库还需要图谱和长期记忆,可以参考 Cognee 知识图谱记忆;想把生成模型也放在本地,可看 Llama Windows 本地大模型托盘工具。
可以。EmbeddingGemma 2 以 Apache 2.0 协议发布,可以免费使用、修改和商用,Hugging Face 仓库不需要申请访问。部署时需遵守 Gemma 的禁止用途政策。
支持。官方称模型理解 100 多种语言,训练数据覆盖 140 多种语言,但没有单独公布中文检索成绩,多语言 MTEB 总分为 61.36,与上一代基本持平。中文为主的项目建议先用自己的数据测试召回率。
第一代是 300 M 的纯文本模型,上下文 2 K。第二代新增图片、视频、音频三种模态,上下文扩到 8 K,代码检索分数从 68.76 提升到 78.68;只用文本时体积为 270 M,比第一代略小。
文本版 270 M 参数,普通笔记本 CPU 即可运行。Google 称量化后在 Pixel 11 Pro 手机上纯文本约占 191 MB 内存,全模态约 567 MB。注意不要用 float 16 推理。