
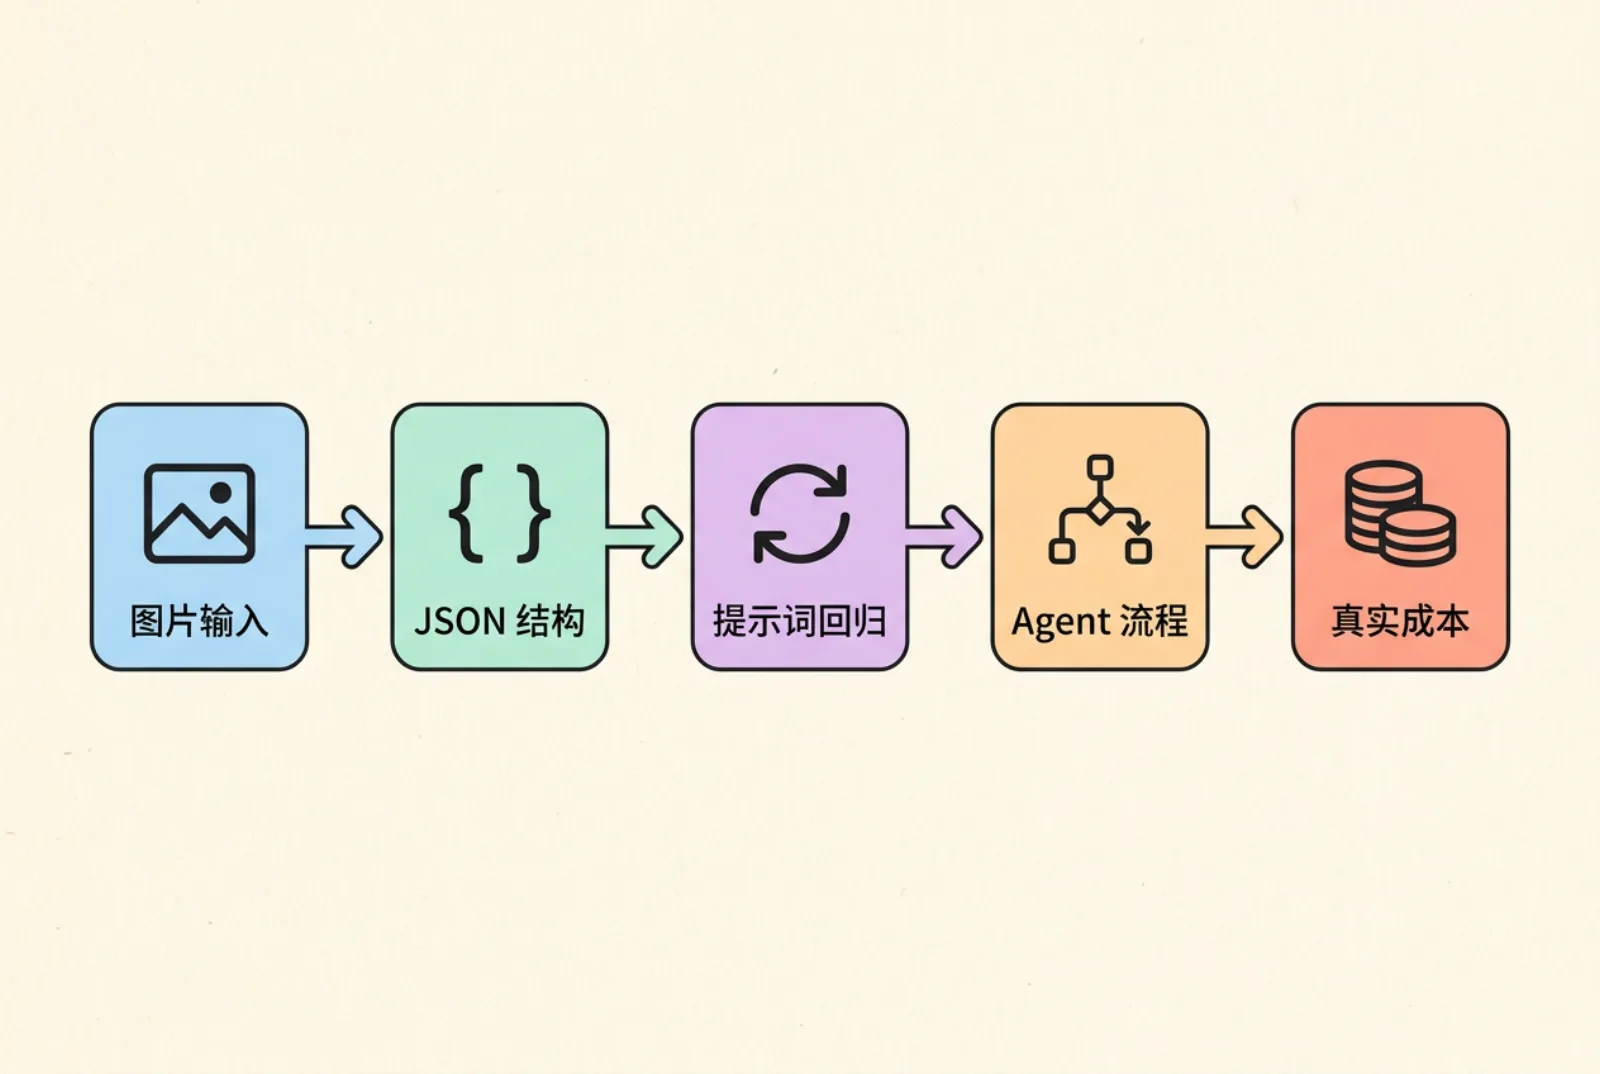
一句话结论:AI 输出验收工具链是一套把大模型接入业务前的检查流程,分五段:输入图片怎么压缩和缩放、输出 JSON 怎么校验、提示词改动怎么做回归、Agent 流程怎么画清停止条件、成本怎么按真实用量记账。本页把智盒 2026 年 10 月发布的 10 篇实操文章和 2 个免费在线工具(模型输出 JSON 校验器、大模型 API 成本估算器)按这五段串起来,每段都给出先读哪篇、用什么工具、验收标准是什么。
演示时跑通一两次,只说明模型「能」完成任务,不说明它「稳定地」完成任务。上线前最常见的四类问题是:输入图片被压缩后小字丢失、输出 JSON 少字段或类型不对、提示词改短后原来答对的样本开始出错、Agent 在失败或超时后不停重试。这些问题在少量手工测试里很难暴露,等到线上批量运行才出现,代价最高。
验收工具链的思路是把每一类问题变成可以重复运行的检查:固定一批样本、写下通过标准、用命令或工具自动比对。下面五个环节按数据在系统里流动的顺序排列,可以从任何一段开始补。
让模型读截图、发票、图表之前,先决定图片的尺寸上限和压缩方式。压缩太狠会让小数点、表格细线和小字消失,模型识别错了也不会报错。
验收标准:压缩后的版本在关键字段上和原图识别结果一致,再采用。
模型「能输出 JSON」和「输出的 JSON 能直接入库」是两回事。字段缺失、类型错误、枚举越界、空响应都需要单独检查,而且结构正确不等于内容正确。
验收标准:冒烟样本全部通过结构校验,失败样本被正确拦截,且有人工抽查内容事实。
把提示词改短、换模型或加规则后,常见的情况是修好了几个错例,同时把原本答对的样本改错了。只看新错例无法发现这种退步。
验收标准:新版本在保留集上的正确数不低于旧版本,退步样本逐条有解释。
Agent 能调用工具、发邮件、改数据,风险集中在异常路径:审批被拒、超时、重复执行、什么时候停下。只画正常流程的设计图会掩盖这些问题。
验收标准:每个会产生外部副作用的步骤,都能在图上找到拒绝、超时和停止三条出路。
按「每百万 token 单价」比模型,会漏掉缓存命中、思考 token、联网搜索、失败重试和缺失的用量记录。账单要以成功完成的任务为单位来算。
验收标准:用一周真实日志算出的「每个合格任务成本」,和估算器的结果差距在可解释范围内。
不必五步一次做完。按问题出现的位置选起点:
| 你遇到的情况 | 先做 | 用到的文章或工具 |
|---|---|---|
| 模型读图经常认错数字 | 第一步 | Squoosh 对照、Sharp 预处理 |
| 输出入库时报错或字段缺失 | 第二步 | JSON 验收方法、JSON 校验器 |
| 改提示词后用户投诉变多 | 第三步 | 保留集回归、Promptfoo |
| Agent 偶尔重复执行或停不下来 | 第四步 | Mermaid 流程审查 |
| 月底账单比预估高很多 | 第五步 | 任务账本、jq 日志、成本估算器 |
已经在用 DeepSeek 跑 Claude Code 或 Agent 的团队,建议先做第五步:2026 年 11 月 1 日起 DeepSeek 的联网搜索按次计费,详见 DeepSeek V 4.1 Flash 1017 价格报道。
跑分衡量模型在公开基准上的平均能力,验收衡量模型在你自己的业务样本上是否稳定达标。同一个模型跑分很高,也可能在你的字段格式、图片质量或流程约束下频繁出错,所以上线前必须用自己的样本做验收。
不需要。本页提到的 jsonschema、Promptfoo、Mermaid CLI、jq、Sharp、Squoosh 都是开源或免费工具,两个在线工具由智盒免费提供,在浏览器本地计算,数据不上传。
至少做三项:用同一批冒烟样本跑 JSON 结构校验,用保留集对比新旧模型的正确数,用一周真实用量估算新模型的月度费用。三项都通过再切换。

评论 (1)
[…] 会话日志能说明 Agent 做了什么,但不能证明结果正确。验收环节的做法见 AI 输出验收工具链。 […]
评论被关闭。