一句话结论:DeepInfer 是 DeepSeek 在 2026 年 10 月开源的大规模推理框架,Apache 2.0 协议,官方称它就是 DeepSeek V 4.1 Flash 线上服务所用的引擎,单个集群每天处理 155 万亿 token。目前只支持 V 4.1 Flash 一个模型,硬件限 NVIDIA SM 100 GPU 和华为昇腾 950 NPU。这次开源的是离线推理引擎,完整线上服务还需要的 KV 缓存系统、预填充与解码分离、负载均衡并未包含。官方给出的最小高效部署单元是预填充 64 卡加解码 64 卡,适合云厂商和推理平台研究,不适合个人或小团队直接部署。
推理框架负责把训练好的模型变成可以对外提供服务的系统:接收请求、调度批次、调用 GPU 内核、管理缓存。DeepInfer 是 DeepSeek 自己的推理框架,README 写明它是「DeepSeek 大规模生产服务背后的高性能推理框架」,这次开源的是其中的离线推理部分。
它最初主要基于 vLLM 构建,并参考了 SGLang 和 TensorRT-LLM,致谢部分明确列出了这三个项目。在此基础上,DeepSeek 接入了自家此前开源的内核库:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,以及用 TileLang 写的自定义算子。
部署问答文档给出了它在生产环境的规模:单个集群每天处理 155 万亿 token,按空闲时段价格计算,整体收入为每 GPU 小时 38 美元。这些是 DeepSeek 官方数字,没有第三方核实。V 4.1 Flash 模型本身的介绍见 DeepSeek V 4.1-Flash 发布报道。
README 列出的功能和配置方式:
| 能力 | 作用 | 启用方式 |
|---|---|---|
| DSpark 投机解码 | 用草稿 token 加速解码,按置信度安排验证 | DEEPINFER_ENABLE_MTP_VARLEN=1,草稿长度默认 5 |
| SWA 有界重放 | 解码端只重放有限长度的后缀,减少预填充计算 | DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact |
| 异步调度 | CPU 排批与 GPU 计算重叠 | 默认开启 |
| 批次不变推理 | 同一请求在不同批次组合下结果一致 | DEEPINFER_BATCH_INVARIANT=1(仅 NVIDIA) |
| 确定性采样 | 相同输入和采样参数得到相同输出 | 批次不变 + 关闭投机解码 + 固定 seq_seed(仅 NVIDIA) |
| 结构化输出 | 用正则、JSON Schema 或 EBNF 约束生成 | SamplingParams 传 so_args |
其中「批次不变」和「确定性采样」对做评测和回归测试的团队有用:同一条输入不会因为和别的请求拼在同一批而得到不同结果。结构化输出可以从生成阶段就约束 JSON 格式,生成后的校验仍有必要,方法见 AI 输出验收工具链。
门槛很高,按官方文档整理如下,本站未实测:
DEEPINFER_ACCELERATOR=nvidia 或 ascend 后运行 ./build.sh运行官方示例 python examples/offline_inference.py 时,会自动从 Hugging Face 下载 DeepSeek-V 4.1-Flash-1017 权重,也可以用 DEEPINFER_HF_MODEL_DIR 指向本地副本。
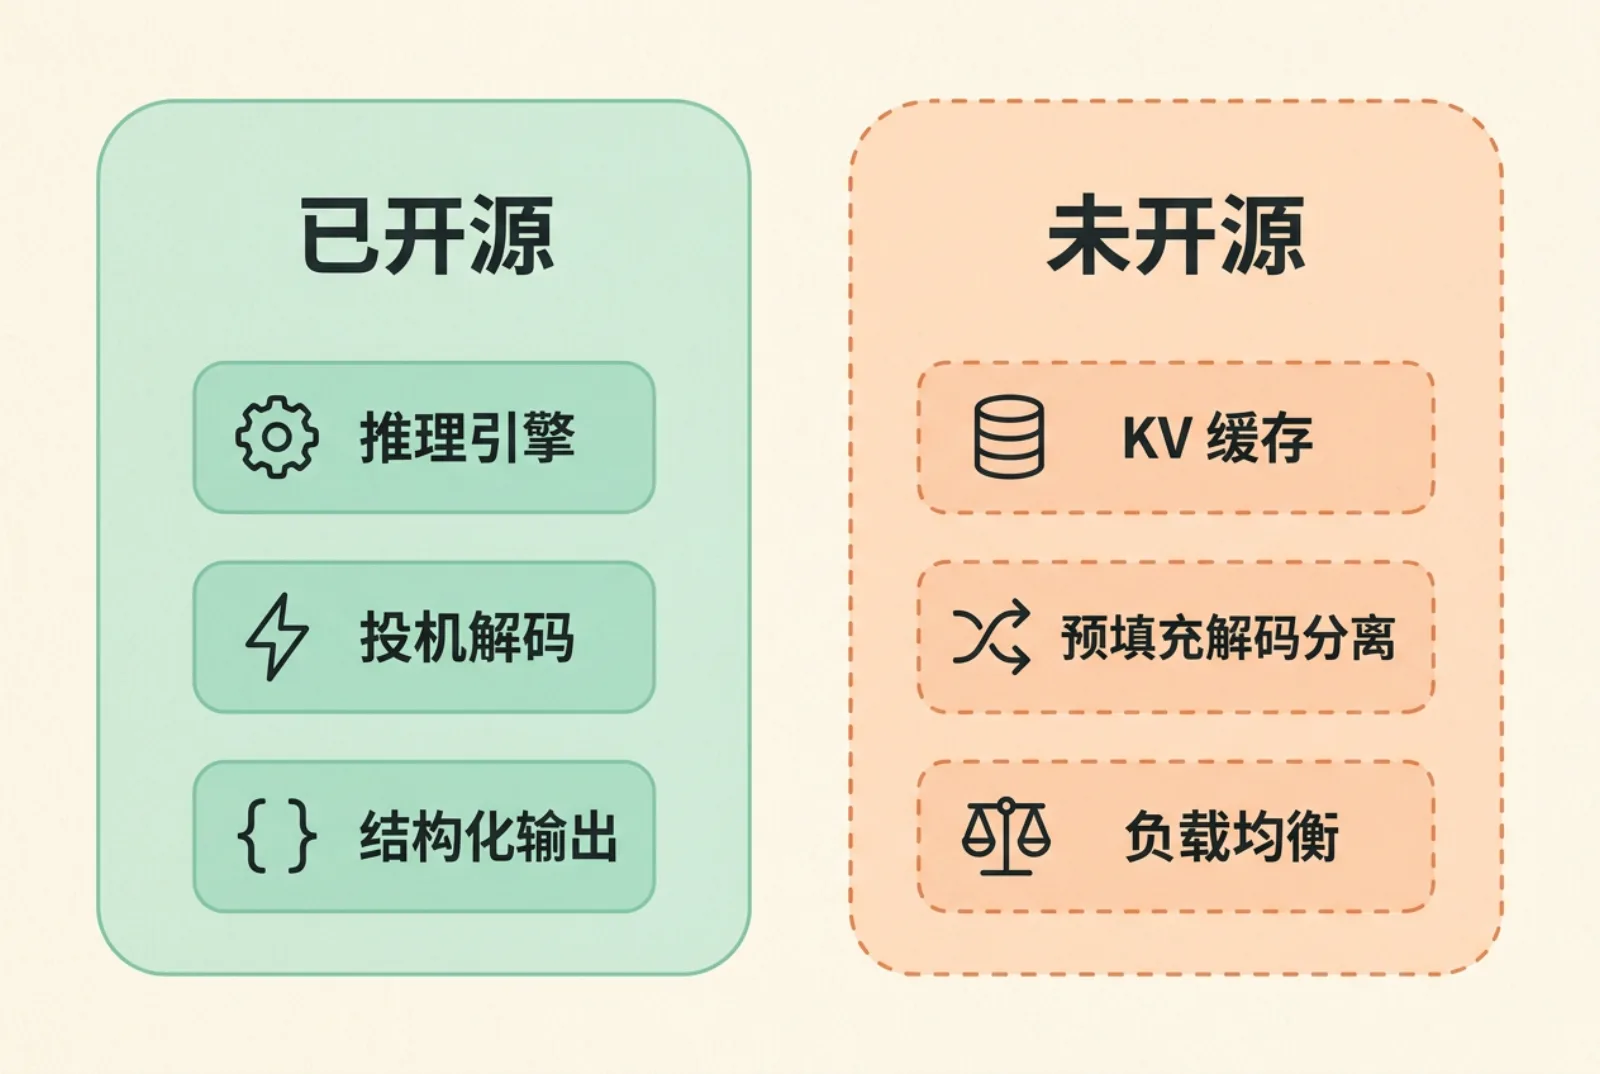
README 列出了完整线上服务还缺的三块,DeepSeek 称这部分代码与内部基础设施耦合较深,暂未完全开源:
这意味着 DeepInfer 目前是「引擎」而不是「开箱即用的服务」。仓库里也没有 OpenAI 兼容的 HTTP 服务端,社区已提交相关 PR,截至 10-26 尚未合并。官方表示后续 DeepSeek 模型的推理代码和性能优化会继续在 DeepInfer 中开源。
适合:
不适合:
想在本地小规模试 DeepSeek 系模型,可以看 Colibri 纯 C 语言 MoE 推理 这类轻量方案;需要 Agent 运行框架,见 DeepSeek Harness 开源。
不能。DeepInfer 只支持 NVIDIA SM 100(Blackwell 架构)GPU 和华为昇腾 950 NPU,并要求 CUDA 13 或 CANN 9.2。官方推荐的最小高效部署单元是预填充 64 卡加解码 64 卡,消费级显卡和上一代数据中心 GPU 都不在支持范围内。
截至 2026 年 10 月 26 日只支持 DeepSeek-V 4.1-Flash,默认加载 1017 版权重。DeepSeek 表示后续模型的推理代码会继续在 DeepInfer 中开源。
DeepInfer 最初主要基于 vLLM 构建,并参考了 SGLang 和 TensorRT-LLM。它在此基础上接入了 DeepSeek 自研的 FlashMLA、DeepGEMM、DeepEP 等内核,专门针对 V 4.1 Flash 和 DeepSeek 的大规模集群做了优化,通用性不如 vLLM。
可以。DeepInfer 使用 Apache 2.0 协议,同时开源的 deepseek-recipe 使用 MIT 协议,都允许商用。模型权重 DeepSeek-V 4.1-Flash-1017 在 Hugging Face 上同样是 MIT 协议。