
一句话结论:MiniMax 在 2026 年 10 月 19 日发布 M 3.1-Flash,并在 Hugging Face 开放权重。这是一个约 428 B 总参数、每 token 激活 23 B 的原生多模态 MoE 模型,支持 1 M 上下文和文本、图片、视频输入。按 MiniMax 开放平台定价页,API 每百万 token 输入 1 元、输出 4 元、缓存读取 0.10 元,与 DeepSeek V 4.1 Flash 空闲时段的输入、输出价相同,约为 M 3 五折后价格的一半。智源牵头的 FlagOS 社区同日发布了华为昇腾、海光、沐曦、摩尔线程、昆仑芯等 9 家厂商芯片的 W 8 A 8 部署版本。许可证沿用 M 3 的 MiniMax 社区许可证:商用要在产品中标注「Built with MiniMax M 3.1-Flash」并发邮件告知官方,年收入超 2000 万美元的产品须事先取得书面授权。
MiniMaxAI/MiniMax-M3.1-Flash 公开,非受限下载,约 252 GBMiniMax M 3.1-Flash 是 MiniMax 在 M 3(6 月发布)基础上推出的高效版模型,官方模型卡定位为面向编程、Agent 工作流、电脑操作和网络安全任务的原生多模态 MoE 模型。它总参数约 428 B,每个 token 激活约 23 B;按仓库 config.json,模型共 60 层,128 个专家每次选 4 个,上下文最长 1,048,576 token,输入支持文本、图片和视频,输出文本。
和 M 3 相比,模型卡列出三处改动:一是把前三层全注意力也换成稀疏注意力,全模型统一用 MiniMax Sparse Attention(MSA);二是做了量化感知训练,路由专家和注意力路径在训练阶段就量化,权重以 NVFP 4 专家加 MXFP 8 稠密层存储,所以 428 B 模型的仓库只有约 252 GB;三是用 DSpark 投机解码替代之前的 MTP 方案,草稿头随权重一起发布。M 3 本身的能力分析见本站 MiniMax M 3 全解析。
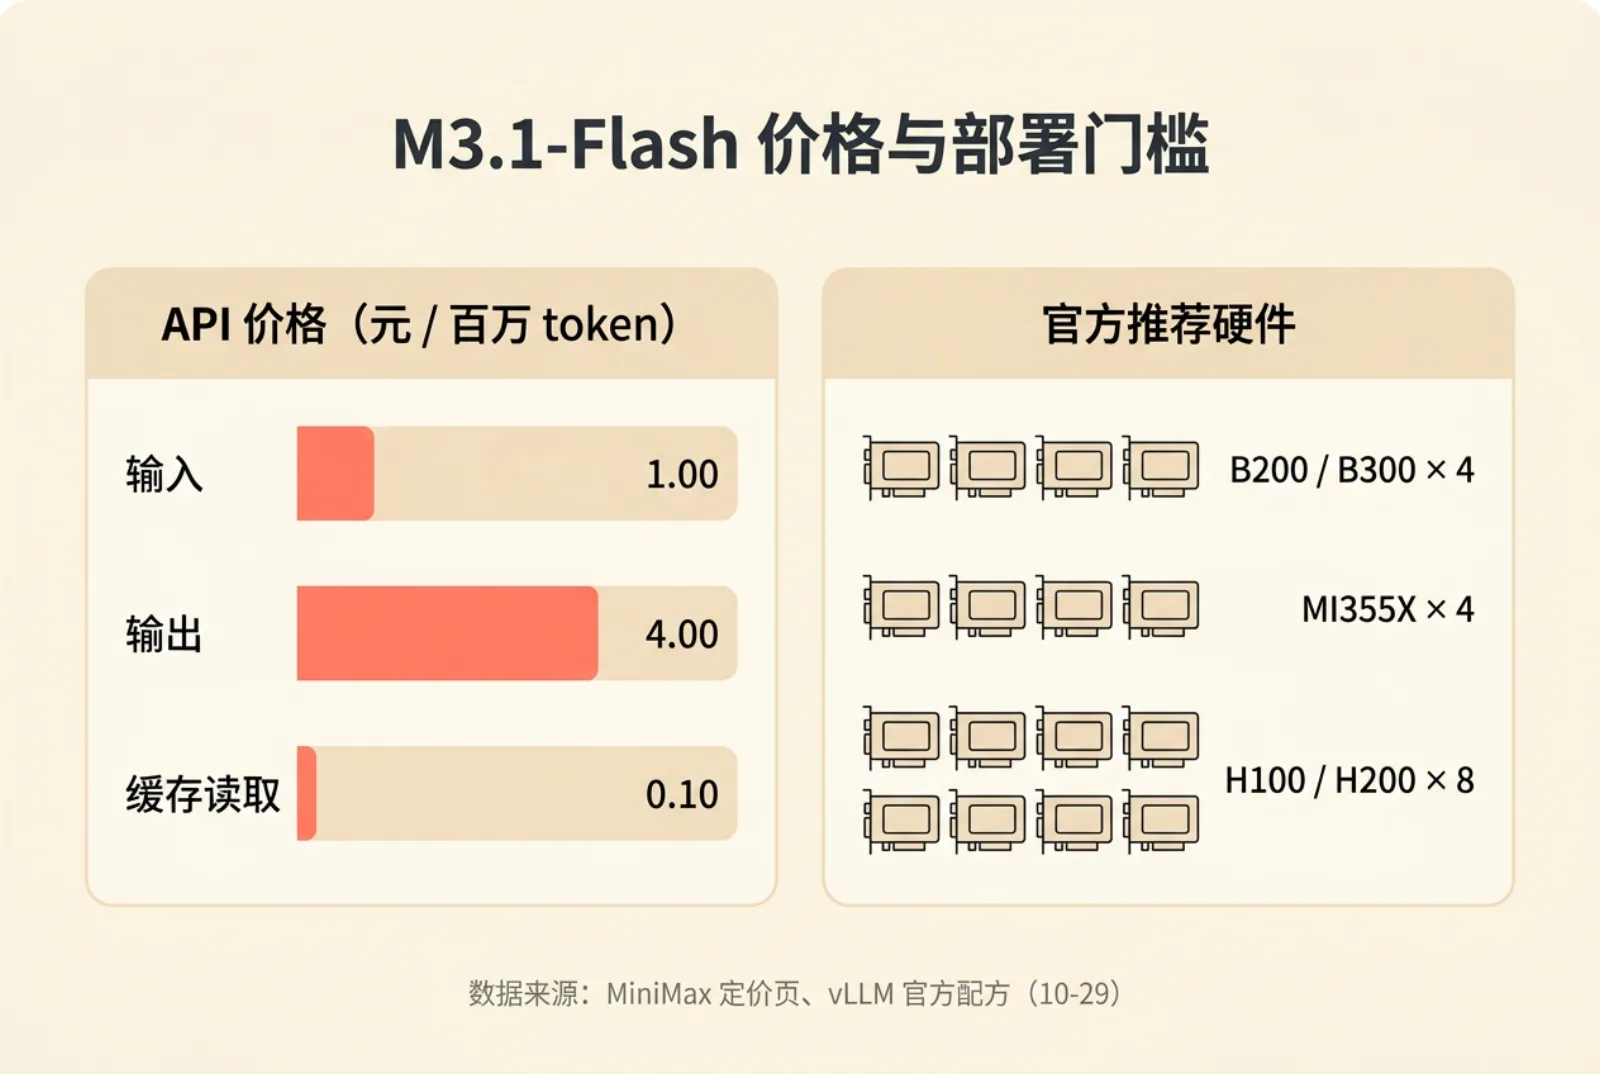
MiniMax M 3.1-Flash 的 API 价格是每百万 token 输入 1 元、输出 4 元、缓存读取 0.10 元,输入输出价与 DeepSeek V 4.1 Flash 空闲时段持平。以下为 MiniMax 开放平台定价概览页 10 月 29 日的价格,单位为每百万 token,人民币:
| 模型 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| MiniMax-M 3.1-Flash | 1.00 | 4.00 | 0.10 |
| MiniMax-M 3(≤512 K 输入,五折后) | 2.10 | 8.40 | 0.42 |
| DeepSeek V 4.1 Flash 空闲时段 | 1.00 | 4.00 | 0.02 |
| DeepSeek V 4.1 Flash 高峰时段 | 2.00 | 8.00 | 0.04 |
M 3.1-Flash 的输入、输出价约为 M 3 五折价的一半,不按上下文长度分档。和 DeepSeek V 4.1 Flash 相比,输入输出价与 DeepSeek 空闲时段持平、比高峰时段低一半,但缓存读取价是 DeepSeek 的 5 倍。所以前缀重复多的 Agent 长会话,DeepSeek 仍可能更省;工作日白天调用量大、缓存命中率不高的场景,M 3.1-Flash 更划算。
开放平台另有「优先」服务层,调用时把 service_tier 设为 priority 即可获得优先准入,按标准价的 1.5 倍计费。想按自己的 token 用量对比,可以把接口返回的 JSON 直接粘贴进本站的 大模型 API 成本估算器,用「自定义单价」填入上表价格。
MiniMax M 3.1-Flash 官方权重约 252 GB,本地部署至少需要 4 张 Blackwell 架构 GPU 或满配 8 张 H 100/H 200,个人设备跑不了。按 vLLM 官方配方,推荐配置如下:
| 平台 | 并行方式 | 说明 |
|---|---|---|
| NVIDIA Blackwell(B 200 / B 300 / GB 200 / GB 300) | 4 卡张量并行 | NVFP 4 专家直接跑在 FP 4 Tensor Core 上 |
| AMD MI 355 X | 4 卡张量并行 | 需 ROCm 7.2 以上 |
| NVIDIA Hopper(H 100 / H 200) | 满配 8 卡 | 没有 FP 4 Tensor Core,专家走 Marlin 内核 |
SGLang 和 TokenSpeed 也有官方配方;模型卡称 Transformers、KTransformers、unsloth 的适配还在进行中。推荐采样参数为 temperature=1.0、top_p=0.95,推理强度通过对话模板里的 reasoning_effort 设置,可选 low、medium、high、xhigh、max。
Hugging Face 上已经出现面向 AMD Strix Halo、DGX Spark 的社区量化版,但这些不是官方发布,模型卡也提醒「第三方量化结果可能不同」,本站未实测。
「9 家芯片首日适配」指 M 3.1-Flash 发布当天,FlagOS 社区就为 9 家厂商的 AI 芯片提供了可直接部署的 W 8 A 8 权重和容器镜像,这是本次发布对国内私有化部署最有价值的部分。FlagOS 是智源研究院联合芯片厂商、系统厂商发起的开源 AI 系统软件栈,包括 FlagGems 算子库、FlagTree 编译器等。M 3.1-Flash 发布当天,FlagOS 在 Hugging Face 和魔搭同时上线了 9 家厂商平台的 W 8 A 8 版本:平头哥真武、NVIDIA、沐曦、海光、华为昇腾、摩尔线程、天数智芯、昆仑芯、清微智能。做法是把官方 NVFP 4 权重转换、重新量化为各芯片通用的 W 8 A 8 格式,并提供容器镜像。
部署规模因芯片而异:昇腾版启动命令使用 16 张 NPU 张量并行,沐曦版使用 8 卡。FlagOS 模型卡称,32 K 输入下真武、昇腾、昆仑芯平台单位算力吞吐分别达到 NVIDIA 原生方案的 165.0%、99.5%、85.9%,这是 FlagOS 自测数据,测试口径没有完整公开。截至 10 月 29 日,9 个仓库的下载量都只有几十次,实际落地情况还需要观察。
MiniMax M 3.1-Flash 允许商用,但有两个条件:署名和通知,大收入产品还要书面授权。M 3.1-Flash 使用 MiniMax 社区许可证,条款和 M 3 相同,只是产品名换成了 M 3.1-Flash。授权本身限于非商业用途;商业使用需同时满足:
许可证对「商业使用」的定义很宽,包括收费提供的产品、商用 API,以及把微调后的模型用于任何商业目的。附录还列出禁止用途,其中包括任何军事用途。和 Muse Spark Open、GLM、Kimi 等开源许可证的对比,见本站 Muse Spark Open 许可证对比。
M 3.1-Flash 的看点不在跑分,而在「价格 + 国产芯片」这个组合。API 价格做到和 DeepSeek Flash 空闲价持平,国产大模型的低价档又多了一个选择;FlagOS 首日给 9 家芯片厂商出部署镜像,对需要在国产算力上私有化部署的团队,是目前少见的「拿来就能试」的方案。但要分清三件事:跑分是 MiniMax 自测;芯片吞吐数字是 FlagOS 自测;商用要署名和通知,不能当成 MIT 一类宽松许可证随意集成。各家价格的完整对比见 国产大模型 API 价格对比。
按 MiniMax 开放平台定价页,M 3.1-Flash 每百万 token 输入 1 元、输出 4 元、缓存读取 0.10 元,不按上下文长度分档。优先服务层按标准价的 1.5 倍计费。
M 3.1-Flash 在 M 3 的 MoE 架构上做了三处改动:全模型稀疏注意力、量化感知训练、DSpark 投机解码。总参数约 428 B,激活 23 B,API 价格约为 M 3 五折后价格的一半。
能。FlagOS 社区在发布当天提供了华为昇腾、海光、沐曦、摩尔线程、昆仑芯、天数智芯、平头哥真武、清微智能和 NVIDIA 共 9 家平台的 W 8 A 8 版本和容器镜像。昇腾版启动命令使用 16 张 NPU。
可以商用,但不是无条件的。需要在产品中标注「Built with MiniMax M 3.1-Flash」并发邮件通知 MiniMax;产品年收入超过 2000 万美元的,须事先取得书面授权。

评论 (1)
[…] MiniMax M 3.1-Flash […]
评论被关闭。