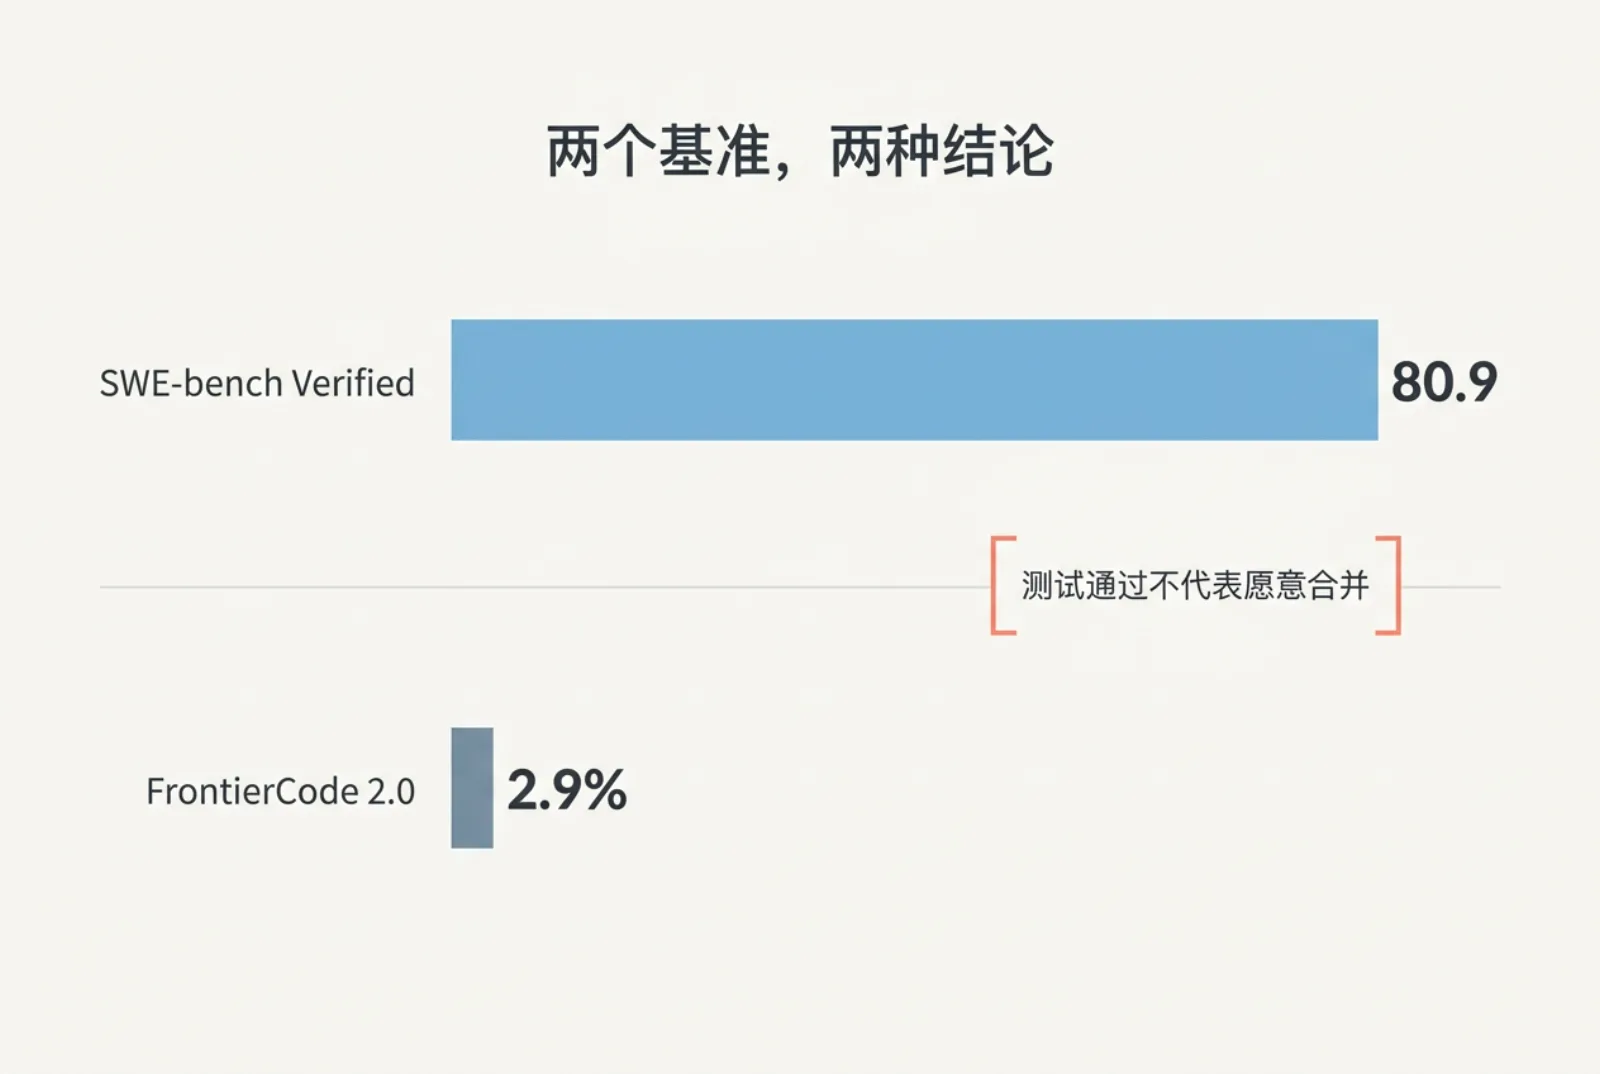
一句话结论:Reflection 在 2026 年 10 月开放了 Beam 1.0 权重,这是它第一个开放权重模型。501.3 B 总参数、23.4 B 激活的稀疏 MoE,支持 1 M 上下文,采用 Apache 2.0 许可证——允许蒸馏、微调、量化、合并,也可以直接做推理转售,不附加商业授权条款。在 SWE-bench Verified 上得 80.9、GPQA Diamond 得 90.5、AIME 2026 得 97.8,但官方自报的 BF 16 权重约 1 TB,个人设备无法部署。更值得注意的是一处数据矛盾:它在 SWE-bench 系列上表现不错,在 Cognition 的 FrontierCode 2.0 上却只有 2.9%,说明它擅长「改对单点 bug」,不擅长「产出维护者愿意合并的完整改动」。
Beam 1.0 是 Reflection 的第一个开放权重模型,定位是面向编程、推理和 Agent 工作负载的稀疏混合专家模型。按模型卡数据,它总参数 501.3 B、每 token 激活 23.4 B,共 52 层,其中前 3 层是稠密层、后 49 层是 MoE 层,专家总数 256 个。上下文长度 1 M token,词表 152 k,只支持文本输入输出,知识截止到 2026 年 6 月 30 日。注意力机制用的是门控 GQA 加滑动窗口注意力,对话模板基于改造过的 Harmony 格式。
训练侧有两个数字值得记录。预训练用了 23.8 万亿 token,官方称来源包括公开网页和商业授权的专有数据集。强化学习阶段在 10,500 张 NVIDIA GB 300 GPU 上跑了 4 周,生成超过 1 亿条 rollout——这个 RL 规模在开放权重模型里属于前排。Reflection 说 Beam 的能力主要来自预训练和 RL 两端的投入,而不是单纯堆参数。
权重提供 BF 16、FP 8、NVFP 4 三种数值格式。BF 16 主仓库约 1003 GB,拆成 201 个文件,其中最大分片 5.4 GB。
这是 Beam 1.0 相对同期开放权重模型最实际的差异点。Apache 2.0 是标准开源许可,没有使用场景限制、没有用户规模阈值、没有商业授权前置条件。模型卡在 Usage 段落里进一步明确:Reflection 不禁止蒸馏、不禁止用模型输出训练其他模型、不禁止微调、参数高效适配、量化、合并权重,也不禁止对你有权测试的系统做防御性安全研究。
把三个同期模型放在一起对比,差别就清楚了:
| 模型 | 许可证 | 能否直接做推理转售 |
|---|---|---|
| Reflection Beam 1.0 | Apache 2.0 | 可以,无需额外授权 |
| Mistral Large 4 | Mistral 生态开放权重许可证 | 不可以,MaaS 业务需单独签商业许可 |
| MiniMax M 3.1-Flash | MiniMax 社区许可证 | 需署名并通知官方,超收入阈值需书面授权 |
| DeepSeek V 4.1 Flash | Apache 2.0 | 可以 |
如果你的业务形态是把模型封装成 API 卖给别人,Apache 2.0 省掉的是法务沟通成本。这也是国内团队更愿意基于 Apache 2.0 模型做二次分发的原因。需要提醒的是,模型卡本身声明「仅供参考,不修改也不限制模型许可证」,许可证以仓库 LICENSE 文件为准。
按官方博客公布的对比表,Beam 1.0 的能力分布很不均匀——通用与推理科目强,端到端 Agent 编程弱。以下为官方数据,对比对象是同期开放权重模型:
| 基准 | Beam 1.0 | GLM 5.3 | Kimi K 3 | DeepSeek V 4.1 Flash |
|---|---|---|---|---|
| SWE-bench Verified | 80.9 | 未公布 | 未公布 | 未公布 |
| SWE-bench Pro v 2-Hard | 77.2 | 84.3 | 88.2 | 未公布 |
| Terminal Bench v 2.1 | 80.1 | 88.2 | 88.3 | 90.6 |
| AIME 2026 | 97.8 | 未公布 | 未公布 | 未公布 |
| GPQA Diamond | 90.5 | 91.7 | 93.5 | 90.9 |
| HLE(无工具) | 36.2 | 42.3 | 46.9 | 39.1 |
| MCP Atlas | 78.7 | 84.2 | 82.3 | 未公布 |
| AutomationBench public | 37.0 | 48.2 | 46.7 | 54.8 |
在 SWE-bench Verified 上 80.9 是个不错的分数,GPQA Diamond 90.5 也接近第一梯队。但 Terminal Bench v 2.1 的 80.1 比 DeepSeek V 4.1 Flash 的 90.6 低了 10 个百分点,MCP Atlas 和 AutomationBench 也落后。官方博客自己也写了「在原始能力上 Kimi K 3 这类前沿开放模型仍然领先,Beam 的优势是推理时的效率」。
这里有一处必须指出的矛盾。在 Mistral 发布 Mistral Large 4 时公布的 FrontierCode 2.0 榜单上,Beam 1.0 只得了 2.9%,而 DeepSeek V 4.1 Flash 是 19.3%、GLM-5.3 是 17.8%。FrontierCode 2.0 考察的是「仓库维护者是否愿意合并 Agent 提交的改动」,与 SWE-bench 那种「测试是否通过」是两种不同的度量。两个数字并不冲突,但它们说明同一件事:Beam 1.0 能改对单点 bug 让测试变绿,却不太能产出可被真实仓库接受的整体改动。如果你的用途是提交 PR 给人审核,这个差距比 SWE-bench 分数更重要。
官方没有给出最低硬件清单,只提供了三种数值格式的权重。按体积推算,BF 16 版本约 1003 GB,即使按 8 卡并行,每卡也需要 125 GB 以上的权重空间,再加上 1 M 上下文所需的 KV cache,实际远超单张 H 100 的 80 GB。可选路径有三条:
| 格式 | 仓库体积 | 文件数 | 适配硬件 |
|---|---|---|---|
| BF 16 | 约 1003 GB | 201 | 多卡高显存节点,如 B 200/GB 200 |
| FP 8 | 约 503 GB | 199 | Hopper 及以上 |
| NVFP 4 | 约 294 GB | 64 | Blackwell 专用 |
三个格式的仓库均已公开可下载(10 月 31 日核对,均为 HTTP 200)。NVFP 4 版本把体积压到 294 GB,按 8 卡并行每卡约 37 GB,已经能进单卡 80 GB 的显存范围——这是个人或小团队唯一有可能自托管的路径,但前提是手上有 Blackwell 架构的卡。
模型卡没有附 vLLM 或 SGLang 的启动命令,这与 Mistral Large 4 直接给出 Docker 镜像和 --tensor-parallel-size 参数的做法不同。想自托管的团队需要自己按推理框架的 MoE 支持情况配置。对个人开发者和小团队来说,更现实的选择是走 Reflection 官方 API 或第三方托管。
先看许可证再看榜单,这是同期三个模型的共同教训。Beam 1.0 的独特价值不在分数最高,而在限制最少。
如果你的业务是做推理服务转售或深度改造——比如把模型量化后塞进自己的推理集群对外提供 API,或者用它蒸馏训练自己的小模型——Beam 1.0 和 DeepSeek V 4.1 Flash 这类 Apache 2.0 模型是唯二可以直接做而不需要谈授权的大模型。Mistral Large 4 和 MiniMax M 3.1-Flash 都需要先走授权流程。
如果你的业务是自己用 Agent 干活——比如接进 Claude Code、Codex 这类 harness 做日常开发——那 Beam 1.0 不是最优解。Terminal Bench 和 AutomationBench 的差距说明它在长周期、多步骤的任务上不如 Kimi K 3.1 Pro 或 DeepSeek V 4.1 Flash。
如果你的业务是中文场景,Beam 1.0 的模型卡明确写着「predominantly for English」,152 k 词表也以英文为主,且所有公开基准都是英文任务。中文任务不建议直接套用这份成绩单。
价格方面,Beam 通过 Reflection 官方 API 提供服务,本次未取到公开的每百万 token 单价,因此不做成本估算。需要横向比价的读者可参考本站维护的国产大模型 API 价格对比,或把实际用到的 token 数填进大模型 API 成本估算器按自定义单价核算。
下载走 Hugging Face 标准流程,不需要申请访问权限。模型卡显示仓库为公开状态,截至 10 月 31 日已有 8,163 次下载。部署需按所选格式拉对应仓库,BF 16 版本建议用 huggingface-cli download 分片拉取,避免单次下载中断后重传。
# 拉取 BF16 权重(约 1003 GB)
huggingface-cli download reflection/Beam-1.0-501B-A23B --local-dir ./beam-bf16

# 显存受限时改用 FP8 或 NVFP4 版本
huggingface-cli download reflection/Beam-1.0-501B-A23B-FP8 --local-dir ./beam-fp8
需要如实说明的是,本文没有在本机或云端实际跑通 Beam 1.0 的推理——1003 GB 的权重规模超出可测试范围。以上步骤基于模型卡与 Hugging Face 的通用下载流程,未经端到端验证。若你的目标是评估效果而非自托管,建议优先走官方 API。
Beam 1.0 真的是开源吗? 是。它采用 Apache 2.0 许可证,属于标准开源许可,可以自由使用、修改、分发、商用,也可以做推理转售。这与 Mistral Large 4、MiniMax M 3.1-Flash 那种「开放权重但带附加条款」的许可证有本质区别。
Beam 1.0 能在单机跑吗? 不能。BF 16 权重约 1003 GB,即使 8 卡并行每卡也要 125 GB 以上,再算 1 M 上下文的 KV cache,实际需要 B 200/GB 200 级别硬件。个人开发者应使用官方 API。
为什么 SWE-bench 80.9 分的模型在 FrontierCode 2.0 上只有 2.9%? 两个基准测的不是同一件事。SWE-bench 看测试用例是否通过,FrontierCode 2.0 看仓库维护者是否愿意合并改动。前者可以靠局部修补得分,后者要求整体改动符合工程规范。这个落差说明 Beam 1.0 更适合辅助修 bug,不适合独立提交 PR。
Beam 1.0 支持中文吗? 模型卡明确写明主要面向英语开发,词表 152 k 以英文为主。虽然技术上能处理中文,但官方未公布任何中文基准数据,中文场景不建议直接采用其英文成绩作为选型依据。
Beam 1.0 和 Mistral Large 4 该选哪个? 如果在意许可证自由度和蒸馏、量化等改造权限,选 Beam 1.0(Apache 2.0)。如果在意 Agent 编程的 token 效率和现成的 vLLM/SGLang 部署配方,选 Mistral Large 4。两者都是 500 B 级以上的模型,个人设备都跑不动。