NVIDIA 开源 PAIR:把家里几台电脑拼成一台本地 AI 服务器

NVIDIA 免费开源 PAIR,自动把局域网多台电脑拼成本地推理池,官方实测五智能体任务从 18 分钟降到 8 分 48 秒。

Fincept Terminal 测评 2026:真正可用的开源彭博终端

Fincept Terminal 凭什么做到 Bloomberg 级别的分析能力——$0 成本、18.4 k GitHub Stars、37 个 AI Agent、实时交易。一篇深度测评。

,

Anthropic 三连击与 DeepMind 两连失:2026 年 6 月 21 日,AI 格局剧变的一天

6 月 21 日一天内:Anthropic 连发 Sonnet 4.5+Dreaming+22 万 GPU,Google DeepMind 48 小时痛失 Transformer 之父和诺奖得主。三巨头的力量天平被重新校准。

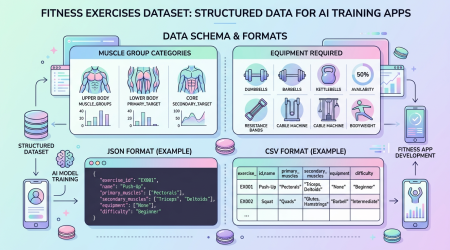
Exercises Dataset — 433 个健身动作开源数据集:为你的健身 App 和 AI 模型提供结构化数据

Exercises Dataset 提供 433 个健身动作的结构化数据,并整合 MuscleWiki 动作演示与 DAREBEE 免费训练计划,适合健身 App、AI 模型和个人训练参考。

热门

15 9 月

NCP-ArchPreview:上海 AI Lab 开源 8.9 B 潜空间模型,让 AI 在「概念」层而不是「词」层思考

一句话结论:上海人工智能实验室与上海交大 LUMIA Lab 在 9 月 14 日开源了 NCP-ArchPreview,一个约 89 亿参数的潜空间语言模型。它同时训练「预测下一个词」和「预测下一个概念」两个目标,在约 51.3% 的 token 上用更小的算力追平了 7 B 基线的效果,是目前公开的最大规模潜空间模型实验。 AI 摘要 项目是什么:NCP-ArchPreview,一个 8.9 B 参数的潜空间语言模型,联合训练 next-token 与 next-concept 两个预测目标。核心亮点:用「预测概念」替代部分「预测词」,在约一半的 token 上达到 7 B 基线的 loss,参数效率更高。谁在做:上海人工智能实验室 NCP 团队 + 上海交大 LUMIA Lab。怎么用:技术报告见 arXiv 2609.10715,权重在 Hugging Face 的。
15 9 月

Claude Opus 5.2 深夜灰度上线:跳过 5.1 直接端出,开发者实测「快、准、狠」

一句话结论:9 月 15 日凌晨,Anthropic 在 Claude Code 里悄悄开启了 Opus 5.2 的灰度测试。前端名字没变,但抓包发现后端模型 slug 已经指向 Opus 5.2——也就是说它大概率跳过了 5.1,直接端出了 5.2。开发者实测反馈集中在三个字:快、准、狠。 AI 摘要 发生了什么:Claude Code 调用 Opus 5 时,后端模型已被路由到 Opus 5.2,跳过了 5.1 版本。为什么重要:这是 Anthropic 首次用「灰度 + 路由」的方式偷偷换模型,且换上的可能是下一代主力。开发者反馈:响应速度肉眼可见提升,废话变少,长任务不再「偷懒」。事实边界:Anthropic 官方未发布公告,5.2 的完整能力边界与发布时间仍是推测。 Opus 5.2 到底是什么 事情起于 9 月 15 日凌晨,X 上的开发者先炸了锅。越来越多的人发现,自己在。
15 9 月

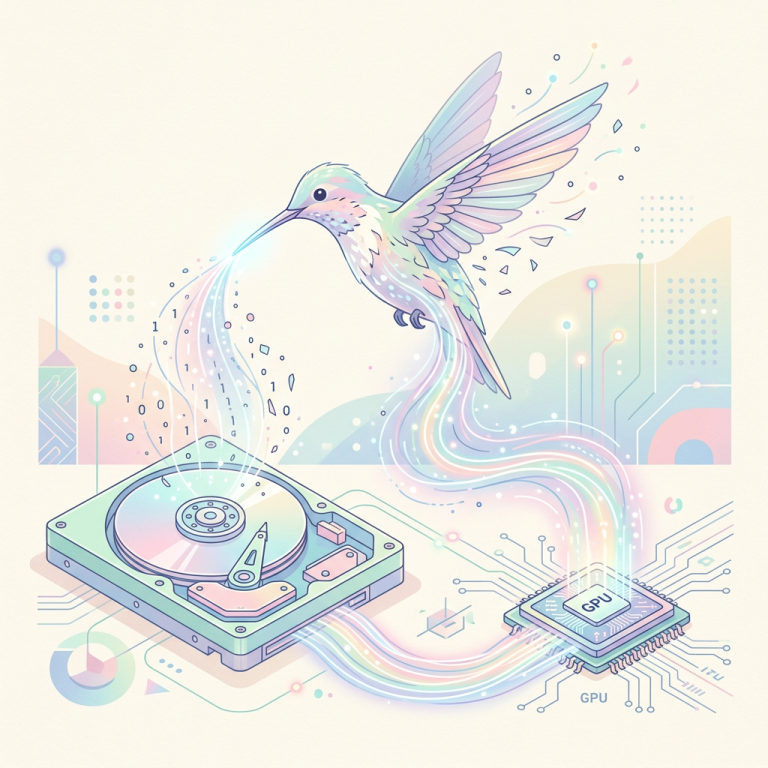
Colibri:纯 C 零依赖推理引擎,让前沿 MoE 模型跑在普通硬盘上

一句话结论:开源项目 Colibri 用纯 C 语言写了一个零依赖的 MoE 推理引擎,核心思路是不把整个模型的专家权重一次性装进显存,而是推理时从硬盘按需流式加载稀疏专家。这让前沿规模的混合专家模型第一次有可能跑在普通消费级硬件上,项目因此冲上了 GitHub Trending。 AI 摘要 项目是什么:Colibri,一个纯 C、零外部依赖的 MoE 模型推理引擎,作者 JustVugg。核心思路:推理时从磁盘流式加载稀疏 MoE 专家权重,而不是预加载整个模型到显存。价值:大幅降低前沿模型对显存和企业级硬件的依赖,推动本地化部署。适用边界:牺牲了部分速度换取显存门槛,适合实验和本地部署,不是云推理的替代。 Colibri 是什么 Colibri 是一个开源的 MoE 模型推理引擎,作者是开发者 JustVugg。它最近冲上了 GitHub Trending,原因是解决了一个很具体的问题:前沿混合专家(MoE)模型太大,普通电脑跑不动。 MoE 模型的特点是「大而稀疏」。像 DeepSeek、Kimi 这类模型,总参数动辄几百亿甚至上万亿,但每次推理只激活其中一小部分专家。问题在于,传统推理引擎为了速度,会把全部专家权重都预加载进显存——哪怕大部分专家这次根本用不到。这就把门槛拉到了需要企业级显卡集群的高度。 Colibri 换了个思路。它不预加载,而是推理到哪个专家,就从硬盘把哪个专家的权重流式读进来。这样显存里只放当前需要的那部分,门槛一下子就降下来了。 它凭什么跑得动前沿 MoE 关键在两点:纯 C,和零依赖。 纯 C 意味着没有 Python 运行时、没有深度学习框架的层层封装,推理路径短,内存开销可控。零依赖意味着它不依赖 CUDA 之外的任何重型库,部署简单。 流式加载是这个设计的核心。MoE 模型每一层有几十个专家,一次推理只会命中其中几个。Colibri 把这个「命中」和「从磁盘读取」绑定在一起,用 I/O 换显存。代价是速度会慢一些——磁盘读写总比显存慢——但换来的是一台普通电脑也能跑前沿模型的可能。 这跟
14 9 月

Anthropic CEO 亲自喊减速:AI 该给「安全」踩一脚刹车了,Altman 和 Musk 都点头

一句话结论:Anthropic CEO Dario Amodei 9 月 12 日发表长文,提出「Pacing the Frontier」三步减速计划,并单方面承诺让外部评估员进驻公司内部。几小时内,Altman 和 Musk 都公开表示认同——这是 AI 行业第一次由头部公司 CEO 主动要求给能力增长降速。 AI 摘要 发生了什么:Amodei 发文《We Must Pace the Frontier》,提出三步计划给前沿 AI 能力增长「配速」。核心变化:Anthropic 单方面承诺第一步——让第三方评估员以员工级权限进驻,可独立发布发现。影响对象:所有前沿 AI 公司、依赖 AI 安全评估的企业、关注 AI 治理的人。下一步观察:OpenAI 是否兑现「我们也这么做」,以及美国反垄断豁免能否落地。 发生了什么 9 月 12 日,Anthropic CEO Dario Amodei 在他个人网站上发了一篇约。
14 9 月

NVIDIA 开源 IMO 金牌完整配方:Nemotron 数学推理全栈放出,权重、数据、200 道新题一个不少

一句话结论:NVIDIA 把一套在 2026 国际数学奥林匹克拿到金牌(30/42 分,超出金牌线 1 分)的数学推理系统完整开源——两个专家模型权重、训练数据、推理代码、提交的证明,还有一个 200 道全新奥赛题的 benchmark,全部可复现。 AI 摘要 项目用途:一套纯自然语言、无外部工具的数学奥林匹克证明生成流水线,全栈开源。适合人群:研究数学推理、RL 训练、test-time compute 的团队和个人。上手门槛:很高,两个专家 checkpoint 各 1.12 TB,官方建议至少 8 张 B 200。智盒结论:这可能是目前最诚实的「金牌级开源复现」,但算力门槛挡住了绝大多数人,价值在方法论和 benchmark 而非直接可用。 项目信息 项目名:NVIDIA Nemotron IMO 2026(arXiv:2609.10712)GitHub URL:https://github.com/NVIDIA-NeMo/Skills/tree/main/recipes/nemotron-imo-ttsLicense:模型 OpenMDW 1.1;数据与 benchmark CC BY 4.0 它解决什么问题 数学一直是检验 AI 推理能力的硬指标,但奥林匹克级别的结果往往有个问题:只公布分数,不公布过程。你看到一个「IMO 金牌」,却没法知道它是怎么做到的,也没法复现。 NVIDIA 这次反着来。它把拿到 IMO 2026 金牌(30/42...
13 9 月

OpenAI Agents API 开放公测:把 Codex 的「大脑」拆出来,一行调用起一个 Agent

一句话结论:OpenAI 把支撑 Codex 和 ChatGPT for Work 的 harness 打包成 Agents API 开放公测,开发者不用自己搭多智能体编排、上下文压缩、沙箱环境这套脏活,一个 API 调用就能起一个能跑几天的 Agent。 AI 摘要 发生了什么:OpenAI 9 月 10 日推出 Agents API(public beta),把 Codex 背后的 harness 和基础设施开放给所有开发者。核心变化:Agent、Environment、Session 三个抽象,让开发者专注在工具和知识上,OpenAI 托管剩下的编排和运维。影响对象:所有在自建 Agent 平台的开发者、想做长任务的团队。下一步观察:正式 GA 的时间,以及自托管沙箱生态的成熟度。 发生了什么 OpenAI 在 9 月 10 日宣布 Agents...
13 9 月

nano-kpu:Kimi K 3 用 48 小时给自己设计了一颗推理芯片,这是开源芯片的「DeepSeek 时刻」吗

一句话结论:Moonshot AI 开源了 nano-kpu——一颗完全由 Kimi K 3 设计、用开源 EDA 工具跑通全流程的推理芯片 RTL,48 小时完成设计,4 平方毫米、100 MHz、模拟 8700 tokens/s。但它明确声明是「能力演示」,不是产品。 AI 摘要 项目用途:Kimi K 3 自主设计的推理芯片 RTL 源码,含功能仿真和时序/面积综合流程。适合人群:关注 AI 自主工程、芯片设计、国产大模型的人。上手门槛:高,需要 Verilator 5 + yosys 工具链。智盒结论:作为「AI 能不能做芯片设计」的标尺很有价值,作为实际芯片还差得远,别把演示当产品。 项目信息 项目名:MoonshotAI/nano-kpuGitHub URL:https://github.com/MoonshotAI/nano-kpuLicense:Apache-2.0 Star / Fork:47 / 5(截至 2026-09,早期) 它解决什么问题 严格说,nano-kpu 不解决任何生产问题。它回答的是一个更根本的问题:一个 AI 模型,能不能在没有人干预的情况下,独立完成一颗芯片的设计全流程。 答案在 Moonshot AI 的开源仓库里。nano-kpu 是一颗。